本ガイドは公式の基準を踏まえ、その上に補足を加えています。Seedance 2.0 シリーズ(2.0、2.0 Fast、2.0 Mini)に使えます。プロンプトが整って初めて、Seedance の力が出ます。
基本の式
Seedance 2.0 シリーズのモデルは、動画、画像、音声などのマルチモーダル素材を同時に参照できます。キャラクターの外見、アクションの効果、ビジュアルスタイル、ナレーションの音色といった特徴を正確に固定でき、プロンプトを書く敷居を大きく下げます。これを踏まえ、単純な基本の式でモデルを導き、マルチモーダル素材の特徴を使って、特定の要件を満たす動画をすばやく生成します。
参照に基づく動画生成は、三種類のタスクに分かれます。オムニ参照(omni reference)、動画の編集、動画の延長です。タスクの種類に合わせて、基本のプロンプト式を選びます。三種類は組み合わせても使えます。
オムニ参照(omni reference)
素材から一部の要素(主体、スタイル、場面、効果音など)を取り出し、まったく新しい動画を生成します。
当てはまる場面: 動作の移植、主体の再利用、雰囲気の参照、および同様の仕事。
推奨パターン:
- 画像参照:
@Image1の主体を参照して生成する… - 動画参照:
@Video1の動きを参照して生成する… - 音声参照:
@Audio1の音色を参照して生成する…
このスタジオでは、オムニ参照(omni reference)が マルチ参照 です。プロンプト欄で @ を入力し、ファイルを選びます。挿入されるのは @Image1、@Video1、@Audio1 で、その種類の中でのアップロード順に番号が付きます。各サムネイルには、そのトークンが表示されます。ファイルを外すと、その種類に残ったトークンは番号が振り直されます。上のパターンでは、どの要素を取るのかを、やはり書く必要があります。トークンだけでは、顔なのか、動きなのか、スタイルなのか、音色なのかを、モデルは判断できません。
動画を編集する
元の動画を基に、部分的な修正、または全体的な修正をします。言及していない部分は、既定ではそのまま残ります。
当てはまる場面: 局所的な差し替え、主体の削除、属性の変更、および同様の仕事。
推奨パターン:
- 要素を追加:
@Video1と、新しい要素と、それがどこにあるかを、はっきり書く。 - 要素を変更:
@Video1を厳密に編集し、その中の一つの要素を別のものに変える。 - 要素を削除: 削除が必要な要素を指定する。変更せずに残すべき要素は、性能を良くするために、プロンプトの中で強調する。
動画を延長する
時間の次元に沿って元の動画を続けます。映像と音声のスタイル、主体、語りは、一致したままであることを求めます。
当てはまる場面: 筋の続き、動作の延長、クリップの補完、および同様の仕事。
推奨パターン:
- 動画を延長:
@Video1を前方向または後方向に延長して生成する… - トラックの補完:
@Video1とそこで起きること、続いて@Video2とその次に起きること。
編集と延長のタスクでは、動画を直接指します。"strictly edit @Video1"、"extend @Video1 forward"。これらのタスクに "reference @Video1" と書かないでください。"Reference" はオムニ参照(omni reference)のパターンであり、モデルは編集や延長を、まったく新しいクリップだと読み違えることがあります。
画像→動画 は別のモードです。開始フレームと最終フレームは、一回の生成のなかで参照ファイルと混ぜることができません。開始フレームが冒頭であり、アスペクト比はその画像に従います。終わりのフレームも固定しなければならないときは 最終フレームを追加 をオンにし、二つのフレームのあいだで起きることだけを書きます。生成する前に 最終フレームを出力 をオンにします。クリップの準備ができたら、続きを生成 はその最終フレームを次のクリップの開始フレームとして使うので、つなぎ目は一枚の絵に固定されます。これが、このスタジオでフレームを固定して続ける方法です。ソースが マルチ参照 の中の動画であるときは、公式の延長の式が引き続き当てはまります。
組み合わせたタスク
上の三種類のタスクは、組み合わせても使えます。
当てはまる場面: 一方の素材を参照し、もう一方の素材を編集する。
推奨する文の型: @Video1 の [参照する次元] を参照し、@Video2 を厳密に編集する、[具体的な編集]。
[参照する次元] は、最初のファイルから取る一つのもの、たとえばカメラの動き、エフェクト、音色です。[具体的な編集] は、二つ目のファイルに入れたい唯一の変更です。編集のなかで名前を挙げなかったものは、すべてそのまま残ります。
応用の式
Seedance 2.0 は、本質的にマルチモーダルな AI 監督です。テキストのプロンプト、画像、動画、音声を同時に読み、内部で二つの次元、フレームの中にあるものを扱う空間レイヤー(spatial layer)と、時間とともに物事がどう変わるかを扱う時間レイヤー(temporal layer)に分解して、映像を理解し、生成します。
良いプロンプトは、単なるコピー風の描写ではなく、工学的な指示です。誰が、どの場面で、何の動作をし、カメラがどう動き、出来事がどの時間順で起きるかが、それぞれ空間レイヤー(spatial layer)と時間レイヤー(temporal layer)へ渡されます。
1. 主体を定義する
実際に参照する素材では、一枚の画像に複数の主体が含まれることがよくあります。素材のなかの特定の対象を正確に参照するには、主体をはっきり定義しなければなりません。主体は人物、小道具、場面などです。
基本の定義
中核的な特徴の要件:明確で安定した静的な特徴を 2〜3 個(服装、髪型、外見、カテゴリなど)使って主体を描写し、一意に識別できるようにします。
例:
@Image1の、赤いドレスと麦わら帽子を身につけた女性を、主体 1 として定義する。@Image1の、赤いドレスと麦わら帽子を身につけた女性を、Zhang Hong として定義する。
複数の素材にまたがる単一の主体
複数の素材のなかの対象が同じ主体を指すときは、一貫して結び付けます。@Image1 の顔と @Image2 の全身写真は同一人物だと書いてください。
複数主体の場面
動画に複数の主体が現れるときは、別々に定義し、ラベルで区別します。ラベルは一意で安定していなければならず、その後の描写でも対応するラベルを一貫して使い、参照の曖昧さを避けます。
例:@Video1 の背の高い男性を警察官として定義し、もう一人の背の低い男性を泥棒として定義する。場面は、人で混み合った昼の市場である。明るい陽光、多くの果物の屋台、密な歩行者の往来があり、活気のある街の市場の雰囲気を作っている。泥棒は混んだ市場を慌てて前方へ走り、警察官は全速で直後から追う。二人は屋台のあいだをすばやく縫うように進む。手持ちカメラが急速に前方を追い、わずかに現実的なカメラの揺れがあり、緊迫した追跡の雰囲気を作る。
主体が関わるたびに、省略を避けるため、明示的に指さなければなりません。二つの使い方があります。
- 主体を定義していない単純な場面では、主体に触れるたびに @ を使い、主体と素材の結び付きを強調します。例:Zhang San
@Image1。 - 主体をあらかじめ定義した場面では、主体に触れるたびに同じラベルを使います。
@Video1の背の高い男性を警察官、背の低い男性を泥棒と定義したあと、後の文では警察官と泥棒と言い、"the tall one" や "the other man" とは言いません。
素材ライブラリの id を使うときも、主体を指すには @Image1 または @Video1 が必要です。モデルは素材 id を参照内容と直接結び付けられないので、ファイルのトークンの代わりに素材 id を使ってはなりません。
描写はできるだけ簡潔にし、冗長さを避け、同じ主体に矛盾する特徴のような意味の衝突を避けます。空間関係はまず参照画像で表し、複雑なテキスト描写を減らします。
人物なら、ヘッドショットと全身写真で足ります。ここではマルチビュー(multi-view)のキャラクター画像は推奨しません。ターンアラウンドシート(three-view)は、IDドリフト(ID drift)のよくある原因だからです。
2. ショットの順序
モデル内部のモデル化は、空間と時間を分離します。したがって、複雑な動画に理想的なプロンプトの形は、タイムラインに基づく絵コンテです。動画をいくつかのショットに分け、出来事が起きる順に、各ショットを動的に描写します。誰が + どこで + 何をして + カメラがどう動くか。
ショットの順を使います。動画の各区間について、単純な Shot 1 / Shot 2 / Shot 3 の絵コンテを書き、それらを一つの完全なプロンプトにまとめます。
否定例:"A man runs nervously down the street, and the scene feels very cinematic."
肯定例:
- Shot 1:路地の横からのショット。男性がゆっくり走り始め、呼吸が速くなる感じがある。
- Shot 2:男性が果物の屋台を倒す。カメラがすばやく揺れ、男性の怯えた顔のクロースアップを出す。
- Shot 3:男性が低い壁を乗り越えて消える。カメラはゆっくり引き、空っぽの通りで静止する。
Shot 1、Shot 2、Shot 3 のような識別子を使い、出来事が起きる順に、主要なものを先、副次的なものを後にして、内容を整理します。各区間の長さに厳密な制限を課さないでください。筋に基づいて、モデルが自然に間を生成できるようにすることを優先します。0〜3 秒のような精密なタイミングへのモデルの対応は不安定で、長さを無理に限ると、生成結果が異常になることがあります。
各ショットを、この順で整理します。
- カメラの動き、またはショットのつなぎ方。たとえば "slowly push in from a wide shot"、"fixed camera position"、"cut to…"。
- 主体の動作と表情。 中心となる人物や物体の、主要な動作と表情の変化を書く。
- 位置、または空間の変化。 主体がいる場面、位置、空間関係を説明する。
- 音声情報。 そのショットに対応する効果音、声、背景音楽を書く。
3. 動作描写の要件
身体の動きの精密化 + 程度の数量化。 動作は、手、脚、頭、肩、背中などの身体部位まで具体的にし、同時に範囲、速さ、力の描写を補います。例:手をゆっくり上げる、頭をすばやく向ける、地面を強く蹴って押し出す、頭をわずかに下げる。
遅く、穏やかで、連続した小さな動きを優先する。 遅く、穏やかで、一貫した微妙な動きを優先し、全力疾走、大きな跳躍、激しい転がりのような、爆発的でダイナミクスの大きい動作は避けるようにします。例:ゆっくり歩く、手をやさしく上げる、頭をわずかに下げる、動作に乗って自然に座る。
動作と動作のあいだの遷移を補う。 前後の動作のあいだの慣性と連続性を指定し、画面上の動きがまとまりよく自然になるようにします。例:振り向く慣性を使って自然に手を上げる、静止から、手を上げる動きへ自然に移る。
感情の具体的な外面化。 具体的な身体の細部で感情を表し、"very sad" や "extremely angry." のような抽象的な言葉を置き換えます。
| 抽象的な感情 | 動作と細部への外面化 |
|---|---|
| 悲しみ | 頭を下げる、肩がわずかに震える、目が赤くなる、指が無意識に服の裾を握る、涙が目に溜まるが落ちない |
| 喜び | 口角が抑えられずに上がる、眉と目が緩む、足取りが軽くなる、無意識に鼻歌を歌う、その場でくるりと回るのをこらえられない |
| 緊張/不安 | 時計を頻繁に確認する、指が絶えず卓上を叩く、呼吸が速い、目がそらされる、無意識に爪を噛む |
| 怒り | 両手の拳を握る、顎の線が張る、胸が激しく上下する、目が刃のように鋭い、歯を食いしばって言葉を絞り出す |
| 安堵 | 長い息を吐く、張っていた肩が完全に緩む、久しぶりのかすかな笑みが顔に現れる、遠くを見上げる |
4. カメラの動きのプロンプト
モデルはカメラの動きの用語を強く理解するので、標準的なカメラ用語を直接使えます。たとえば "medium shot, close-up, wide shot, slow push-in, smooth lateral tracking, fixed shot." です。
一つのショットでは、カメラの動きを一種類だけ指定するようにします。押し、引き、パン、移動を同時に要求しないでください。画像の不安定さが増します。
5. 画質、スタイル、制約の言葉
画質、スタイル、制約の言葉は、動画生成の結果を制御する鍵です。モデルに創作の境界を定め、画質と芸術的な色調を統一し、視覚的な欠陥や無作為なずれを避けられます。安定して要件に沿った最終出力を確保するために、必要な設定です。
- 画質。 画像の鮮明さ、細部の質感、照明の質を定め、最終動画の基礎的な画質を上げます。例:HD、豊かな細部、映画的な質感、自然な色、柔らかい照明。
- スタイル。 全体の画風と視覚的な色調を設定し、画像の芸術的な雰囲気を統一します。例:サイバーパンクの冷たい青紫の色調、レトロフィルム、さわやかな和風。
- 制約の言葉。 制約の言葉は非常に重要です。視覚的な欠陥、変形、破綻、不自然な要素を効果的に避け、生成の境界と安定性を制約します。
よく使う制約語のテンプレート:
- 字幕の生成を避ける: "keep it subtitle-free"、"avoid generating any text or subtitles"。
- ロゴの生成を避ける: "do not generate a logo"。
- 透かしの生成を避ける: "do not generate a watermark"。
6. 事例
次の二つの例は、上の応用の式の使い方を示します。セリフは {} のなかに残します。これは、特殊文字の基準にある対話の印です。
例 1:寮の感情ショートドラマ(対話が中心)
素材の準備:
@Image1:女性主人公の半身写真@Image2:寮の場面の参照画像@Video1:室内の対話向けのカメラの動きの参照(ミディアムショットのドリーイン/アウト、またはわずかなパン)@Audio1:室内の環境音、または軽い音楽
Use the girl in @Image1 as the main character, use @Image2 as the dormitory scene style reference, and refer to the camera movement in @Video1.

Shot 1: At dusk, girl @Image1 walks briskly to the dormitory entrance @Image2. The camera follows steadily in a medium shot. Warm yellow sunlight spills into the hallway from the window. She pauses at the doorway, takes a deep breath, and looks slightly nervous.

Shot 2: Girl @Image1 pushes the door open and enters the dormitory. The camera cuts to an indoor medium shot. Her roommates look up at her while organizing their books. One of them smiles and asks {How did the exam go? Did you pass?}. The camera slowly cuts between half-body close-ups of several people.

Shot 3: Girl @Image1 first lowers her head with a dejected expression. The camera gives her a close-up. Then she raises her head, unable to hold back a smile, laughs out loud, and says {I was kidding}. Her roommates start chasing and play-fighting with her. The camera slowly pulls back and freezes on a wide shot of the dormitory filled with laughter.

The entire video should have a high-definition cinematic documentary style, with warm tones and soft lighting. The character's face remains stable without deformation; movements are natural and smooth, with no stutter or flicker. The ambient sound blends naturally with @Audio1.
例 2:古風な崖の対峙(アクション/雰囲気が中心)
素材の準備:
@Image1:赤を着た女性主人公@Image2:黒を着た刺客(対戦相手)@Image3:崖と竹林の場面画像@Video1:武術の対峙向けのカメラの動きの参照@Audio1:緊密な太鼓のビート、または戦いの効果音
Use the woman in red from @Image1 as the female lead, use the woman in black from @Image2 as the opponent, use the cliff and bamboo forest environment in @Image3 as the scene reference, refer to the overall camera movement and action rhythm in @Video1, and synchronize the background sound effects with @Audio1.

Shot 1: At dusk, the camera slowly pushes in from a side medium shot of woman in red @Image1. She stands at the edge of the cliff and lifts a wine flask to drink. Her sleeves and robe hem sway gently in the mountain wind. The camera circles halfway around her, moving from the front to her back. In the distance, a figure in black is faintly visible in the bamboo forest.

Shot 2: The camera zooms and fades into a long shot. From a drone perspective, it overlooks the entire cliff and bamboo forest. The two characters stand at opposite ends of the cliff. The mountain wind lifts their robe hems and dust, and the rhythm slightly accelerates with the drum beats.

Shot 3: The camera cuts back to a ground-level close shot. The two slowly draw their swords and face off. Woman in red @Image1 shifts from a careless expression to a cold gaze. Woman in black @Image2 looks determined, and the sword tip trembles slightly. The camera steadily follows the two as they circle each other, finally freezing on a close-up of the instant before the two swords meet.

The overall visual style should feel like a cinematic wuxia world in misty rain, with cool tones, low saturation, a film-grain texture, and rich light-and-shadow layers. The characters' faces and body proportions remain stable without deformation. Movements are continuous and natural, not stiff, with no clipping or stutter.
その他のヒント
テキストの生成
Seedance 2.0 シリーズのモデルは、一般的なテキストの生成に対応しています。モデルは文脈に基づいて、適切なスタイルと色を自動で合わせられます。プロンプトのなかで、テキストの色、スタイル、現れ方、現れるタイミング、現れる位置を指定することにも対応しています。書くときは一般的な文字を優先し、まれな文字と特殊記号を避け、最良の表示を確保します。現在、広告のスローガン、字幕、吹き出しなどの場面に対応しています。事例は最後の節にあります。
スローガンのプロンプトテンプレート:[テキスト内容] + [タイミング] + [配置] + [登場/現れ方]、[視覚属性(色、フォントのスタイル)]。
Seedance 2.0 は、文脈に基づいて適切なテキストスタイルを合わせられます。テキストの表示に厳密な要件がある場合は、複数画像参照の下にあるロゴの例を使います。
字幕のプロンプトテンプレート:テキストとともに、字幕を下中央に表示する。字幕は、音声のリズムと間に完全に同期していなければなりません。
動画の延長と、分割してつなぐこと
- 連続する長回し(動画の延長): 一つの場面のなかの対話、たとえば長い会話、感情の進行、一本の道に沿った移動に向きます。没入感のある、まとまりのよいワンショットの効果を得ます。
- 場面/動作の転換点(分割してつなぐ): 筋の転換、または追跡、戦い、モンタージュのような、複雑でテンポの速いアクション場面に向きます。独立したクリップを生成してから編集でつなぎ、リズムと視覚的なインパクトを確保します。
実際の制作では、二つの方法を組み合わせるのが普通です。たとえば、まず延長でまとまりのある会話を生成し、それから空ショットやつなぎのクリップを挟み、没入感とリズムの変化のバランスを取ります。
素材の構成戦略
素材は通常、四つの機能上の役割に分かれます。
- キャラクターの固定: キャラクターの外見を固定する。
- 場面のトーン設定: 環境とスタイルを固定する。
- カメラの動きの参照: ショットの言語と動作のリズムを固定する。
- リズムのある雰囲気: 音声で感情と音色を制御する。
推奨する構成は、合計 4〜5 個の素材です。キャラクター画像 1〜2 枚(顔のクロースアップ/全身)+ 場面画像 1 枚 + カメラの動きの動画 1 本 + 音声クリップ 1 つ。
素材の上限をすべて使い切ることは推奨しません。素材が多すぎると、モデルが特徴の優先順位を判断しにくくなり、スタイルの衝突、主体の識別のぼやけ、期待からずれた生成結果を起こしやすくなります。
Seedance 2.0 ファミリーでは、音声をテキストだけと組にできません。音声と一緒に、画像か動画を少なくとも一つ加えます。
注意すること
言語の基準
対話の言語は一致していなければならず、固有名詞を除いて、中国語と英語の混在は避けるべきです。
特殊文字の基準
プロンプトのなかで記号を適切に使うと、モデルが異なる種類の情報を正確に理解するのに役立ちます。
| 情報の種類 | 記号 | 例 |
|---|---|---|
| 音楽 | () | (fast-paced rock music is playing in the background) |
| 効果音 | 公式の表は、この記号欄を空にしています。音は言葉で、ショットの音声の行に書いてください。 | |
| 対話 | {} | {Hello, world}。対話が中国語でも英語でもない、あまり一般的でない言語の場合は、言語を示さなければなりません。例:日本語で {こんにちは} と言う。 |
| 字幕 | 【】 | 【Chapter One: Departure】 |
よくある質問
顔の参照が不正確
典型的な症状。 生成されたキャラクターの外見が参照画像と一致しない。または動画の途中で顔の差し替わり(IDドリフト、ID drift)が起き、動画のなかのキャラクターが有名人に似て、審査でブロックされる。
根本原因。 顔の参照画像の効きが不十分である。
- 混在した参照画像。 顔の参照、全身または半身のポーズ参照、衣装参照、細部参照、その他の参照要素を含む、一枚にまとめた画像をモデルに渡している。
- 顔の比率が小さすぎる。 混在した参照画像のなかで、顔の領域が画像全体に占める割合が小さすぎる。顔の特徴を抽出するとき、モデルはそれらに十分な重みを割り当てず、背景や他の要素に乱されやすい。
解決。 顔参照の独立性と重みを強める。
- 顔のクロースアップ画像を用意する。元の全身写真に加え、キャラクターの頭だけを含む顔のクロースアップを別に用意する。ヘッドショットであり、顔だけを残す。無表情が最良です。肩、首、背景などの邪魔になる要素を最小限にします。
- プロンプトのなかで主体をはっきり定義する。顔の特徴はヘッドショットを参照し、メイクとスタイリングは全身写真を参照する。
- 重要な素材を先に置く。精密な参照が必要な素材ほど、プロンプトのなかで早く置く。
キャラクター参照では、ヘッドショットと全身写真で足ります。マルチビュー(multi-view)のキャラクター画像は推奨しません。マルチビューの素材は同じキャラクターの異なる角度を含み、モデルがそれらを複数の異なる主体だと識別しやすく、かえって IDドリフト(ID drift)を悪化させます。
前:動画のなかのキャラクターが途中で顔を変え、有名人に似る。後:顔は最初から最後まで参照画像と一致したまま。
直し方
Prepare a close-up face image containing only the character's head, in addition to the full-body photo. No expression is best. Minimize shoulders, neck, and background. In the prompt: facial features reference the headshot, makeup and styling reference the full-body photo. Place the asset that needs precise reference earlier. A headshot plus a full-body photo is sufficient. Multi-view character images are not recommended: the model may identify them as multiple different subjects, which worsens ID drift.
動画に予期しない字幕が出る
典型的な症状。 プロンプトは字幕を求めていないのに、生成された動画に字幕が含まれる。
解決。 字幕の生成を 100% 直接避けることはできません。確率を下げ、成功率を上げることしかできません。
- プロンプトに、明示的な制約の指示を加える。"Keep it subtitle-free" と "Avoid generating any text or subtitles"。
- 参照画像や動画に、不可欠ではないテキストが含まれる場合は、画像編集または動画編集でまずそのテキストを取り除き、テキストのない素材を入力として使う。
- 用途が許すなら、横長サイズの動画生成を優先する。横長で字幕が生成される確率は、縦長より明らかに低い。あとから編集ソフトで縦長にクロップできます。
動画にロゴまたは透かしが出る
典型的な症状。 プロンプトは透かしに関する内容に触れていないのに、生成された動画に、別の動画プラットフォームのロゴまたは透かしが含まれる。
解決。 プロンプトに、明示的な制約の指示を加える。"Do not generate watermarks" と "Do not generate Logos"。
スタイルのドリフト
典型的な症状。 2D または 3D のアニメスタイルを生成したいのに、入力した参照画像のスタイルが比較的写実的で、プロンプトが動画のスタイルを強調していない。その結果、生成された動画が実写の写実スタイルへ漂うことがある。
解決。 プロンプトに、明示的なスタイル制約の言葉を加える。たとえば "2D Japanese anime style" や "3D Chinese-style comic"。より精密なスタイル制御が必要なら、動画を生成する前に、参照画像をまず目標のスタイルへ変換する。
前:仙侠(xianxia)スタイルが実写スタイルへ漂う。後:3D の中国アニメーション CG の仙侠(xianxia)スタイルを保つ。
プロンプト
Add an explicit style constraint, such as "2D Japanese anime style" or "3D Chinese-style comic". The after example maintains the 3D Chinese animation CG xianxia style. If more precise style control is required, first convert the reference image into the target style, then generate the video.
動画延長のつなぎ目でのジャンプカット
典型的な症状。 動画延長で新しい動画を生成したあと、新しい動画を元の動画とつなぐと、つなぎ目でフレームの飛び、または巻き戻りの問題が起きることがある。
解決。 現在の推奨は、キーフレームを揃える後編集でこれを直すことです。根本的な最適化は、将来のモデルの反復で達成されます。
- つなぐ動画を、CapCut または他のプロの動画編集ソフトに読み込む。
- 最初のつなぎ目で、前の動画区間の終わりから 6 フレームを切り詰める。
- 同時に、続く動画区間の始まりから 1 フレームを切り詰める。
- すべてのつなぎ点で、上の操作を繰り返す。
- 書き出し、つないだ動画の滑らかさを確認する。
動画のフレームを揃えたあとでも、わずかな飛びが残ることがあります。前のクリップは転換のカットの瞬間で終わらせ、次の動画はそのカットのあとの新しい場面から始めることを推奨します。
前:つなぎ目で、画面が瞬間的に飛ぶ、または内容が巻き戻る。後:つなぎはより滑らか。
直し方
Repair the join in post-editing by aligning keyframes. At the first join, trim 6 frames from the end of the previous video segment, and trim 1 frame from the beginning of the following video segment. Repeat for all stitching points.
重複したキャラクター
典型的な症状。 フレーム内のキャラクターが多く、三面図(three-view)のキャラクター画像を参照素材として渡した場面では、生成された同じ動画フレームのなかに、同一のキャラクターが二人現れやすい。
根本原因。
- プロンプトのなかでキャラクター主体がはっきり定義されておらず、モデルが異なるキャラクターの役を正確に区別できない。
- キャラクターの三面図(three-view)またはマルチビュー(multi-view)の画像を参照素材に使うと、モデルのキャラクター認識が混乱しやすく、同じ外見の重複キャラクターを生成する。
解決。 双子の問題を 100% 直接避けることはできません。次の方法は、その確率を下げ、成功率を上げることしかできません。
- キャラクター主体の対応をはっきり指定する。 プロンプトのなかで各キャラクターの役をはっきり定義し、役と参照画像の対応を指定する。各キャラクター名のあとに対応する参照画像を記し、形式を一貫させる。例:Zhang San(image 1 に対応)が、立っている Li Si(image 2 に対応)に向かって、緑の通帳を投げる。
- 全体の制約指示を加える。 プロンプトの末尾に、固定の制約を加える。動画の全体を通して、外見、服装、アクセサリーが完全に同一のキャラクターは禁止する。重複したアバターや双子の効果を生成しない。同じフレームには対応するキャラクターを一人だけ残し、キャラクターの繰り返しの複製を再現しない。
- 参照素材を最適化する。 キャラクターの参照画像は、独立した一人の写真を優先する。三面図(three-view)またはマルチビュー(multi-view)の素材は推奨しない。
- プロンプトを簡略化し、最適化する。 完全な台本をそのままプロンプトに使わない。冗長すぎる文面は、モデルの理解を混乱させやすい。無関係な描写を取り除き、指示が明確で、焦点が合っているようにする。
前:動画のなかに双子が現れる。後:役ごとに一人。
直し方
Clearly define each character role and the corresponding reference image, and keep the format consistent. Example: Zhang San (corresponding to image 1) throws the green passbook toward Li Si (corresponding to image 2), who is standing. At the end of the prompt: Throughout the video, characters with completely identical appearance, clothing, and accessories are prohibited. Do not generate duplicate avatars or a twin effect. Keep only a single corresponding character in the same frame, and do not reproduce repeated copies of characters. Prioritize independent single-person photos. Three-view or multi-view assets are not recommended. Do not paste the complete script as the prompt.
動画延長中の画質低下
典型的な症状。 モデルが生成した動画を、延長と継続の入力素材として使うと、画質の低下が起きる。複数回の継続は低下を積み重ね、キャラクターの顔の領域には、まだらな色のブロックが特に出やすい。
解決。 次の方法で、画質低下を和らげられます。根本的な最適化は、のちにモデルの反復を通じて行われます。
- 元の動画を白いモデルの動画に変換し、それを継続の入力素材として使う。参照プロンプト:動画を白い 3D モデル(white 3D model)に変換する。すべてのキャラクターは、色もなく、テクスチャもなく、影もない、純白の 3D モデルとして統一する。純白の背景、安定した構造、滑らかな動きを使う。
- 参照素材には、高精細な画像を優先する。
- 動画の継続回数を合理的に制御し、繰り返して積み重ねた継続を避ける。
前:モデルの出力をそのまま基に継続する。後:継続を行う前に、モデルの出力を白い 3D モデル(white 3D model)の動画へ変換する。
プロンプト
Convert the video into a white 3D model. All characters should be unified as pure white 3D models, with no color, no texture, and no shadows; use a pure white background, stable structure, and smooth motion. Then continue from that white-model video. Prioritize high-definition images as reference assets, and avoid repeated stacked continuations.
特殊効果が期待に合わない
典型的な症状。 特定の特殊効果をプロンプトのテキストで描写したとき、効果が期待と合わないことがある。たとえば、プロンプトが数字 "2999" がカウントダウンのアニメーションとともに現れると指定しても、実際に生成される数字のスクロール効果は無作為に飛び、標準的なカウントダウンの論理に従わないことがある。
解決。 参照動画を使って特殊効果を定義する。目標の特殊効果の動画を参照素材としてモデルに入力し、モデルが効果の形と動きの論理を正確に理解できるようにすると、生成結果は期待により良く合います。たとえば、数字 "2999" の現れ方は @Video1 を参照する。
前:数字のスクロール効果に、乱れた飛びの感じが明らかにある。後:正しい数字スクロール効果の動画を加えると、効果の結果は期待に合う。
参照素材
@Video1
プロンプト
The way the number "2999" appears should reference @Video1.
参照キャラクターが多すぎる
典型的な症状。 参照する人数が 4 人を超えると、モデル出力の安定性が下がり、生成された動画に、人数の誤り(たとえばキャラクターが少なすぎる、または多すぎる)や、キャラクターの重複などの問題が出ることがある。
解決。 次の方法で和らげられます。将来、モデルの反復に基づいて、根本的な最適化が行われます。
- 画像を段階的に生成する。 人をグループに分け、生成する各画像の人数が 4 人を超えないようにする。たとえば 6 人なら、3 人ずつの 2 グループに分け、画像を別々に生成できる。
- 画像から動画を生成する。 最初の手順で生成した、グループ分けされた複数の画像を参照素材として使い、それから最終の動画を生成する。
前:参照キャラクターを 8 人入力すると、出力動画は 9 人になる。後:8 人のキャラクターから画像を 2 枚生成し、それから画像から動画を作る。
直し方
When the number of reference people exceeds 4, group them so that each generated image contains no more than 4 people. For example, 6 people can be divided into 2 groups of 3. Generate those images first, then generate the video from the grouped images.
動画の終わりのノイズ
典型的な症状。 動画にナレーションが含まれるとき、動画の終わりに、突然のクリック音と、途切れるノイズが出やすい。
解決。 動画を再生成するか、CapCut などの編集ソフトを使い、ボリュームエンベロープ(volume envelope)を通して、終わりの音声トラックにオーディオのフェードアウト処理をかけ、途切れのノイズを除く。
CapCut を使う具体的な手順:
- 生成された動画を CapCut に読み込む。
- タイムライン上のビデオトラックを選び、ツールバーの Audio をクリックする。
- Volume envelope の機能を選ぶ。一部のバージョンでは、Basic / Adjust メニューのなかにある。キーフレームを選ぶ。音量とキーフレームを表す線が、音声トラック上に現れる。
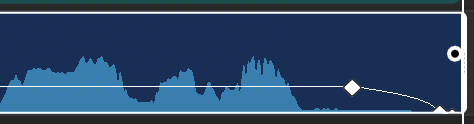
- 動画の終わり近くで、最後の音量キーフレームを音量 0 まで下へドラッグし、下向きの傾斜を作る。カード上の曲線が、その傾斜である。
- プレビューし、終わりの音声が自然にフェードアウトし、突然の途切れやノイズがないことを確認する。
前:終わりにノイズがある。後:終わりにノイズがない。
参照素材
@Image1
直し方
Regenerate the video, or fade the ending audio to silence with a volume envelope. Near the end, drag the final volume keyframe down to 0 so the curve in @Image1 forms a downward slope.
中国語の発音が不正確
典型的な症状。 モデルは、多音字、まれな字、形の似た字を読み誤りやすい。
解決。 読み誤りやすいテキストを、同じ発音の、よく使う同音の語に置き換え、発音のずれを避け、期待する音声効果を取り戻せます。この解決は最適化の方法にすぎず、すべての発音の問題を完全に避けることはできません。
例:プロンプトのなかの "螭龙山" を、同音の "吃龙山" に書き換えられます。
前:"螭龙山" の "螭" の発音が正しくない。後:"吃龙山" に変えると、発音は正しい。
プロンプト
Replace text that is easy to misread with a commonly used homophone of the same pronunciation. Rewrite "螭龙山" as "吃龙山". This is an optimization and cannot completely avoid all pronunciation issues.
声の参照が不正確
典型的な症状。 参照音声を使って声を指定したとき、最終的に生成された動画の音声の声が、参照の声と大きく異なる。
解決。
- プロンプトに、声の特徴の詳しい描写を加える。この例で実際に使う一文は、"use the low, thick, warm, and finely grainy middle-aged male voice of
@Audio1" である。 - 動画のセリフのスタイルを、参照音声の口調と表現のスタイルに近く保つ。これは、声の復元と安定性を高めるのに役立つ。
マルチ参照 では、そのファイルは @Audio1 です。Seedance 2.0 ファミリーでは、音声を少なくとも一つの画像または動画と組にします。
前:声が入力音声と一致しない。後:プロンプトに声の特徴の描写を加えると、声の一致の精度が明らかに上がる。
参照素材
@Audio1
プロンプト
Use the low, thick, warm, and finely grainy middle-aged male voice of @Audio1. Keep the style of the lines close to the tone and expression of that reference audio.
プロンプトの例
この節は、テキスト生成、画像参照、動画参照、動画編集についての、公式のプロンプト例を示します。各カードのプロンプトは、公式の文を保ちます。セリフと画面上の言葉は変えていません。@Image1、@Video1、@Audio1 は、Image 1、Video 1、Audio 1 に対する、このスタジオのトークンです。公式プロンプトが Image 1、Image 2、Image 3 と言うところは、一枚の参照シート上のラベルであり、そのシートが単一のファイル @Image1 です。
スローガン
プロンプトテンプレート:[テキスト内容] + [タイミング] + [配置] + [登場/現れ方]、[視覚属性(色、フォントのスタイル)]。
Seedance 2.0 は、文脈に基づいて適切なテキストスタイルを合わせられます。テキストの表示に厳密な要件がある場合は、複数画像参照の下にあるロゴの例を使います。
参照素材
@Image1
プロンプト
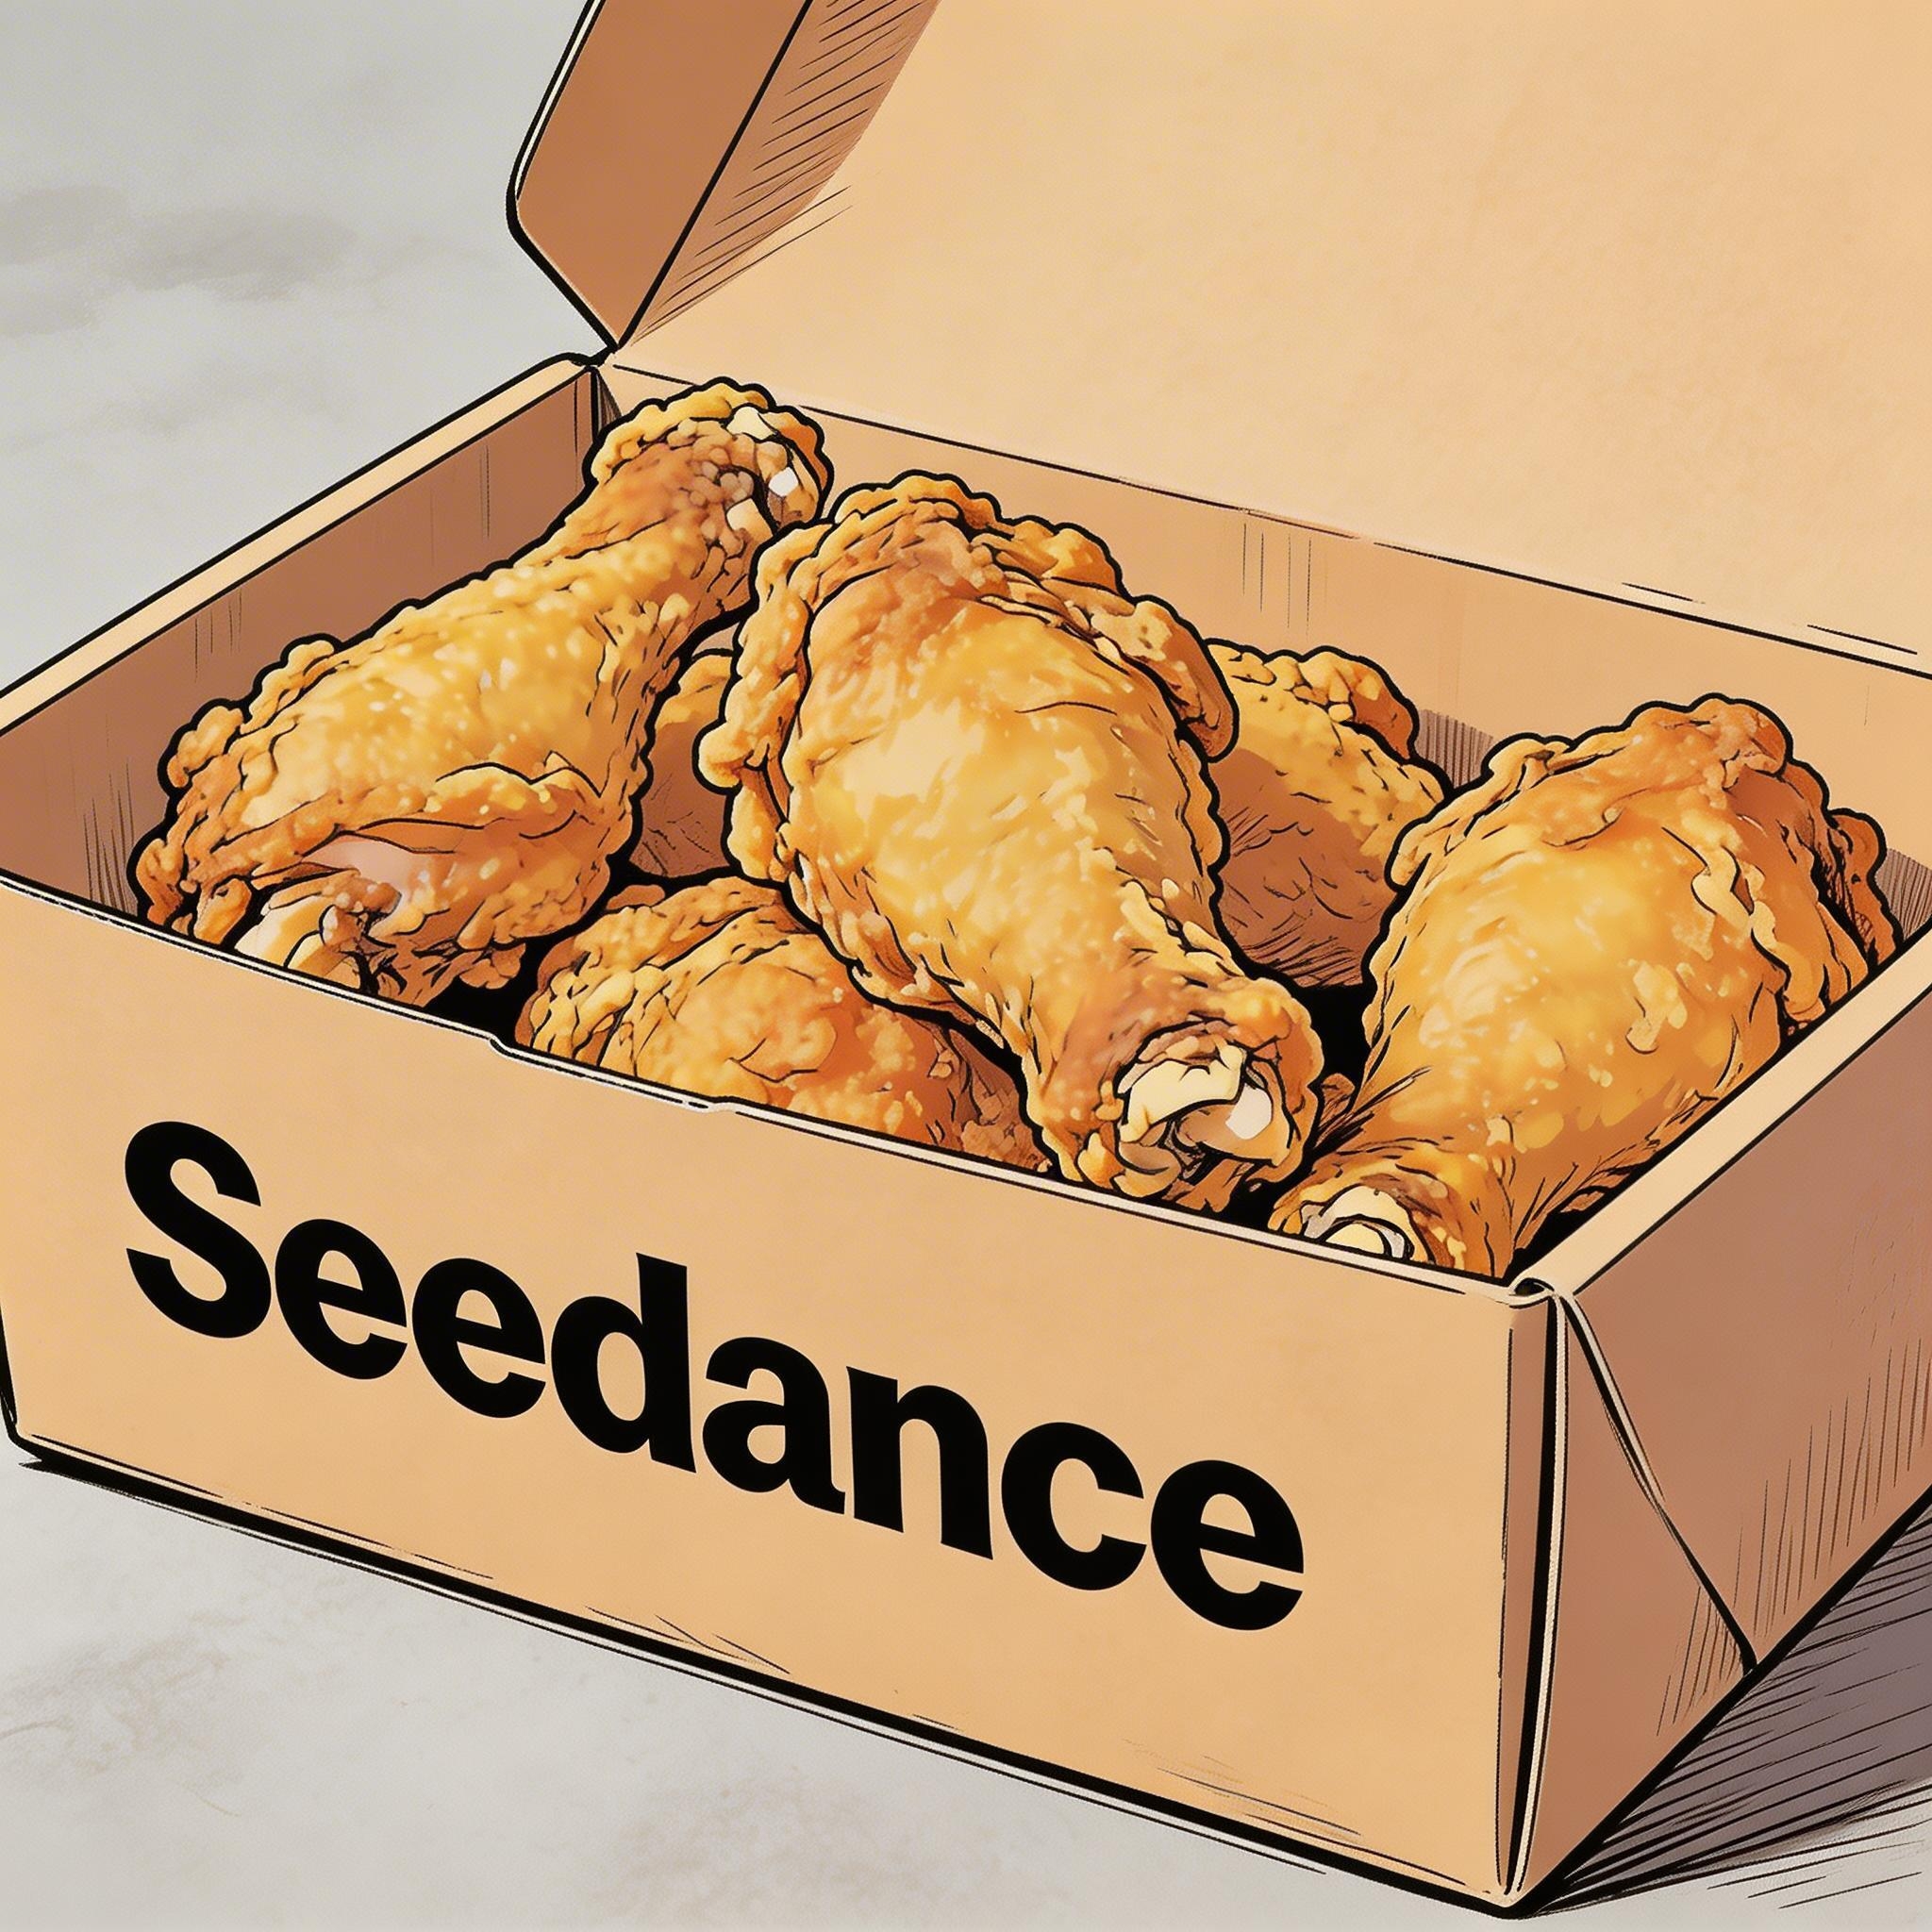
Hand-drawn comic style: Three people are sitting around a table enjoying the fried chicken shown in @Image1, with a friendly and joyful atmosphere. The frame then gradually blurs, and the text "Bite", "Laugh", and "Seedance" in order appears in the center of the screen.
字幕
プロンプトテンプレート:テキストとともに、字幕を下中央に表示する。字幕は、音声のリズムと間に完全に同期していなければなりません。
最初の例はボイスオーバーです。二つ目は吹き替えです。
参照素材
@Image1
プロンプト
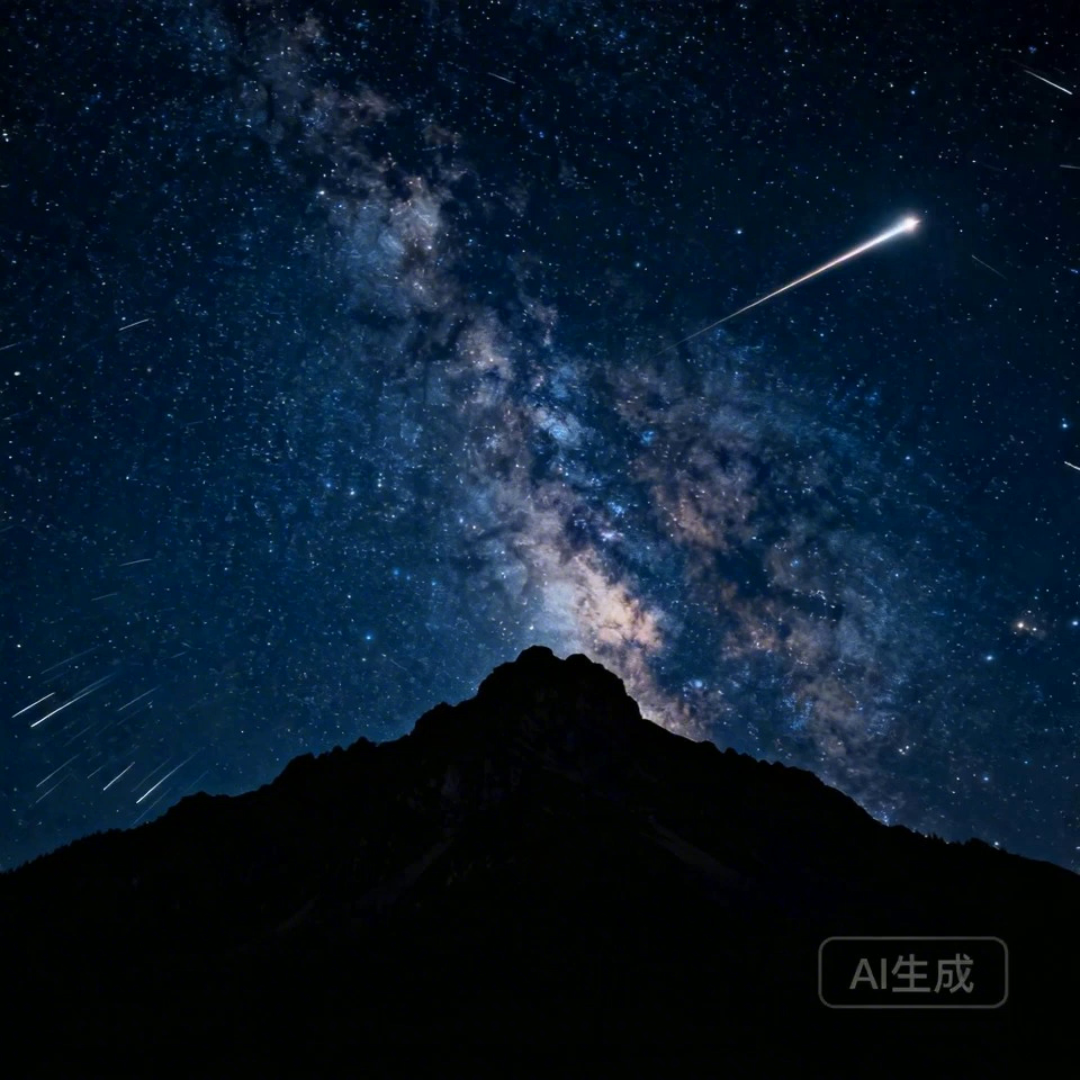
I2V: A time-lapse of a mountain landscape transitioning from a vast, starry night to a vibrant dawn. Reference @Image1. Voiceover: A deep, serene male voice says: "In the vast silence of the cosmos, our world is but a fleeting moment. Yet, within it, life defiantly thrives." Text integration: Render the narration as subtitles at the bottom-center. Subtitles must be perfectly synchronized with audio timing.
参照素材
@Image1
プロンプト
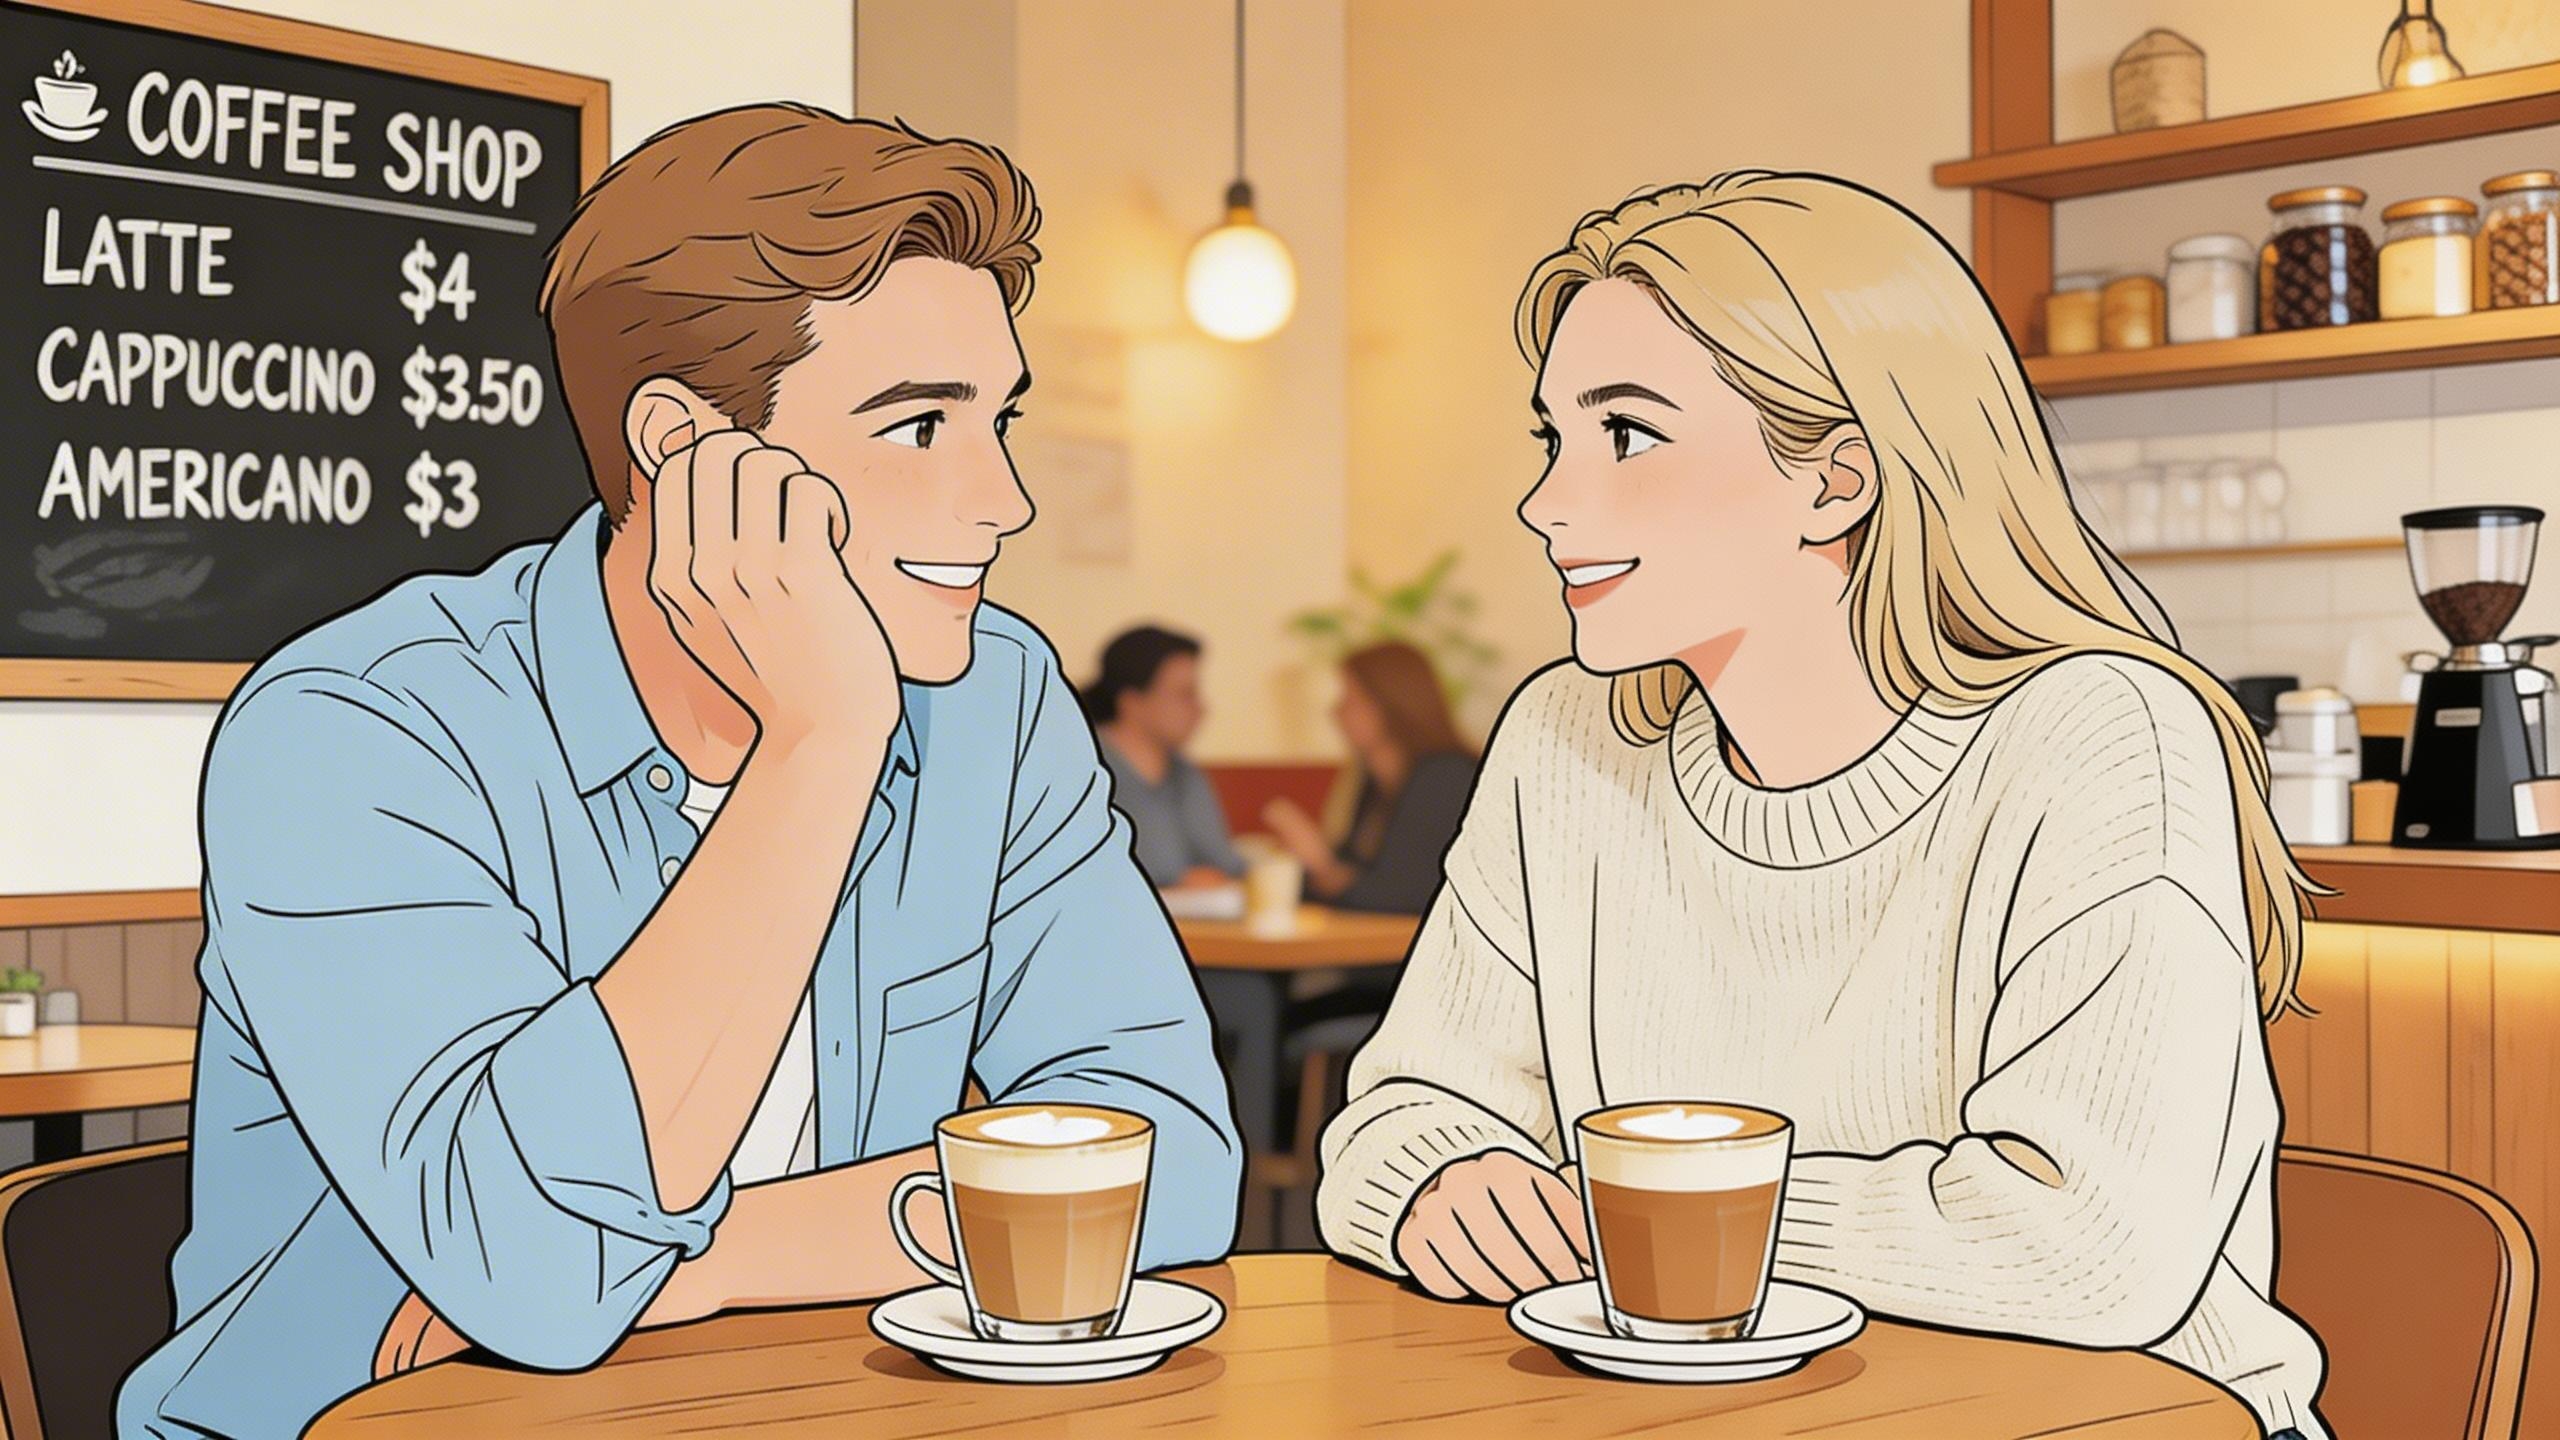
R2V: A shot of these two people in @Image1 chatting in a modern office. The woman speaks first with a playful tone: "You always arrive right on time, don't you just love that perfect timing?" followed by the man's smiling reply: "I have my own rhythm." Text integration: Render the dialogue as subtitles at the bottom-center of the screen. Subtitles should appear sequentially as each character speaks.
吹き出し
吹き出しは話されたセリフを含み、話しているキャラクターのそばに現れます。
参照素材
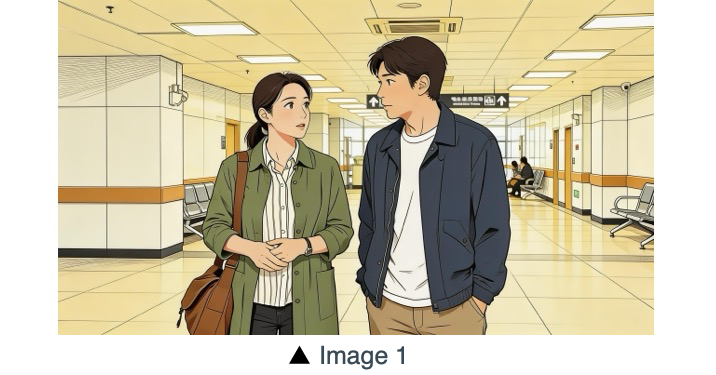
@Image1
プロンプト
The two characters from @Image1, both dressed in sportswear, are running on the school playground. The girl looks at the boy, smiling confidently as she says: "We can definitely do it!". Cut to a close-up of the boy. He hesitates and replies: "Are you sure?". Cut back to a medium close-up of the girl. She speaks in a light, upbeat tone: "Yes!" Her demeanor is bright and resolute. Speech bubbles containing the corresponding lines appear around the speaking character.
参照素材
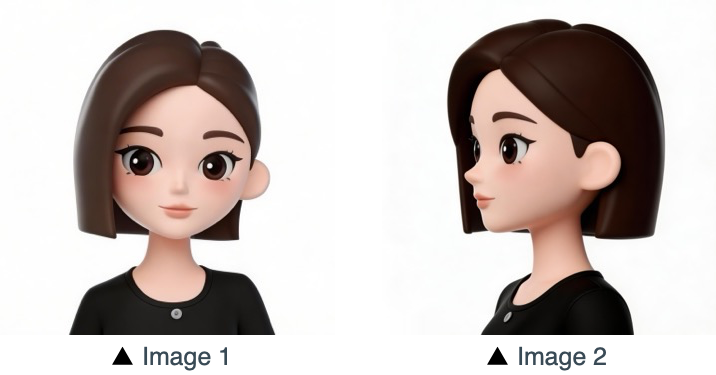
@Image1
プロンプト
Refer to the character design of the girl in Image 1 and Image 2 on @Image1. The scene is set in an apple field: the girl picks one apple, takes a bite, smiles and says "This is the real deal!". A speech bubble pops up beside the girl, with this line written inside.
多視点の主体参照
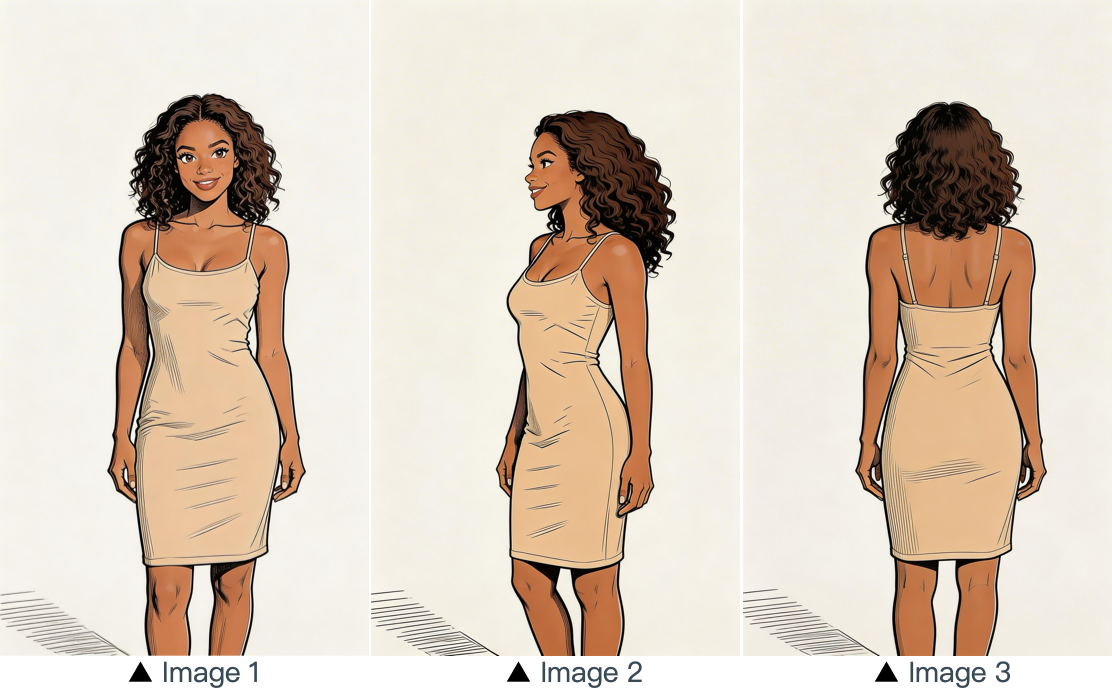
一つの主体を、シート上のいくつかの角度から参照します。家電、家庭と生活、そして人物です。
参照素材
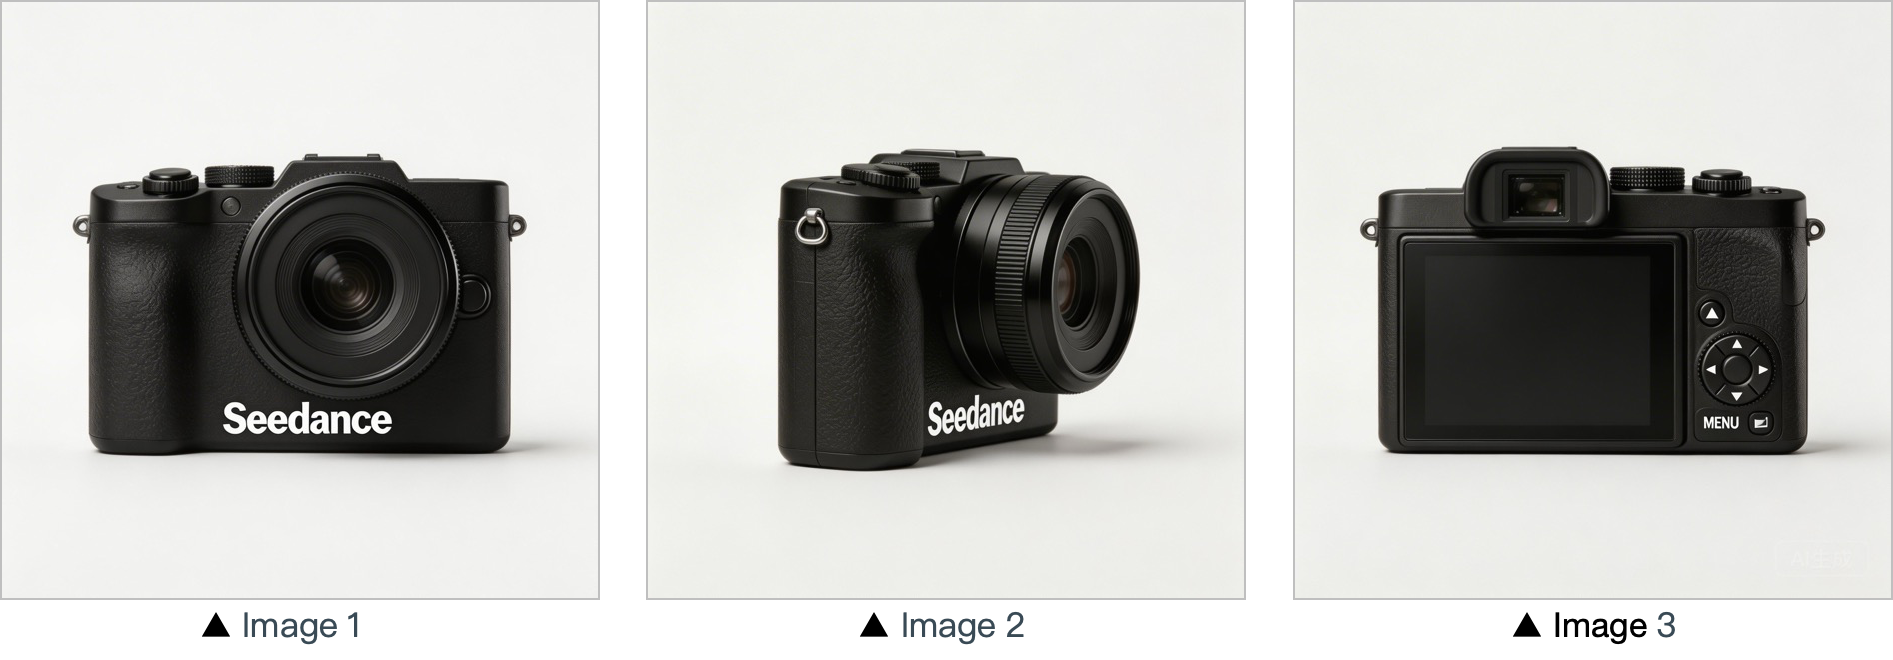
@Image1
プロンプト
Use the cameras featured in Image 1, Image 2 and Image 3 on @Image1. Replace the original background with a white one, and place the cameras on a white table. The camera first focuses on the cameras in close-up, then slowly rotates 360° with the cameras as the main subject, clearly displaying the front, sides and back of each camera.
参照素材
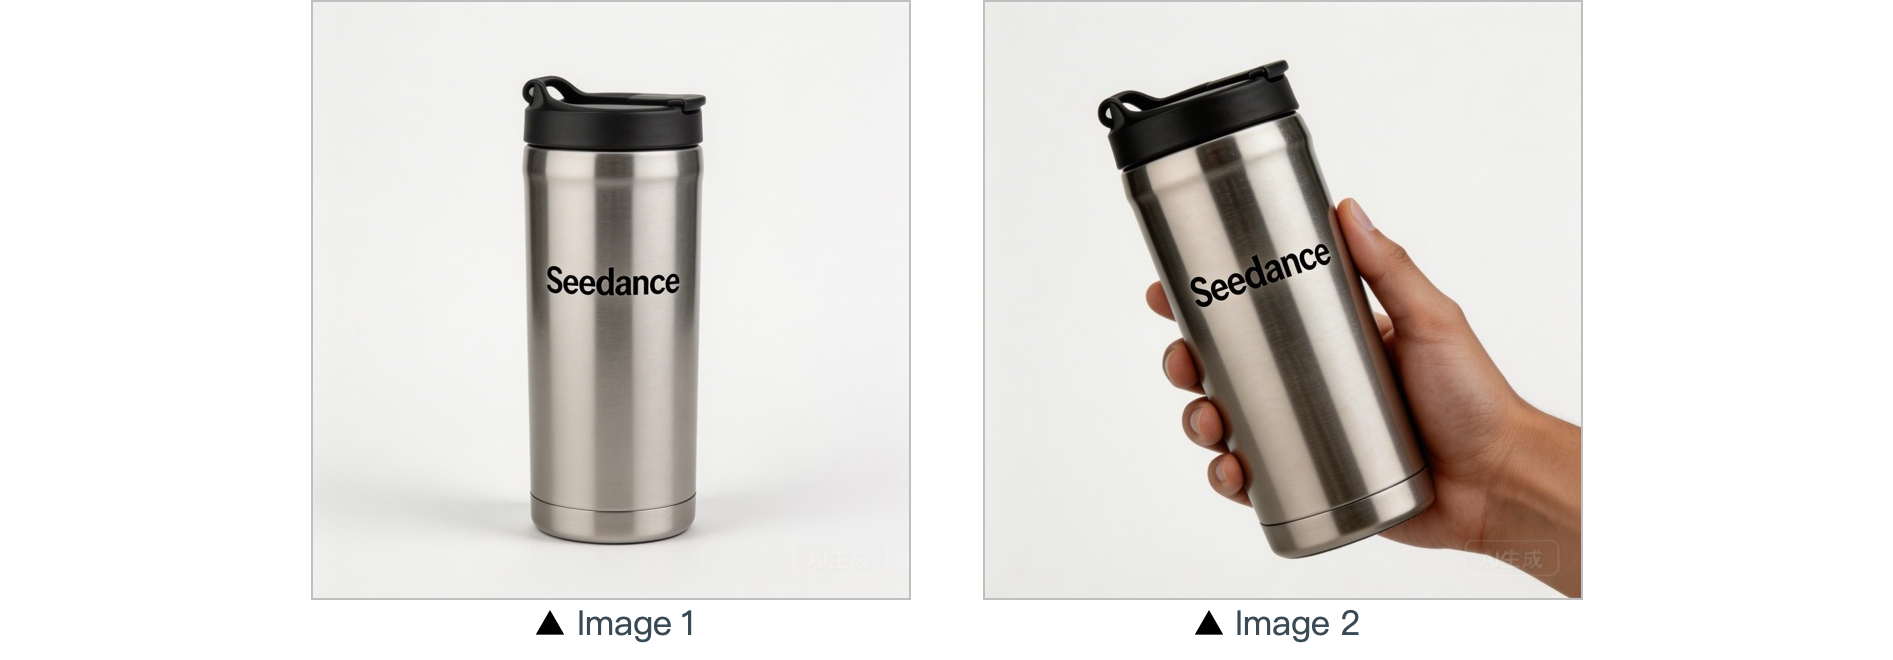
@Image1
プロンプト
In a warm-toned home setting, present the thermos shown in @Image1 in a medium shot. Then smoothly push the camera into a close-up of the thermos. Next, a hand naturally enters the frame off-screen, gently grips the thermos body and picks it up. The camera follows the slight rotating motion of the hand to showcase the thermos.
参照素材
@Image1
プロンプト
Refer to the image of the woman in Image 1, Image 2 and Image 3 on @Image1, and generate a scene of her eating a cake in a coffee shop.
複数画像の参照
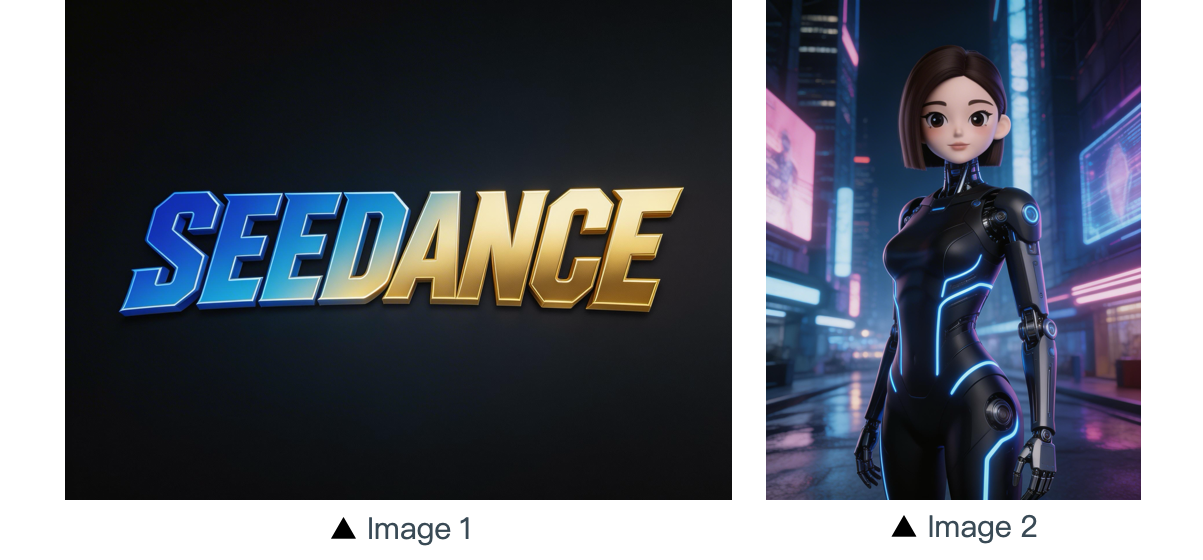
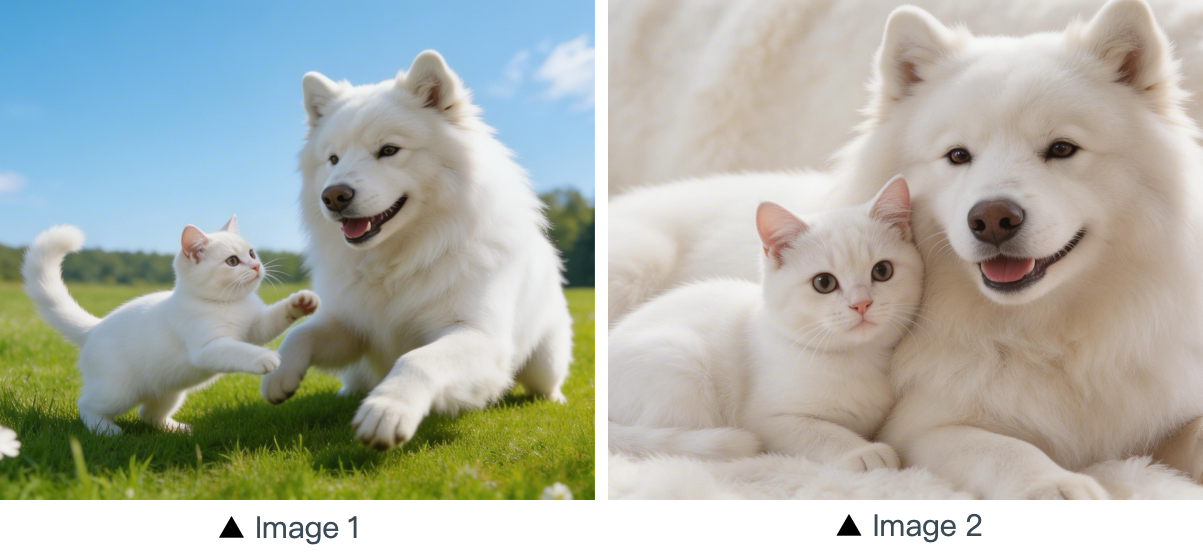
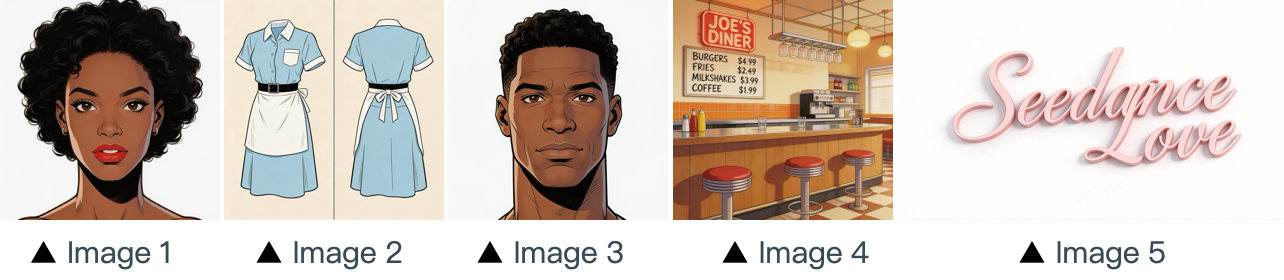
シート上の各絵には、一つの仕事があります。ロゴ、複数の主体、配役と場所、複数コマの連続、またはフレームの連続です。
参照素材
@Image1
プロンプト
The scene is set on an aerial corridor in a neon-drenched futuristic metropolis, where flying vehicles and holographic ads intertwine. Featuring the girl from Image 2 on @Image1, the sequence opens with a medium shot of her releasing a silver floating lantern embedded with a holographic projection. The camera then pulls back to reveal floating lanterns flooding the sky, which gradually converge at the center of the frame to form the logo from Image 1 on @Image1. The entire piece adopts a 3D cyberpunk sci-fi animation style.
参照素材
@Image1
プロンプト
Using the cat and dog from Image 1 and Image 2 on @Image1 as prototypes, the scene unfolds in a cozy apartment. The dog is lying on the ground eating dog food when the cat approaches, extending a paw to nudge the dog. The dog pauses its meal upon noticing the cat, and the cat snuggles up next to the dog. The entire scene features a warm colored tone.
参照素材
@Image1
プロンプト
The scene is set in the restaurant from image 4 on @Image1, with people coming and going. The girl from image 1, wearing the clothes from image 2, is organizing the items on the counter. The boy, a customer, from image 3 approaches her to ask for her contact information. The logo from image 5 remains in the bottom right corner throughout.
参照素材
@Image1
プロンプト
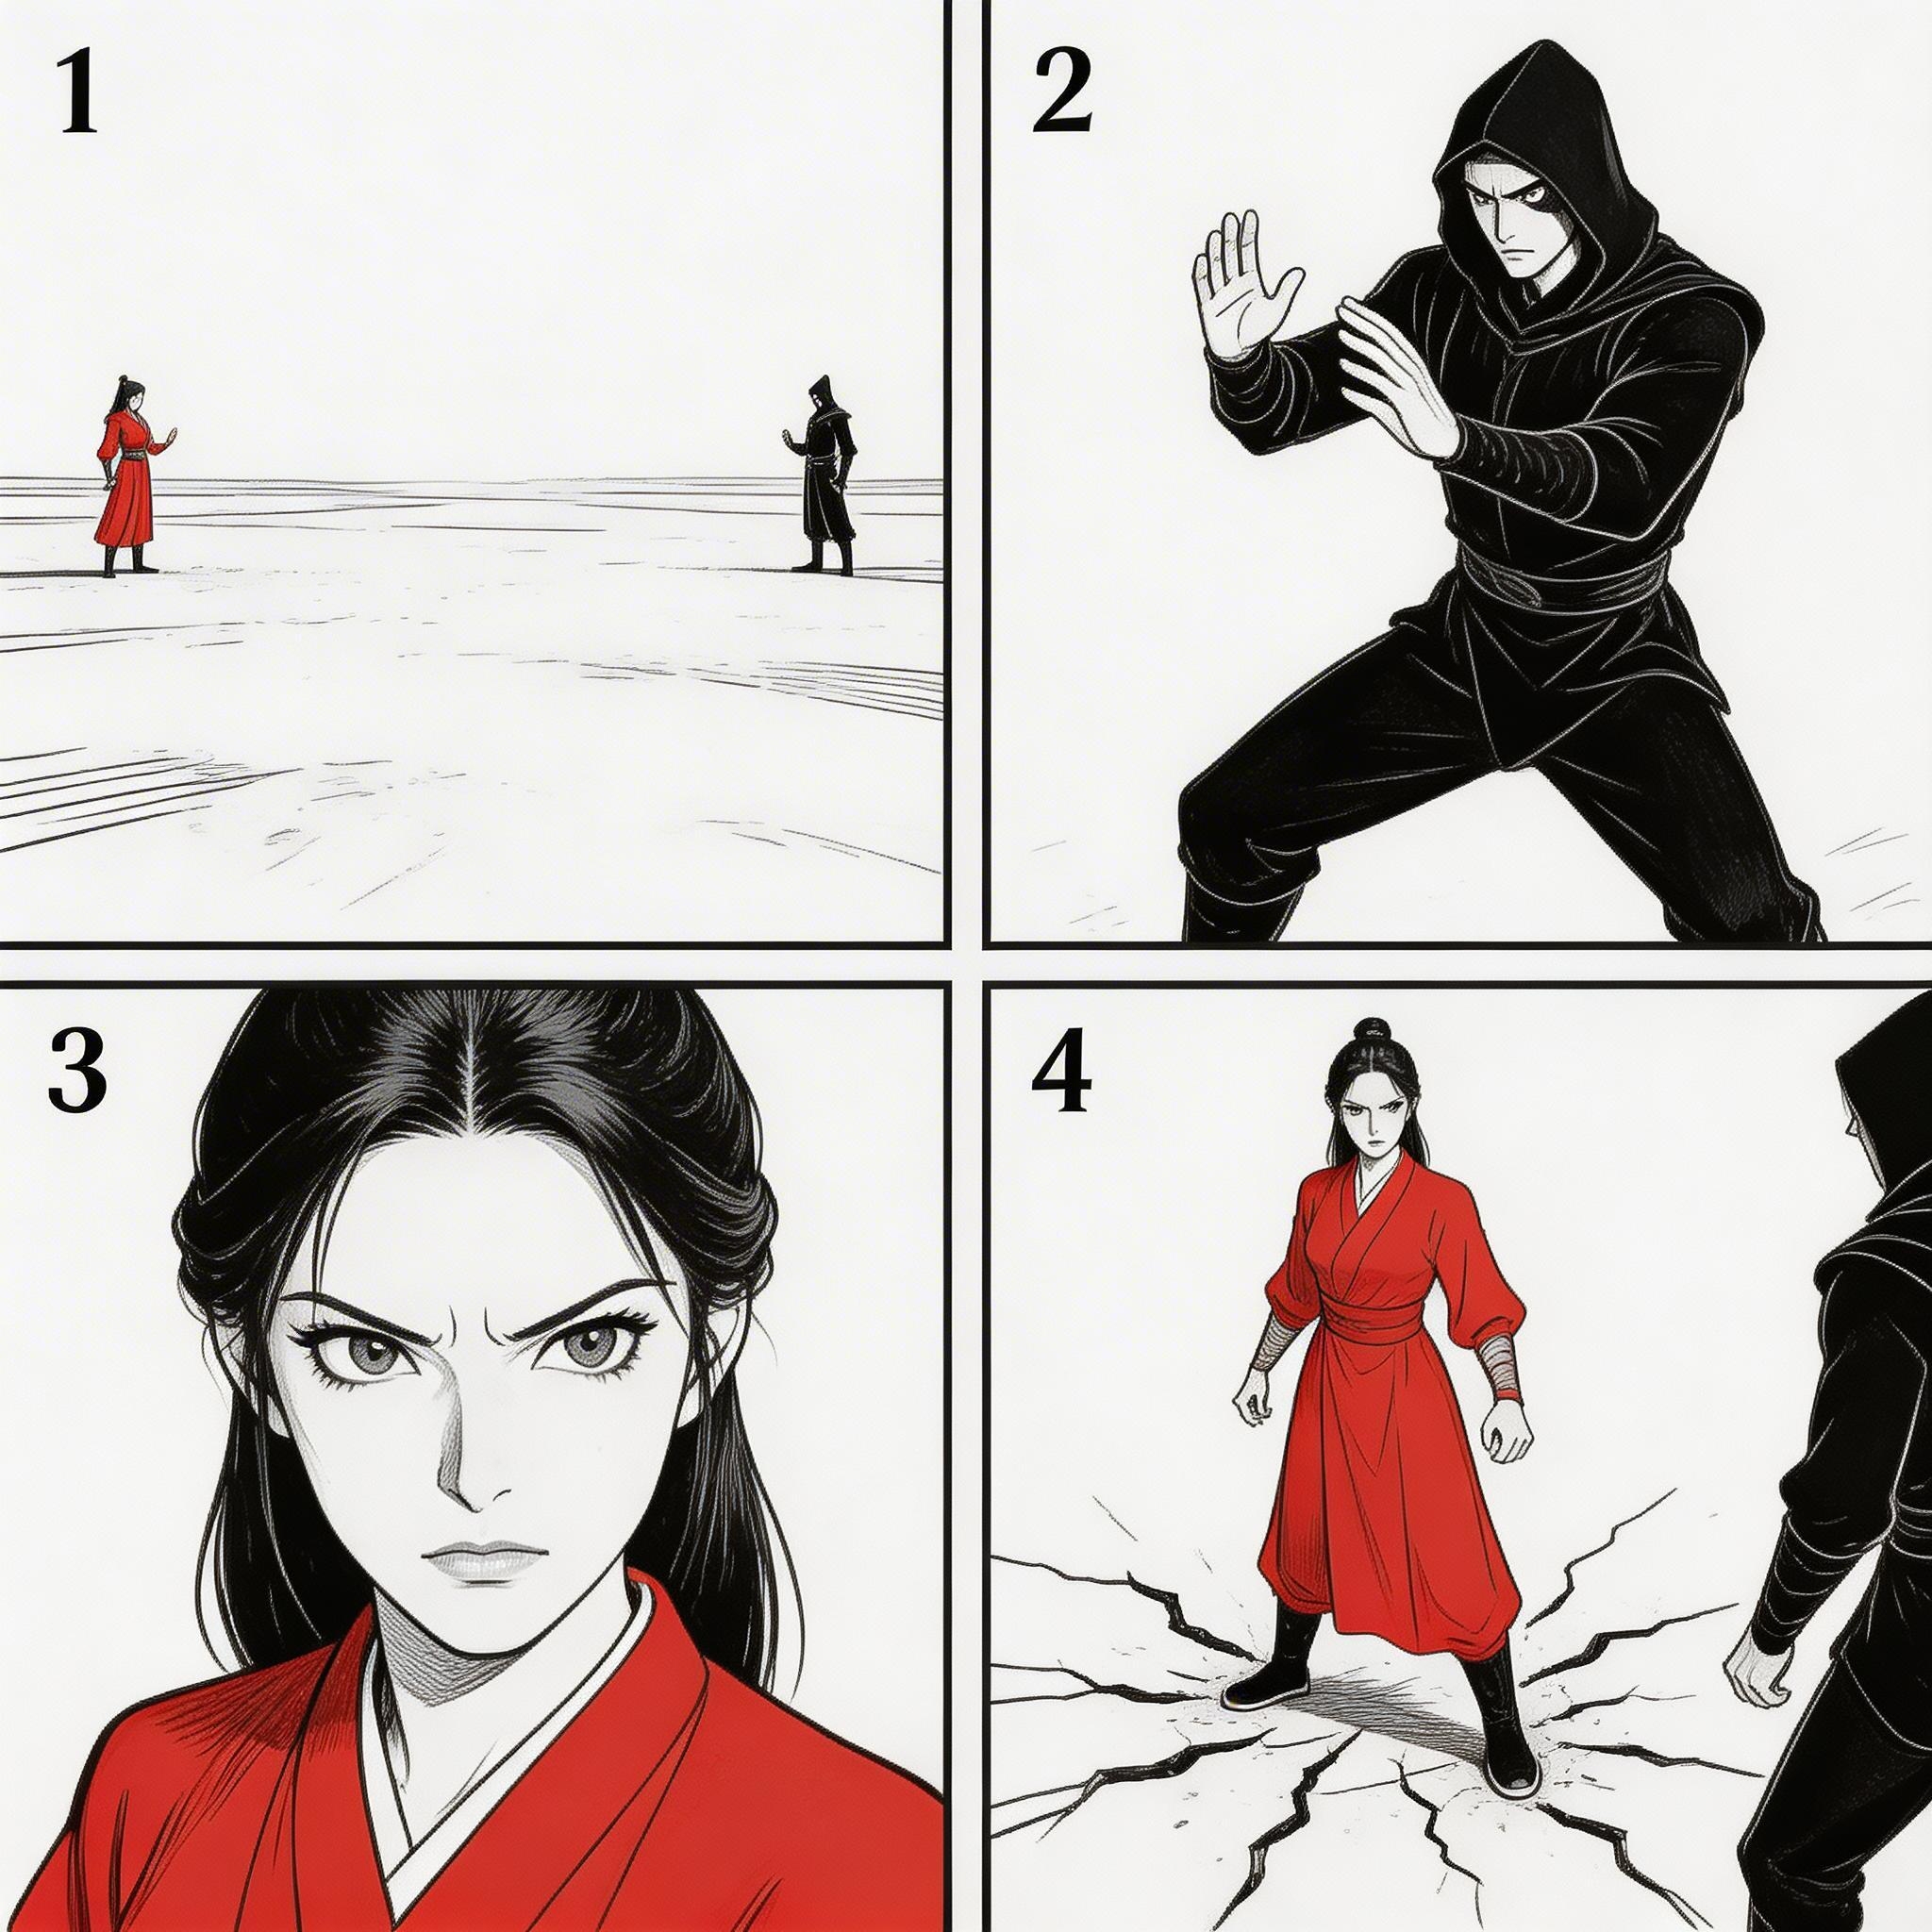
Refer to the sequence in @Image1 to create an intense high-energy fight sequence. All frame compositions from @Image1 shall be presented in strict predefined order, after which the two characters engage in fierce, fast-paced combat.
参照素材
@Image1
プロンプト
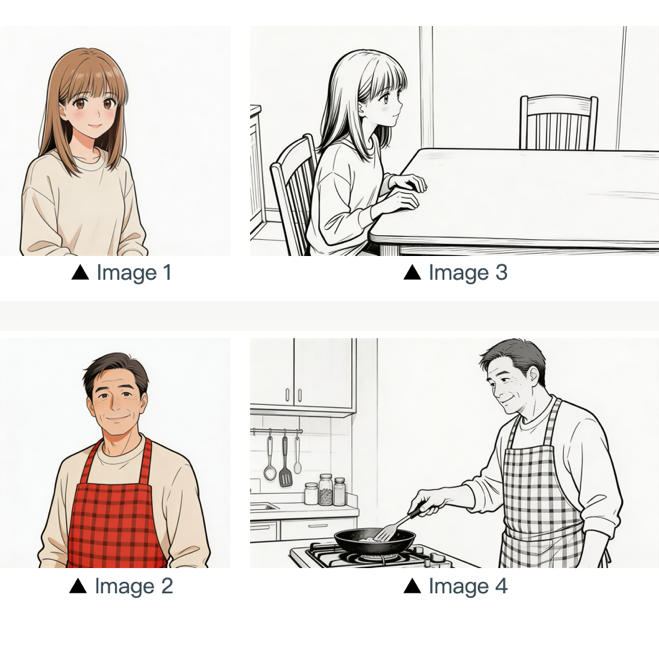
Refer to the composition in Image 3 on @Image1. A girl (her character design refers to Image 1) is waiting for her father to finish cooking, and she says: "아빠, 배고파요! 밥 다 됐어요?" Then the camera pans right and cuts to the frame and composition shown in Image 4. The father (his character design refers to Image 2) replies to her: "거의 다 됐어, 조금만 기다려!" Next, the camera cuts back to a close-up shot of the daughter's slightly disappointed facial expression, and she says: "아직 멀었어요? 맛있는 냄새 나는데..." Then the shot switches to a close-up of the father's face, and he says: "이제 진짜 금방이야. '빨리빨리' 하지 말고 손부터 씻고 와!"
動きの参照
動画のなかのキャラクターの動きとショットの言語を参照し、それから画像のなかのキャラクターに適用します。マーケティングの例は、動画のなかの馬の走る形を参照します。
参照素材
@Image1
@Video1
プロンプト
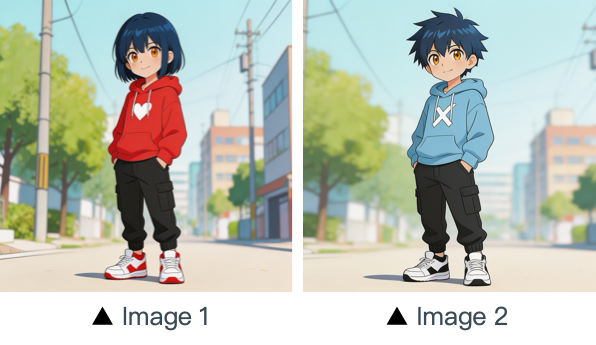
Refer to the character movements and shot language in @Video1 to create a fight scene with the character from Image 2 on @Image1 on the left and the character from Image 1 on @Image1 on the right. Include intense background music.
参照素材
@Video1
プロンプト
Referencing the running shape of the horse in @Video1, generate a scene: a golden steed runs on the grassland, then freezes its magnificent running posture and turns into a horse-shaped gold pendant.
カメラの動きの参照
動画のなかのカメラの動きを参照し、画像のなかの新しい主体に名前を付けます。
参照素材
@Image1
@Video1
プロンプト
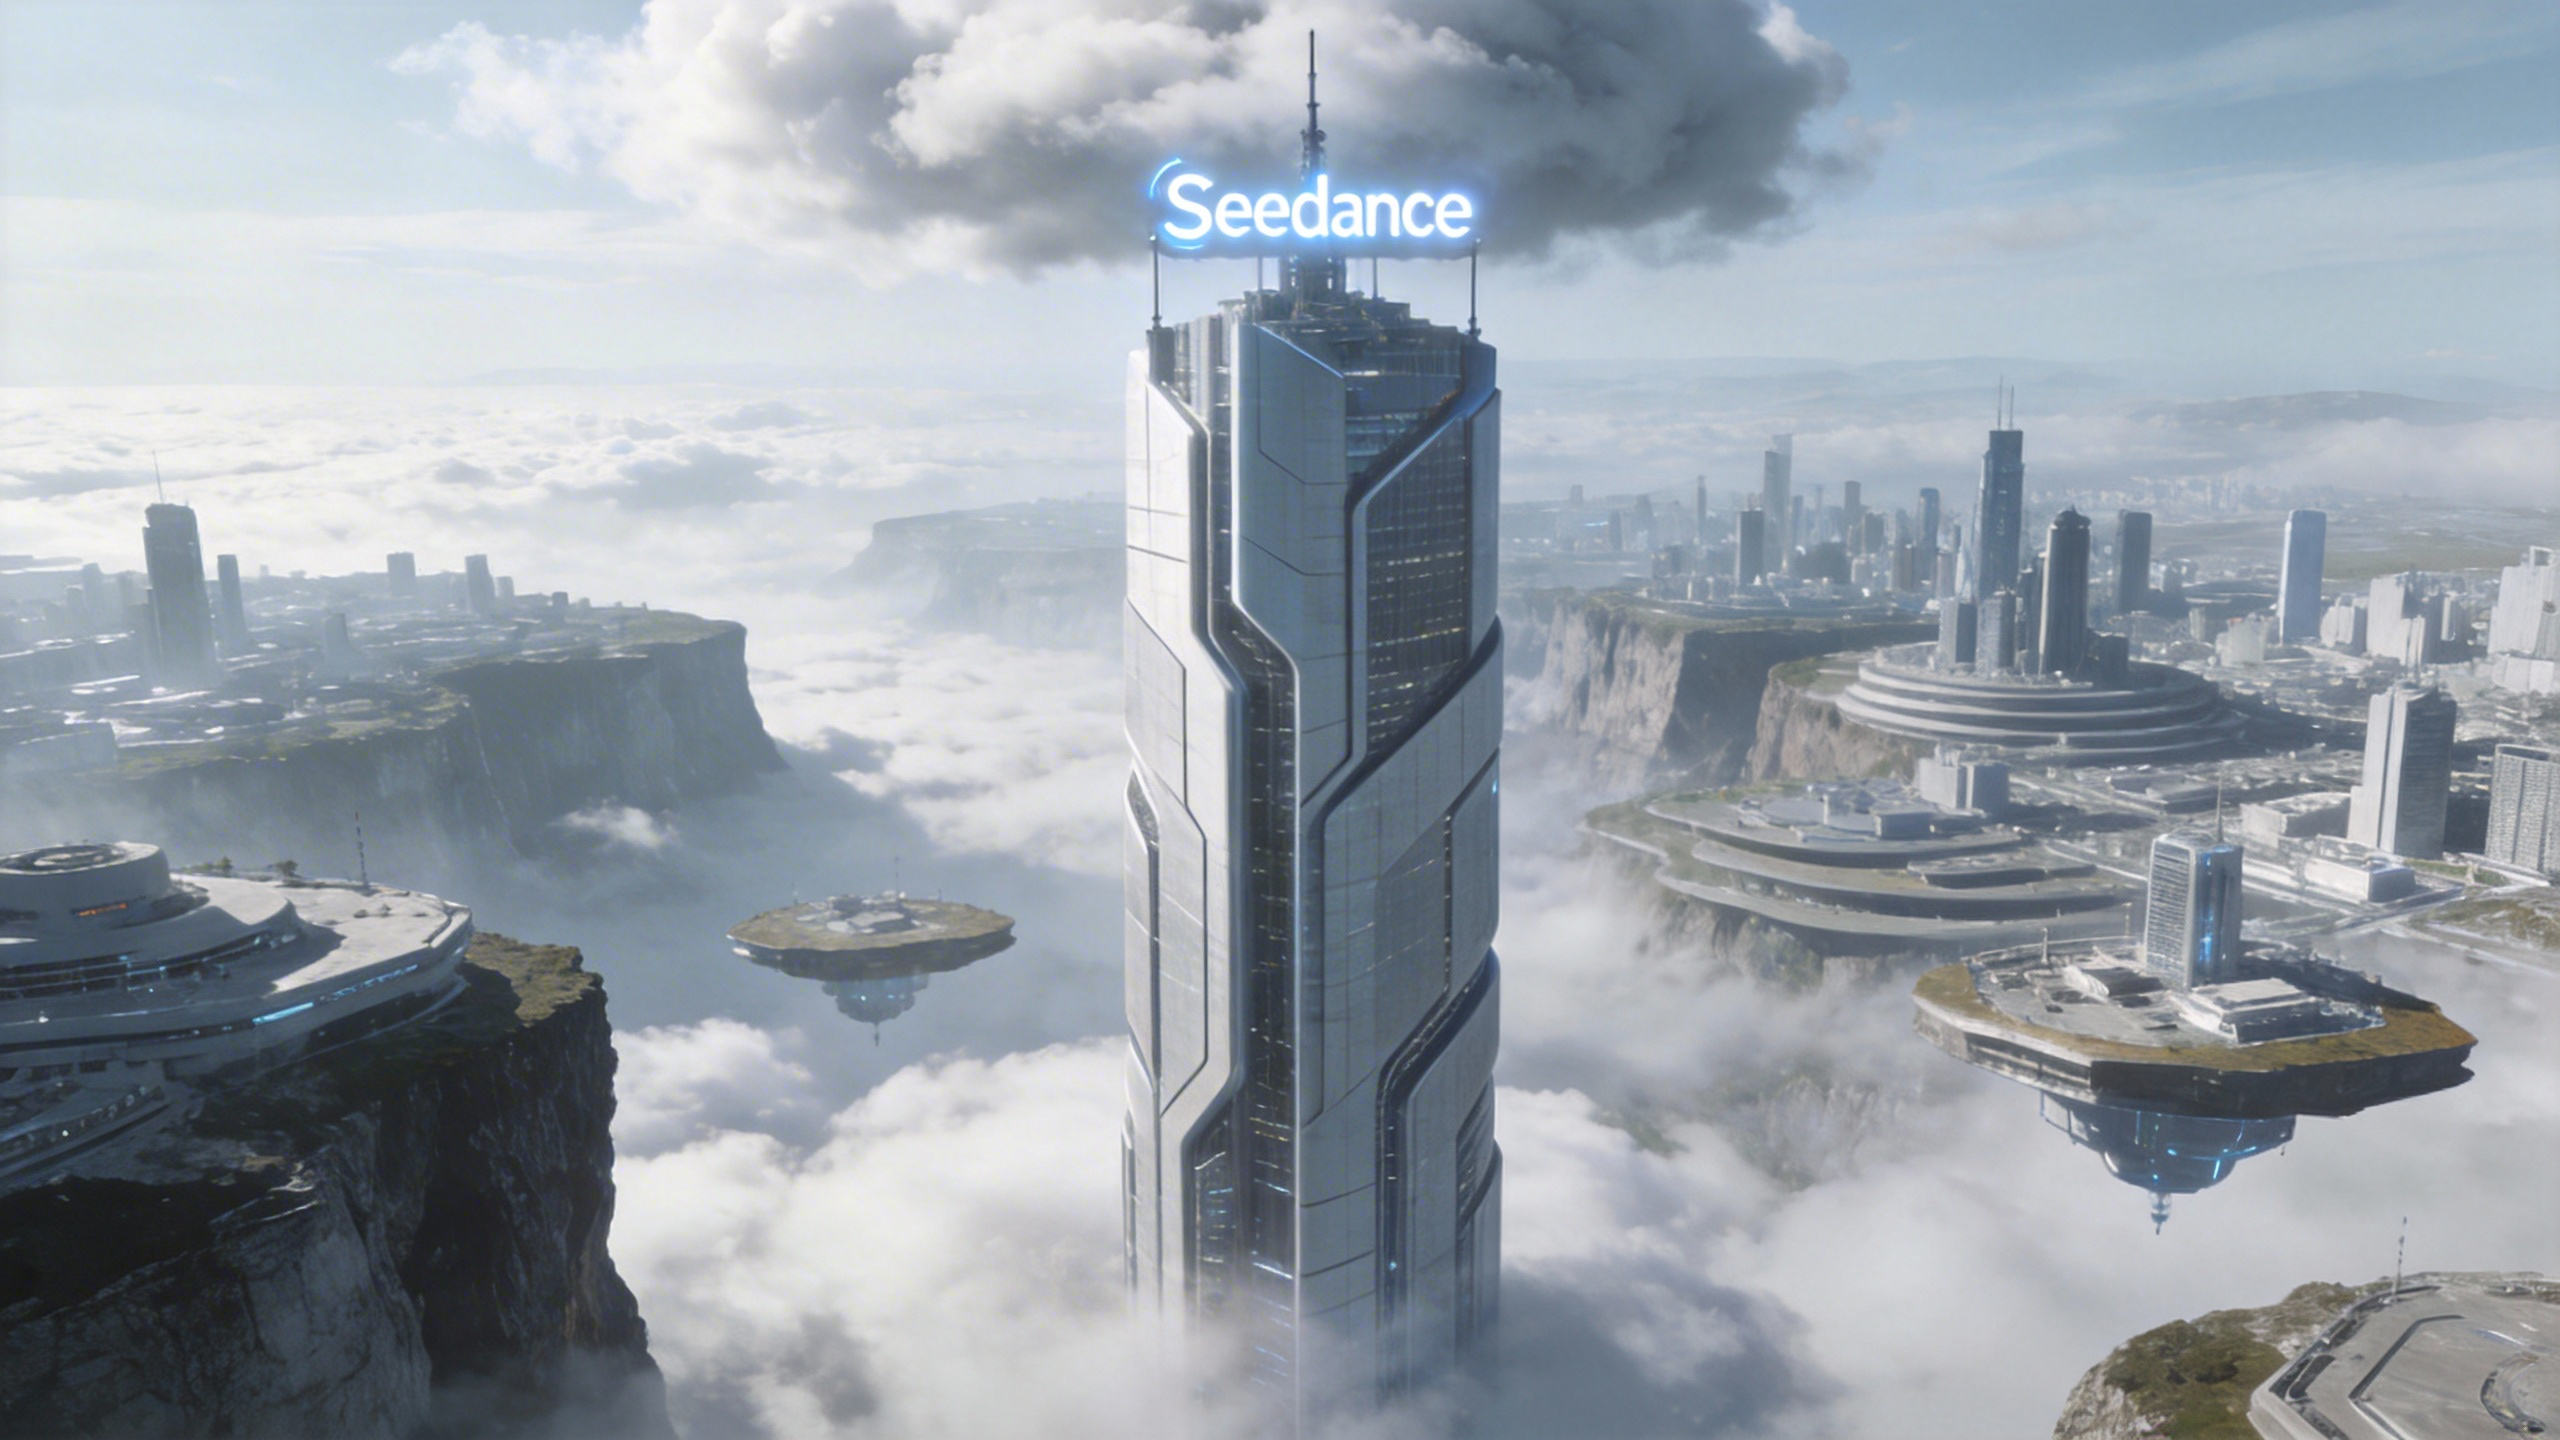
Referring to the camera movement in @Video1, create a concept video for a science and technology park, with the tall building in @Image1 as the visual center, also using a first-person diving perspective, to reflect the sense of technology in the park from @Image1.
特殊効果の参照
動画のなかの特殊効果を参照し、その同じ効果、経路、順序を、画像のなかのキャラクターに適用します。
参照素材
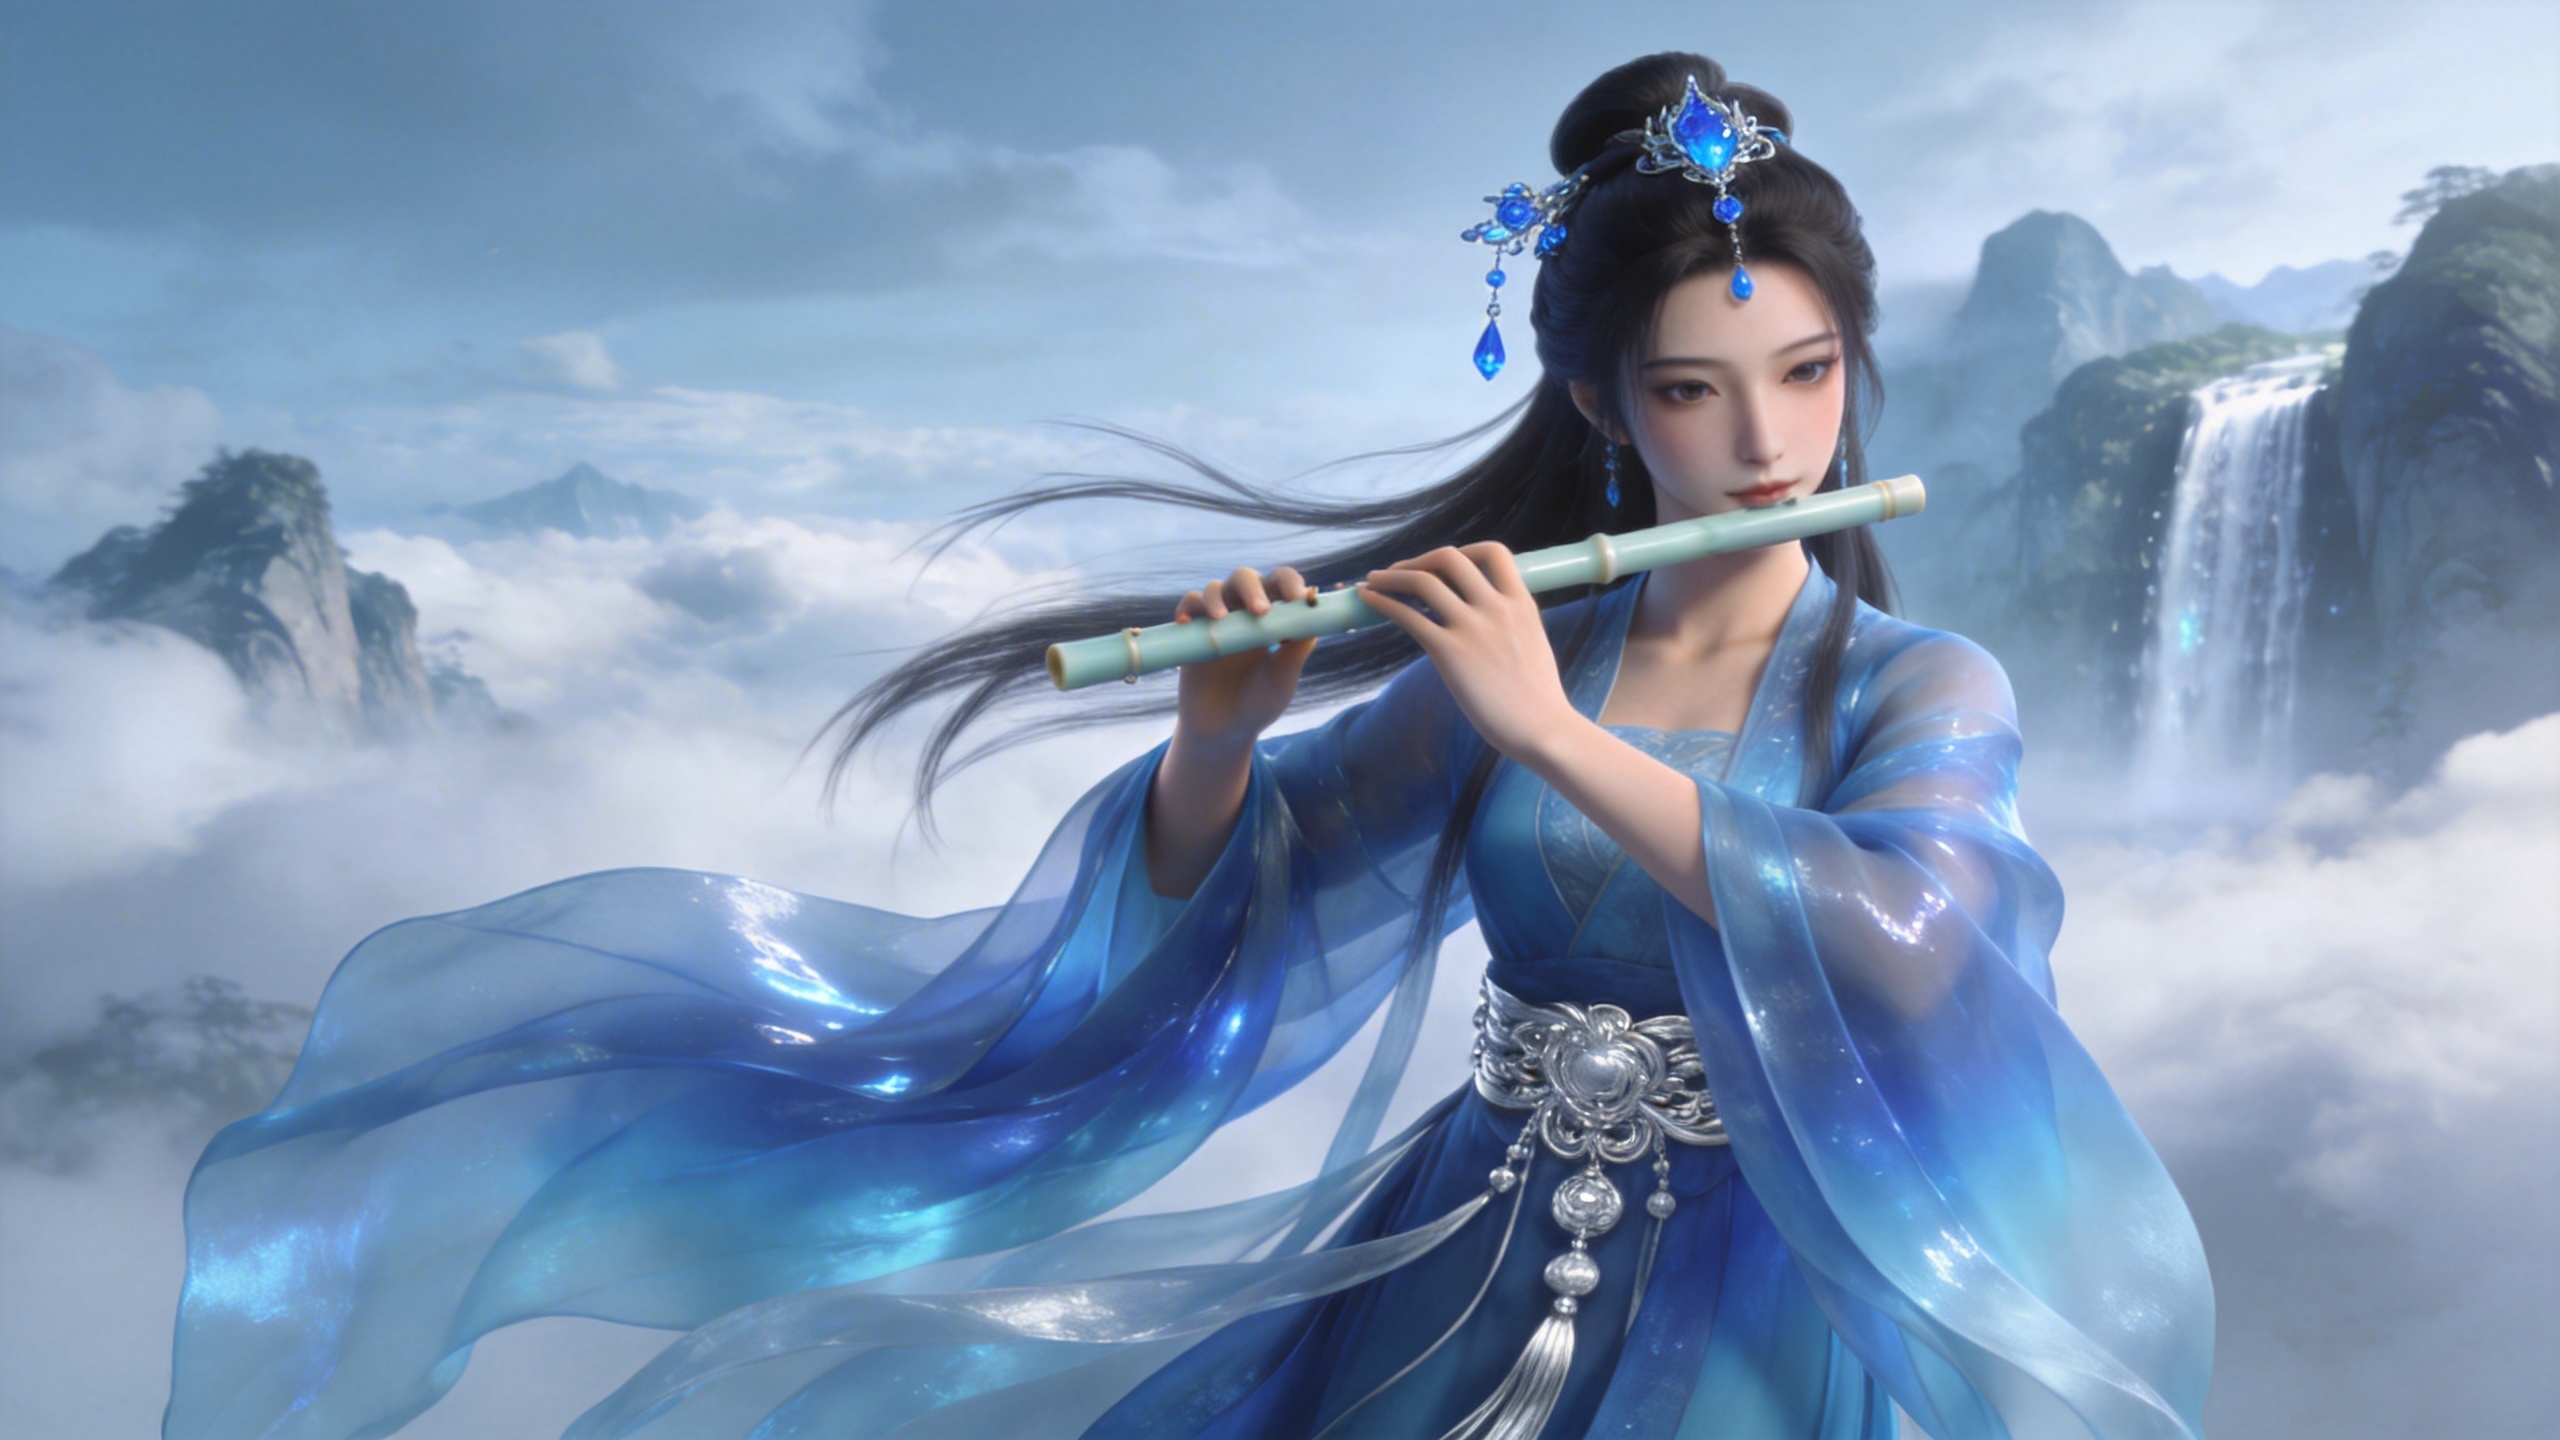
@Image1
@Video1
プロンプト
Refer to the golden particle effects in @Video1, so that when the character in @Image1 plays the flute, the same particle effects surround their body.
参照素材
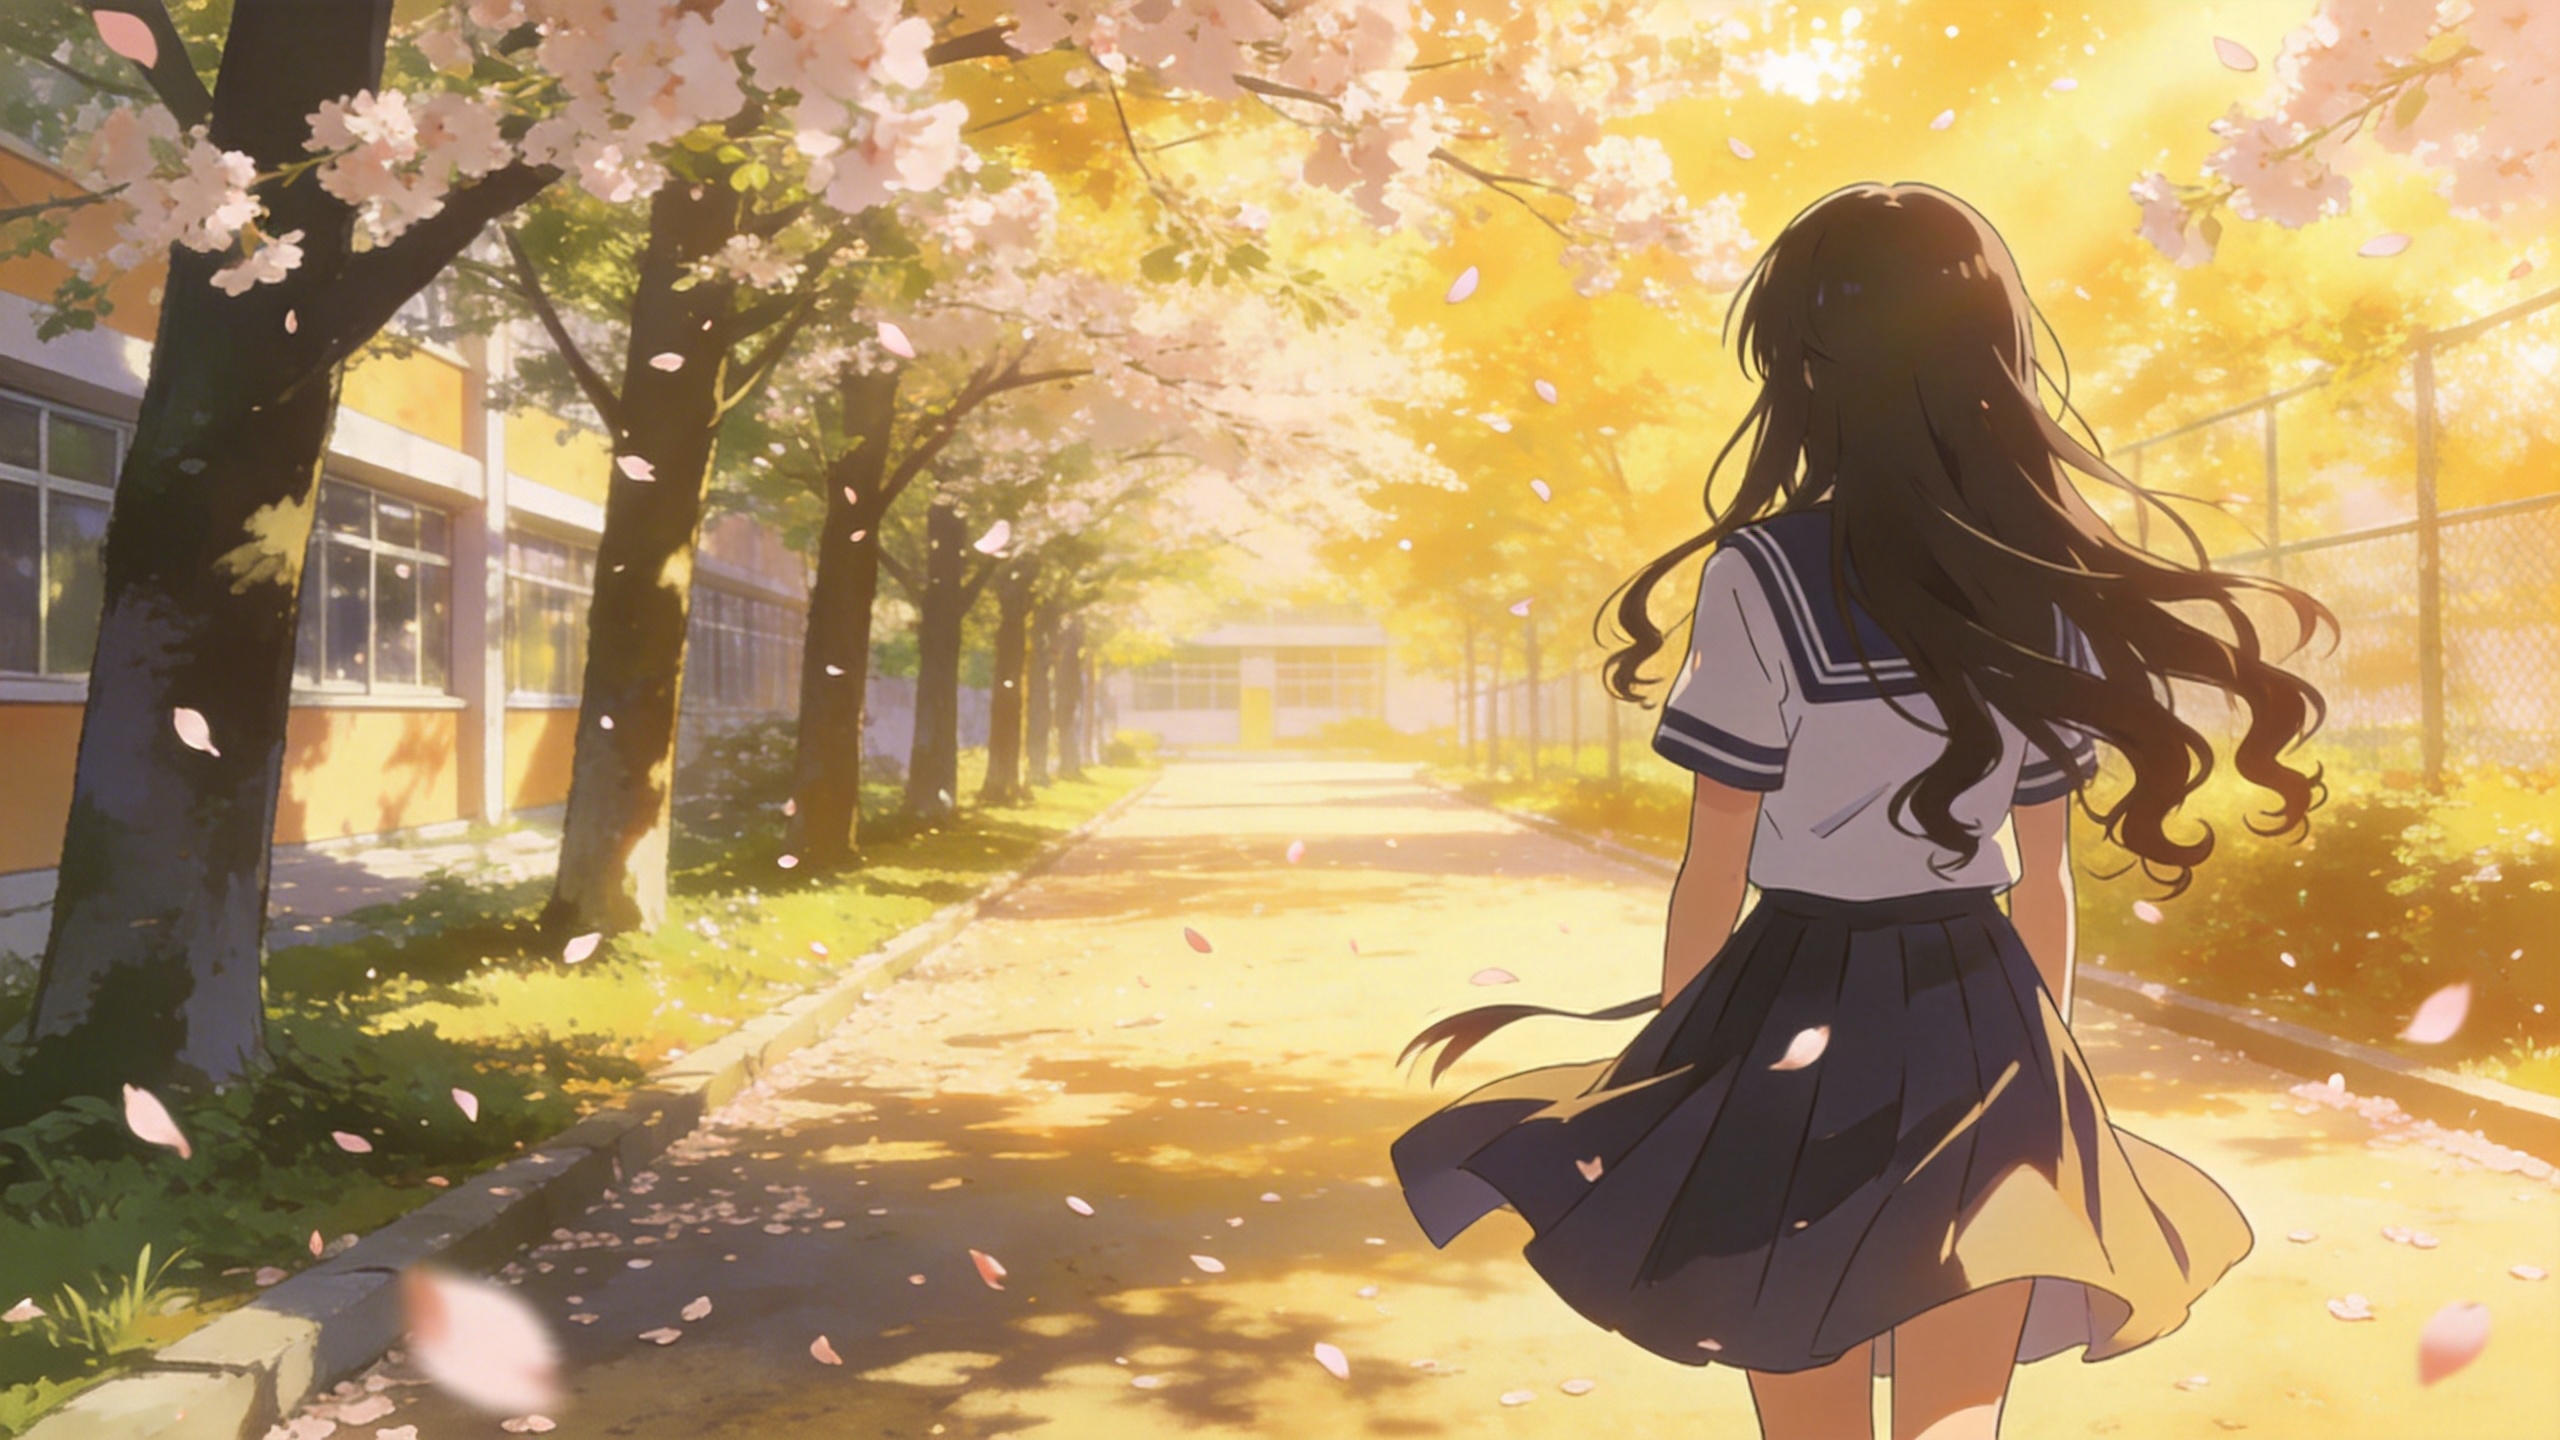
@Image1
@Video1
プロンプト
Refer to the special effects shown in @Video1 to generate identical wings for the girl in @Image1, ensuring the wing formation trajectory follows the exact same motion path and sequence depicted in the video.
要素の追加、削除、変更
追加、削除、または差し替えです。編集では "reference" と書かないでください。言及していない部分は、そのまま残ります。
参照素材
@Video1
プロンプト
Add snacks such as fried chicken and pizza to the countertop in @Video1.
参照素材
@Video1
プロンプト
Remove everything that isn't office supplies from the table in @Video1, keeping the rest of the video content unchanged.
参照素材
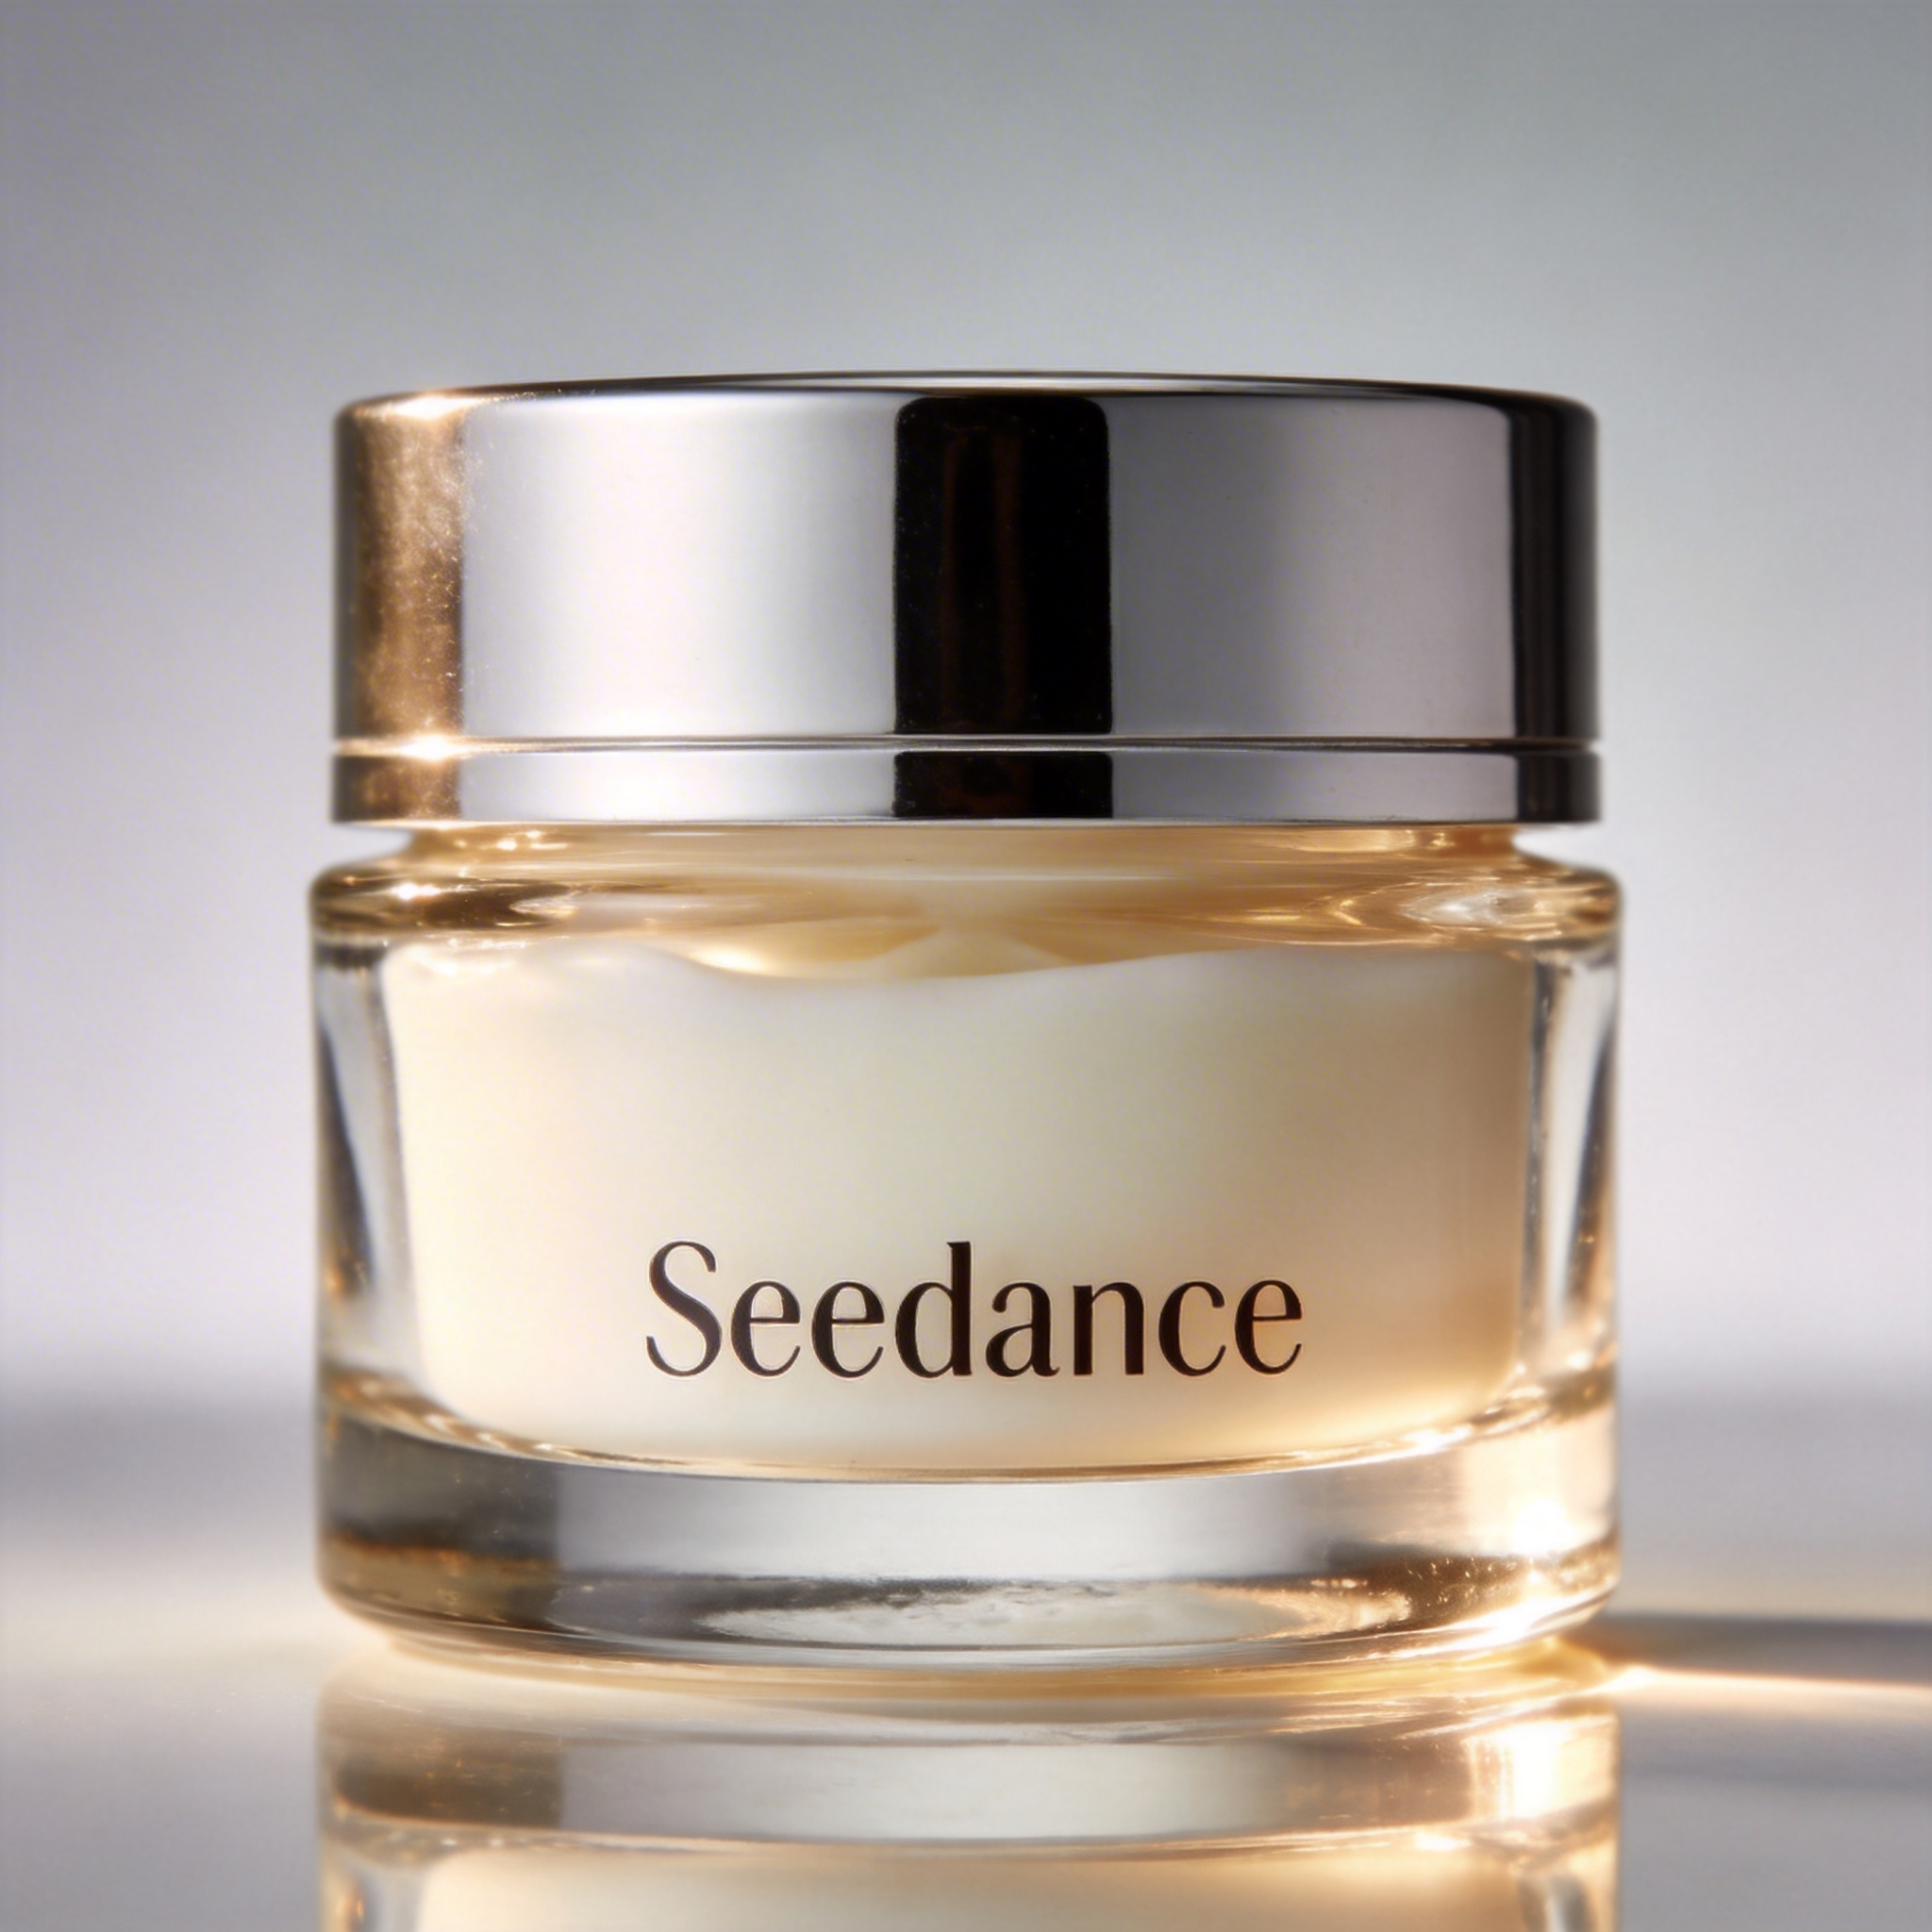
@Image1
@Video1
プロンプト
Replace the perfume featured in @Video1 with the face cream from @Image1, with all original motions and camera work preserved.
動画を延長する
前方への延長は、動画のあとの内容を生成します。後方への延長は、動画の冒頭の区間を延長します。
参照素材
@Video1
プロンプト
Generate the content after @Video1: the two men who are late run towards them, the five people finally meet and have a friendly chat.
参照素材
@Video1
プロンプト
Extend the opening segment of @Video1: Set up an over-the-shoulder shot of the man in a hoodie, and the man says: "It's not that bad. You're just stressed. Everyone goes through this, you just need to keep going."
トラックを補完する
@Video1、それから橋渡し、続いて @Video2。
参照素材
@Video1
@Video2
プロンプト
@Video1. The moment a leaf falls to the ground, it sets off a special effect of golden particles. A gust of wind blows by, leading into @Video2.
一覧で見る上限
| Seedance 2.0 ファミリー | |
|---|---|
| 参照画像 | 最大 9 |
| 参照動画 | 最大 3、各 2〜15 秒、合計 15 秒 |
| 参照音声 | 最大 3、各 2〜15 秒、合計 15 秒 |
| 出力の長さ | 4〜15 秒 |
| 出力解像度 | 2.0:480p〜4K。Fast と Mini:480p / 720p |
参照動画は、480p または 720p、24〜60 fps であるべきです。