Это руководство опирается на официальный стандарт и дополняет его. Оно подходит для семейства Seedance 2.0 (2.0, 2.0 Fast и 2.0 Mini). Хороший промпт даёт Seedance показать эффект.
Базовая формула
Серия моделей Seedance 2.0 поддерживает одновременную опору на мультимодальные ассеты, такие как видео, изображения и аудио. Она может точно зафиксировать характеристики вроде внешности персонажа, эффектов действия, визуального стиля и тембра закадрового голоса, сильно снижая порог написания промптов. На этой основе ведите модель простой базовой формулой, используя свойства мультимодальных ассетов, чтобы быстро получать видео под конкретные требования.
Генерация видео на основе референсов делится на три типа задач: омни-референс (omni reference), редактирование видео и продление видео. Выберите базовую формулу промпта по типу задачи. Три типа можно и сочетать.
Омни-референс
Извлеките из ассета некоторые элементы (например, субъект, стиль, сцену и звуковые эффекты), чтобы сгенерировать совершенно новое видео.
Применимые сценарии: перенос действия, повторное использование субъекта, референс атмосферы и похожие задачи.
Рекомендуемые шаблоны:
- Референс изображения: опирайтесь на субъект в
@Image1, чтобы сгенерировать… - Референс видео: опирайтесь на движение в
@Video1, чтобы сгенерировать… - Референс аудио: опирайтесь на тембр в
@Audio1, чтобы сгенерировать…
В этой студии омни-референс (omni reference) — это Мульти-референс. Введите @ в поле промпта и выберите файл. Он вставляется как @Image1, @Video1 или @Audio1, с номером по порядку загрузки внутри этого вида. Каждая миниатюра показывает свой токен. Если удалить файл, оставшиеся токены этого вида перенумеровываются. Шаблон выше всё равно должен сказать, какой элемент вы берёте. Один токен не сообщает модели, нужны ли вам лицо, движение, стиль или тембр.
Редактирование видео
Вносите частичные или глобальные изменения на основе исходного видео. Части, которые не названы, по умолчанию остаются без изменений.
Применимые сценарии: локальная замена, удаление субъекта, изменение атрибута и похожие задачи.
Рекомендуемые шаблоны:
- Добавление элементов: ясно опишите
@Video1+ новый элемент + где он находится. - Изменение элементов: строго редактируйте
@Video1и замените в нём один элемент другим. - Удаление элементов: укажите элементы, которые нужно удалить. Элементы, которые должны остаться без изменений, подчеркните в промпте: так результат лучше.
Продление видео
Продолжите исходное видео вдоль оси времени, требуя, чтобы аудиовизуальный стиль, субъект и повествование оставались согласованными.
Применимые сценарии: продолжение сюжета, продление действий, завершение клипов и похожие задачи.
Рекомендуемые шаблоны:
- Продлить видео: продлите
@Video1вперёд или назад, чтобы сгенерировать… - Достройка дорожки:
@Video1+ что происходит, затем@Video2+ что происходит дальше.
Для задач редактирования и продления ссылайтесь на видео прямо: "strictly edit @Video1", "extend @Video1 forward". Не пишите "reference @Video1" для этих задач. "Reference" — это шаблон омни-референса (omni reference), и модель может прочитать правку или продление как совершенно новый клип.
Изображение в видео — отдельный режим. Первый кадр и последний кадр нельзя смешивать с файлами референса в одной генерации. Первый кадр — это начало, и соотношение сторон следует этому изображению. Включите Добавить последний кадр, когда конечный кадр тоже должен быть зафиксирован, и опишите только то, что происходит между двумя кадрами. Включите Вернуть последний кадр до генерации. Когда клип готов, Продолжить отсюда использует этот последний кадр как первый кадр следующего клипа, так что стык закреплён за картинкой. Это способ этой студии продолжать с фиксацией кадра. Официальная формула продления по-прежнему действует, когда источник — видео в Мульти-референс.
Комбинированные задачи
Три типа задач выше можно использовать и вместе.
Применимые сценарии: опереться на один ассет и отредактировать другой ассет.
Рекомендуемый шаблон фразы: опирайтесь на [Измерение_Референса] из @Video1, строго редактируйте @Video2, [Конкретные_Правки].
[Измерение_Референса] — это одна вещь, которую вы берёте из первого файла, например движение камеры, эффект или тембр. [Конкретные_Правки] — единственное изменение, которое вы хотите во втором файле. Всё, что вы не назвали в правке, остаётся.
Продвинутая формула
Seedance 2.0 по сути мультимодальный ИИ-режиссёр: он одновременно читает ваши текстовые промпты, изображения, видео и аудио и внутри раскладывает их на два измерения — пространственный слой (spatial layer, что находится в кадре) и временной слой (temporal layer, как вещи меняются во времени), — чтобы понимать и порождать изображение.
Хороший промпт — это не просто описание в духе рекламного текста, а инструкция инженерного типа: кто, в какой сцене, какое действие совершает, как движется камера и в каком хронологическом порядке происходят события, передаётся соответственно пространственному слою (spatial layer) и временному слою (temporal layer).
1. Определите субъект
В реальном референсном ассете одно изображение часто содержит несколько субъектов. Чтобы точно сослаться на конкретный объект в ассете, субъект нужно ясно определить. Субъектом может быть человек, реквизит, сцена и так далее.
Базовое определение
Требования к ключевым чертам: используйте 2–3 ясные и устойчивые статические черты (например, одежду, причёску, внешность или категорию), чтобы описать субъект и обеспечить его однозначное узнавание.
Примеры:
- Определите женщину в красном платье и соломенной шляпе в
@Image1как Subject 1. - Определите женщину в красном платье и соломенной шляпе в
@Image1как Zhang Hong.
Один субъект в нескольких материалах
Когда объекты в нескольких ассетах относятся к одному субъекту, свяжите их согласованно. Напишите, что лицо в @Image1 и фото в полный рост в @Image2 — это один и тот же человек.
Сценарий с несколькими субъектами
Когда в видео появляется несколько субъектов, определите их по отдельности и различайте метками. Метки должны быть уникальными и устойчивыми, а соответствующие метки нужно последовательно использовать в дальнейших описаниях, чтобы избежать неоднозначности референса.
Пример: определите высокого мужчину в @Video1 как полицейского, а другого, невысокого мужчину — как вора. Сцена происходит на многолюдном дневном рынке, с ярким солнцем, множеством фруктовых лотков и плотным потоком пешеходов, что создаёт оживлённую атмосферу уличного рынка. Вор в панике бежит вперёд через многолюдный рынок, а полицейский вплотную преследует его на полной скорости. Оба быстро лавируют между лотками. Ручная камера быстро едет вперёд, с лёгкой реалистичной тряской камеры, создавая напряжённую атмосферу погони.
Каждый раз, когда субъект участвует, на него нужно явно сослаться, чтобы ничего не пропустить. Поддерживаются два употребления:
- В простых сценариях с неопределёнными субъектами при каждом упоминании субъекта используйте @, чтобы подчеркнуть связь субъекта с ассетом. Например: Zhang San
@Image1. - В сценариях, где субъекты определены заранее, при каждом упоминании субъекта используйте ту же метку. После того как высокий мужчина в
@Video1определён как полицейский, а невысокий — как вор, дальнейшие фразы говорят «полицейский» и «вор», а не "the tall one" и "the other man".
Когда вы используете id из библиотеки ассетов, вам всё равно нужны @Image1 или @Video1, чтобы сослаться на субъект. Модель не может напрямую связать id ассета с содержимым референса, поэтому нельзя подставлять id ассета вместо токена файла.
Держите описания как можно короче, избегайте избыточности и смысловых конфликтов, например противоречивых черт одного и того же субъекта. Пространственные отношения сначала выражайте через референсные изображения, сокращая сложные текстовые описания.
Для человека достаточно крупного плана лица плюс фотографии в полный рост. Изображения персонажа multi-view здесь не рекомендуются, потому что лист turnaround — частая причина ID drift.
2. Последовательность кадров
Внутреннее моделирование модели разделяет пространство и время. Поэтому идеальная форма промпта для сложного видео — раскадровка по временной шкале: разбейте видео на несколько кадров-планов и динамически опишите каждый в порядке событий: кто + где + что делает + как движется камера.
Используйте порядок планов. Напишите простую раскадровку Shot 1 / Shot 2 / Shot 3 для каждого сегмента видео, а затем соедините их в полный промпт.
Отрицательный пример: "A man runs nervously down the street, and the scene feels very cinematic."
Положительный пример:
- Shot 1: боковой план уличного переулка; мужчина медленно начинает бежать, с ощущением частого дыхания.
- Shot 2: мужчина опрокидывает фруктовый лоток; камера быстро трясётся и даёт крупный план испуганного лица мужчины.
- Shot 3: мужчина перелезает через низкую стену и исчезает; камера медленно отъезжает и замирает на пустой улице.
Используйте идентификаторы вроде Shot 1, Shot 2 и Shot 3, чтобы упорядочить содержание в порядке событий: сначала главное, потом второстепенное. Не задавайте жёстких пределов длительности каждого сегмента. Отдайте приоритет тому, чтобы модель естественно задавала темп по сюжету. Поддержка моделью точного тайминга, например 0–3 секунды, нестабильна, и принудительное ограничение длительности может привести к аномальным результатам генерации.
Выстраивайте каждый план в таком порядке:
- Движение камеры или способ перехода плана, например "slowly push in from a wide shot", "fixed camera position", "cut to…".
- Действия и выражения субъекта. Опишите ключевые действия и изменения выражения главного персонажа или объекта.
- Положение или пространственные изменения. Объясните сцену, положение или пространственное отношение, в котором находится субъект.
- Аудиоинформация. Опишите звуковые эффекты, голоса и фоновую музыку, соответствующие плану.
3. Требования к описанию действия
Уточнение движения тела + количественная степень. Действия должны быть конкретны для частей тела, таких как руки, ноги, голова, плечи и спина, и дополнены описанием амплитуды, скорости и силы. Примеры: медленно поднять руку, быстро повернуть голову, сильно оттолкнуться от земли, слегка опустить голову.
Отдавайте приоритет медленным, мягким, непрерывным мелким движениям. Отдавайте приоритет медленным, мягким, связным тонким движениям и старайтесь избегать действий с высоким выбросом и большой динамикой, таких как спринт, большие прыжки и резкие кувырки. Примеры: медленно идти, мягко поднять руку, слегка опустить голову, естественно сесть вместе с движением.
Дополняйте переходы между действиями. Укажите инерцию и непрерывность между предыдущим и следующим действием, чтобы движение на экране было связным и естественным. Примеры: использовать инерцию поворота, чтобы естественно поднять руку, естественно перейти от паузы к поднятию руки.
Конкретное внешнее выражение эмоций. Используйте конкретные физические детали, чтобы выразить эмоции, заменяя абстрактные слова вроде "very sad" и "extremely angry."
| Абстрактная эмоция | Выражена действиями и деталями |
|---|---|
| Грусть | опущенная голова, плечи слегка дрожат, глаза краснеют, пальцы бессознательно сжимают край одежды, слёзы наворачиваются, но не падают |
| Радость | уголки рта неконтролируемо поднимаются, брови и глаза расслабляются, шаг становится лёгким, бессознательно напевает мотив, не может удержаться и кружится на месте |
| Нервозность / тревога | часто смотрит на часы, пальцы непрерывно стучат по столешнице, частое дыхание, глаза отводят взгляд, бессознательно кусает ногти |
| Гнев | оба кулака сжаты, линия челюсти напряжена, грудь сильно вздымается, глаза острые как ножи, слова выдавливаются сквозь стиснутые зубы |
| Облегчение | длинный выдох, напряжённые плечи полностью расслабляются, на лице появляется давно потерянная слабая улыбка, взгляд вверх вдаль |
4. Промпты движения камеры
Модель хорошо понимает термины движения камеры, поэтому можно прямо использовать стандартную терминологию, например "medium shot, close-up, wide shot, slow push-in, smooth lateral tracking, fixed shot."
Старайтесь указывать только 1 тип движения камеры в одном плане. Не требуйте одновременно push, pull, pan и move: это увеличивает нестабильность изображения.
5. Качество изображения, стиль и слова-ограничения
Качество изображения, стиль и слова-ограничения — ключ к управлению результатом генерации видео. Они могут задать модели творческие границы, выровнять качество изображения и художественный тон и избежать визуальных дефектов и случайных отклонений, поэтому это необходимая настройка для стабильного и допустимого итога.
- Качество изображения. Задайте чёткость изображения, детальные текстуры и качество света, чтобы поднять базовое качество изображения итогового видео. Примеры: HD, богатые детали, кинематографическая фактура, естественные цвета, мягкий свет.
- Стиль. Задайте общий художественный стиль и визуальный тон, чтобы выровнять художественную атмосферу изображения. Примеры: холодный сине-фиолетовый тон киберпанка, ретроплёнка, свежий японский стиль.
- Слова-ограничения. Слова-ограничения очень важны. Они эффективно помогают избежать визуальных дефектов, деформаций, срывов и неразумных элементов и ограничивают границы генерации и устойчивость.
Типовые шаблоны слов-ограничений:
- Избегать генерации субтитров: "keep it subtitle-free", "avoid generating any text or subtitles".
- Избегать генерации логотипа: "do not generate a logo".
- Избегать генерации водяного знака: "do not generate a watermark".
6. Кейсы
Эти два примера показывают, как пользоваться продвинутой формулой выше. Произнесённые реплики остаются внутри {} — это знак диалога из стандарта специальных символов.
Пример 1: Эмоциональная короткометражка в общежитии (с упором на диалог)
Подготовка ассетов:
@Image1: фото главной героини по пояс@Image2: референсное изображение сцены общежития@Video1: референс движения камеры для диалога в помещении (dolly in/out средним планом или лёгкий pan)@Audio1: комнатный окружающий звук или лёгкая музыка
Use the girl in @Image1 as the main character, use @Image2 as the dormitory scene style reference, and refer to the camera movement in @Video1.

Shot 1: At dusk, girl @Image1 walks briskly to the dormitory entrance @Image2. The camera follows steadily in a medium shot. Warm yellow sunlight spills into the hallway from the window. She pauses at the doorway, takes a deep breath, and looks slightly nervous.

Shot 2: Girl @Image1 pushes the door open and enters the dormitory. The camera cuts to an indoor medium shot. Her roommates look up at her while organizing their books. One of them smiles and asks {How did the exam go? Did you pass?}. The camera slowly cuts between half-body close-ups of several people.

Shot 3: Girl @Image1 first lowers her head with a dejected expression. The camera gives her a close-up. Then she raises her head, unable to hold back a smile, laughs out loud, and says {I was kidding}. Her roommates start chasing and play-fighting with her. The camera slowly pulls back and freezes on a wide shot of the dormitory filled with laughter.

The entire video should have a high-definition cinematic documentary style, with warm tones and soft lighting. The character's face remains stable without deformation; movements are natural and smooth, with no stutter or flicker. The ambient sound blends naturally with @Audio1.
Пример 2: Противостояние на утёсе в старинном стиле (с упором на действие/атмосферу)
Подготовка ассетов:
@Image1: главная героиня в красном@Image2: убийца в чёрном (противница)@Image3: изображение сцены утёса и бамбукового леса@Video1: референс движения камеры для боевого противостояния@Audio1: плотные удары барабана или звуковые эффекты схватки
Use the woman in red from @Image1 as the female lead, use the woman in black from @Image2 as the opponent, use the cliff and bamboo forest environment in @Image3 as the scene reference, refer to the overall camera movement and action rhythm in @Video1, and synchronize the background sound effects with @Audio1.

Shot 1: At dusk, the camera slowly pushes in from a side medium shot of woman in red @Image1. She stands at the edge of the cliff and lifts a wine flask to drink. Her sleeves and robe hem sway gently in the mountain wind. The camera circles halfway around her, moving from the front to her back. In the distance, a figure in black is faintly visible in the bamboo forest.

Shot 2: The camera zooms and fades into a long shot. From a drone perspective, it overlooks the entire cliff and bamboo forest. The two characters stand at opposite ends of the cliff. The mountain wind lifts their robe hems and dust, and the rhythm slightly accelerates with the drum beats.

Shot 3: The camera cuts back to a ground-level close shot. The two slowly draw their swords and face off. Woman in red @Image1 shifts from a careless expression to a cold gaze. Woman in black @Image2 looks determined, and the sword tip trembles slightly. The camera steadily follows the two as they circle each other, finally freezing on a close-up of the instant before the two swords meet.

The overall visual style should feel like a cinematic wuxia world in misty rain, with cool tones, low saturation, a film-grain texture, and rich light-and-shadow layers. The characters' faces and body proportions remain stable without deformation. Movements are continuous and natural, not stiff, with no clipping or stutter.
Другие советы
Генерация текста
Модели серии Seedance 2.0 поддерживают генерацию обычного текста. Модель может автоматически подобрать уместный стиль и цвет по контексту, а также позволяет указать в промпте цвет, стиль, способ появления, момент появления и положение появления текста. При письме отдавайте приоритет обычным знакам и избегайте редких знаков и специальных символов, чтобы презентация была наилучшей. Сейчас поддерживаются сценарии вроде рекламных слоганов, субтитров и речевых пузырей. Кейсы — в последнем разделе.
Шаблон промпта слогана: [Содержание_Текста] + [Время] + [Позиционирование] + [Стиль_Входа/Появления], [Визуальные_Атрибуты (Цвет, Стиль_Шрифта)].
Seedance 2.0 может подобрать уместный стиль текста по контексту. Если к подаче текста есть строгие требования, используйте пример логотипа в разделе референса нескольких изображений.
Шаблон промпта субтитров: показывайте субтитры внизу по центру вместе с текстом. Субтитры должны быть идеально синхронизированы с ритмом и темпом аудио.
Продление видео и сегментный монтаж
- Непрерывный длинный план (продление видео): подходит для диалоговых сцен внутри одной сцены, таких как долгие разговоры, нарастание эмоции и движение вдоль одного пути, чтобы получить погружающий и связный эффект одного дубля.
- Повороты сцены / действия (сегментный монтаж): подходит для сюжетных поворотов или сложных быстрых экшен-сцен, таких как погони, схватки и монтажные склейки. Можно сгенерировать независимые клипы, а затем смонтировать их вместе, чтобы сохранить ритм и визуальный удар.
В реальном производстве оба метода обычно сочетают. Например, сначала продлением сгенерируйте связный разговор, затем вмонтируйте пустые планы или переходные клипы, уравновешивая погружение и ритмическое разнообразие.
Стратегия конфигурации ассетов
Ассеты обычно делятся на четыре функциональные роли:
- Закрепление персонажа: фиксирует внешность персонажа.
- Задание тона сцены: фиксирует среду и стиль.
- Референс движения камеры: фиксирует язык планов и ритм действий.
- Ритмическая атмосфера: используйте аудио, чтобы управлять эмоцией и тембром.
Рекомендуемая конфигурация, всего 4–5 ассетов: 1–2 изображения персонажа (крупный план лица / полный рост) + 1 изображение сцены + 1 видео движения камеры + 1 аудиоклип.
Использовать полный лимит ассетов не рекомендуется. Слишком много ассетов затрудняет модели оценку приоритета признаков, из-за чего легко возникают конфликты стиля, размытое узнавание субъекта и результаты, отклоняющиеся от ожиданий.
В семействе Seedance 2.0 аудио нельзя сочетать только с текстом. Добавьте хотя бы одно изображение или видео вместе с аудио.
На что обратить внимание
Языковые нормы
Язык диалога должен быть единым, а смешения китайского и английского следует избегать, кроме имён собственных.
Нормы специальных символов
Разумное использование символов в промптах помогает модели точно понимать разные типы информации.
| Тип информации | Символ | Пример |
|---|---|---|
| Музыка | () | (fast-paced rock music is playing in the background) |
| Звуковой эффект | Официальная таблица оставляет этот символ открытым. Опишите звук словами, в аудиостроке плана. | |
| Диалог | {} | {Hello, world}. Если диалог на менее распространённом языке, не китайском и не английском, язык нужно пометить, например: says in Japanese {こんにちは} |
| Субтитры | 【】 | 【Chapter One: Departure】 |
FAQ
Неточный референс лица
Типичные симптомы. Внешность сгенерированного персонажа не совпадает с референсным изображением, либо в середине видео происходит подмена лица (ID drift), из-за чего персонаж в видео становится похож на знаменитость и блокируется на проверке.
Корневая причина. Референсное изображение лица недостаточно действенно.
- Смешанные референсные изображения. Модели дано одно составное изображение, которое включает референс лица, референс позы в полный рост или по пояс, референс костюма, референс детали и другие элементы референса.
- Доля лица слишком мала. В смешанных референсных изображениях область лица занимает слишком малую долю всего изображения. При извлечении черт лица модель придаёт им недостаточный вес и легко отвлекается на фон или другие элементы.
Решение. Усильте самостоятельность и вес референса лица.
- Подготовьте крупный план лица. Кроме исходной фотографии в полный рост подготовьте дополнительный крупный план, содержащий только голову персонажа. Headshot, на котором остаётся только лицо. Лучше всего без выражения. Сведите к минимуму мешающие элементы, такие как плечи, шея и фон.
- Ясно определите субъект в промпте: черты лица опираются на headshot, макияж и укладка опираются на фотографию в полный рост.
- Важные ассеты ставьте первыми. Чем точнее ассет требует опоры, тем раньше он должен стоять в промпте.
Для референсов персонажа достаточно headshot + фотографии в полный рост. Изображения персонажа multi-view не рекомендуются. Ассеты multi-view содержат разные ракурсы одного персонажа, и модель легко принимает их за несколько разных субъектов, что, напротив, усиливает проблему ID drift.
До: персонаж в видео меняет лицо на середине и похож на знаменитость. После: лицо остаётся согласованным с референсным изображением на всём протяжении.
Исправление
Prepare a close-up face image containing only the character's head, in addition to the full-body photo. No expression is best. Minimize shoulders, neck, and background. In the prompt: facial features reference the headshot, makeup and styling reference the full-body photo. Place the asset that needs precise reference earlier. A headshot plus a full-body photo is sufficient. Multi-view character images are not recommended: the model may identify them as multiple different subjects, which worsens ID drift.
В видео появляются неожиданные субтитры
Типичные симптомы. Промпт не просил субтитры, но сгенерированное видео содержит субтитры.
Решение. Напрямую избежать генерации субтитров на 100% нельзя. Можно только снизить вероятность и повысить долю успеха.
- Добавьте в промпт явные инструкции-ограничения: "Keep it subtitle-free" и "Avoid generating any text or subtitles".
- Если референсное изображение или видео содержит несущественный текст, сначала удалите текст редактированием изображения или видео, а затем используйте ассет без текста как вход.
- Если ваш сценарий это позволяет, отдавайте приоритет генерации видео в альбомном размере. Вероятность субтитров в альбомной ориентации заметно ниже, чем в портретной. Позже его можно обрезать до портрета в редакторе.
В видео появляется логотип или водяной знак
Типичные симптомы. Промпт не упоминал содержание, связанное с водяным знаком, но сгенерированное видео содержит логотип или водяной знак другой видеоплатформы.
Решение. Добавьте в промпт явные инструкции-ограничения: "Do not generate watermarks" и "Do not generate Logos".
Дрейф стиля
Типичные симптомы. Вы ожидаете стиль аниме 2D или 3D, но стиль входного референсного изображения сравнительно реалистичен, а промпт не подчёркивает стиль видео. В результате сгенерированное видео может уйти в реалистичный стиль live-action.
Решение. Добавьте в промпт явные слова ограничения стиля, например "2D Japanese anime style" или "3D Chinese-style comic". Если нужен более точный контроль стиля, сначала переведите референсное изображение в целевой стиль, а затем генерируйте видео.
До: стиль xianxia уходит в стиль live-action. После: сохраняется стиль xianxia китайской 3D-анимации CG.
Промпт
Add an explicit style constraint, such as "2D Japanese anime style" or "3D Chinese-style comic". The after example maintains the 3D Chinese animation CG xianxia style. If more precise style control is required, first convert the reference image into the target style, then generate the video.
Скачки на точках перехода продления видео
Типичные симптомы. После того как продление видео породило новое видео, при склейке нового видео с исходным на стыке могут быть скачки кадров или откат содержания.
Решение. Сейчас рекомендуется чинить это на постмонтаже, выравнивая ключевые кадры. Фундаментальная оптимизация придёт с будущими итерациями модели.
- Импортируйте видео для склейки в CapCut или другое профессиональное ПО видеомонтажа.
- На первом стыке обрежьте 6 кадров с конца предыдущего сегмента видео.
- Одновременно обрежьте 1 кадр с начала следующего сегмента видео.
- Повторите эти операции для всех точек склейки.
- Экспортируйте и проверьте плавность склеенного видео.
После выравнивания кадров видео лёгкие скачки ещё могут остаться. Рекомендуется заканчивать более ранний клип в момент переходного реза и начинать следующее видео с новой сцены после этого реза.
До: в точках перехода возникают мгновенные скачки экрана или откат содержания. После: переходы плавнее.
Исправление
Repair the join in post-editing by aligning keyframes. At the first join, trim 6 frames from the end of the previous video segment, and trim 1 frame from the beginning of the following video segment. Repeat for all stitching points.
Дублированные персонажи
Типичные симптомы. В сценариях, где в кадре много персонажей и в качестве референсных ассетов даны изображения персонажа three-view, в одном сгенерированном кадре видео легко появляются два одинаковых персонажа.
Корневая причина.
- Субъекты персонажей неясно определены в промпте, поэтому модель не может точно различить разные роли.
- Когда изображения персонажа three-view или multi-view используются как референсные ассеты, легко сбить распознавание персонажей моделью, и она порождает дубликаты одного и того же облика.
Решение. Напрямую избежать проблемы двойников на 100% нельзя. Следующие методы могут только снизить вероятность и повысить долю успеха.
- Ясно задайте связи персонажа и субъекта. Ясно определите каждую роль в промпте и укажите соответствие ролей и референсных изображений. После каждого имени персонажа отметьте соответствующее референсное изображение и держите формат единым. Пример: Zhang San (соответствует image 1) бросает зелёную сберкнижку в сторону Li Si (соответствует image 2), который стоит.
- Добавьте глобальные инструкции-ограничения. Добавьте в конец промпта фиксированное ограничение: на протяжении всего видео персонажи с полностью одинаковой внешностью, одеждой и аксессуарами запрещены. Не генерируйте дублирующиеся аватары и эффект двойников. В одном кадре оставляйте только одного соответствующего персонажа и не воспроизводите повторные копии персонажей.
- Оптимизируйте референсные ассеты. Для референсных изображений персонажей отдавайте приоритет самостоятельным фотографиям одного человека. Ассеты three-view или multi-view не рекомендуются.
- Упростите и оптимизируйте промпт. Не используйте полный сценарий напрямую как промпт. Слишком избыточный текст легко вызывает путаницу в понимании модели. Уберите не относящиеся к делу описания и сделайте инструкции ясными и сосредоточенными.
До: в видео появляются двойники. После: один человек на роль.
Исправление
Clearly define each character role and the corresponding reference image, and keep the format consistent. Example: Zhang San (corresponding to image 1) throws the green passbook toward Li Si (corresponding to image 2), who is standing. At the end of the prompt: Throughout the video, characters with completely identical appearance, clothing, and accessories are prohibited. Do not generate duplicate avatars or a twin effect. Keep only a single corresponding character in the same frame, and do not reproduce repeated copies of characters. Prioritize independent single-person photos. Three-view or multi-view assets are not recommended. Do not paste the complete script as the prompt.
Падение качества изображения при продлении видео
Типичные симптомы. Когда видео, сгенерированное моделью, используется как входной ассет для продления и продолжения, качество изображения падает. Несколько продолжений накапливают падение, а пятнистые цветовые блоки особенно легко появляются в областях лица персонажей.
Решение. Следующие методы могут смягчить падение качества изображения. Фундаментальная оптимизация будет проведена позже через итерации модели.
- Преобразуйте исходное видео в белое модельное видео, а затем используйте его как входной ассет для продолжения. Референсный промпт: преобразуйте видео в белую 3D-модель (white 3D model). Все персонажи должны быть унифицированы как чисто белые 3D-модели, без цвета, без текстуры и без теней; используйте чисто белый фон, устойчивую структуру и плавное движение.
- Отдавайте приоритет изображениям высокой чёткости как референсным ассетам.
- Разумно ограничивайте число продолжений видео и избегайте повторных наложенных продолжений.
До: продолжение напрямую по выходу модели. После: выход модели преобразуют в белое модельное видео перед продолжением.
Промпт
Convert the video into a white 3D model. All characters should be unified as pure white 3D models, with no color, no texture, and no shadows; use a pure white background, stable structure, and smooth motion. Then continue from that white-model video. Prioritize high-definition images as reference assets, and avoid repeated stacked continuations.
Спецэффекты не соответствуют ожиданиям
Типичные симптомы. Когда конкретный спецэффект описан текстом промпта, эффект может не совпасть с ожиданием. Например, если промпт задаёт, что число "2999" появляется с анимацией обратного отсчёта, реально сгенерированный эффект прокрутки чисел может прыгать случайно и не следовать стандартной логике отсчёта.
Решение. Используйте референсное видео, чтобы задать спецэффект. Подайте целевое видео спецэффекта в модель как референсный ассет, чтобы модель точно поняла форму эффекта и логику движения, и сгенерированный результат лучше совпал с ожиданием. Например: способ появления числа "2999" должен опираться на @Video1.
До: эффект прокрутки чисел имеет явный смысл беспорядочных скачков. После: после добавления правильного видео эффекта прокрутки чисел результат эффекта соответствует ожиданию.
Референсы
@Video1
Промпт
The way the number "2999" appears should reference @Video1.
Слишком много референсных персонажей
Типичные симптомы. Когда число референсных людей превышает 4, устойчивость выхода модели падает, и сгенерированное видео может иметь проблемы вроде неверного числа людей (например, слишком мало или слишком много персонажей) или дублированных персонажей.
Решение. Это можно смягчить следующими способами. В будущем фундаментальная оптимизация будет проведена на основе итераций модели.
- Генерируйте изображения по шагам. Сгруппируйте людей так, чтобы число людей на каждом сгенерированном изображении не превышало 4. Например, 6 человек можно разделить на 2 группы по 3 человека и сгенерировать изображения отдельно.
- Генерируйте видео из изображений. Используйте несколько сгруппированных изображений из первого шага как референсные ассеты, затем сгенерируйте итоговое видео.
До: на вход подают 8 референсных персонажей, а выходное видео содержит 9 человек. После: из 8 персонажей генерируют 2 изображения, затем используют переход от изображения к видео.
Исправление
When the number of reference people exceeds 4, group them so that each generated image contains no more than 4 people. For example, 6 people can be divided into 2 groups of 3. Generate those images first, then generate the video from the grouped images.
Шум в конце видео
Типичные симптомы. Когда видео содержит закадровый текст, в конце видео легко появляются резкие щелчки и шум обрыва.
Решение. Сгенерируйте видео заново или используйте редактор вроде CapCut, чтобы через volume envelope применить затухание аудио к конечной аудиодорожке и убрать шум обрыва.
Конкретные шаги, на примере CapCut:
- Импортируйте сгенерированное видео в CapCut.
- Выберите видеодорожку на таймлайне и нажмите Audio на панели инструментов.
- Выберите функцию Volume envelope. В некоторых версиях она находится в меню Basic / Adjust. Выберите ключевые кадры. На аудиодорожке появится линия, представляющая громкость и ключевые кадры.
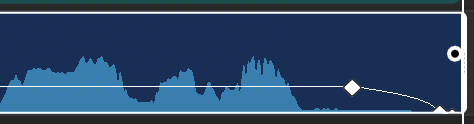
- Ближе к концу видео перетащите последний ключевой кадр громкости вниз до громкости 0, чтобы образовался спад. Кривая на карточке — это этот спад.
- Просмотрите превью и подтвердите, что конечное аудио затухает естественно, без резких обрывов и шума.
До: в конце есть шум. После: в конце шума нет.
Референсы
@Image1
Исправление
Regenerate the video, or fade the ending audio to silence with a volume envelope. Near the end, drag the final volume keyframe down to 0 so the curve in @Image1 forms a downward slope.
Неточное китайское произношение
Типичные симптомы. Модель склонна неверно произносить многозначные иероглифы, редкие иероглифы и иероглифы похожей формы.
Решение. Текст, который легко прочитать неверно, можно заменить общеупотребительными омофонами с тем же произношением, чтобы избежать отклонений произношения и вернуть ожидаемый аудиоэффект. Это решение — только метод оптимизации, и оно не может полностью избежать всех проблем произношения.
Пример: в промпте можно переписать "螭龙山" омофоном "吃龙山".
До: произношение "螭" в "螭龙山" неверно. После: после замены на "吃龙山" произношение верно.
Промпт
Replace text that is easy to misread with a commonly used homophone of the same pronunciation. Rewrite "螭龙山" as "吃龙山". This is an optimization and cannot completely avoid all pronunciation issues.
Неточный референс голоса
Типичные симптомы. Когда референсное аудио задаёт голос, голосовое аудио в итоговом сгенерированном видео заметно отличается от референсного голоса.
Решение.
- Добавьте в промпт подробные описания характеристик голоса. Рабочая строка в этом примере: используйте низкий, густой, тёплый и мелкозернистый голос мужчины средних лет из
@Audio1. - Держите стиль реплик видео близко к тону и стилю выражения референсного аудио: это помогает улучшить восстановление голоса и устойчивость.
В Мульти-референс этот файл — @Audio1. В семействе Seedance 2.0 соедините аудио хотя бы с одним изображением или видео.
До: голос не совпадает с входным аудио. После: после добавления в промпт описаний характеристик голоса точность совпадения голоса заметно растёт.
Референсы
@Audio1
Промпт
Use the low, thick, warm, and finely grainy middle-aged male voice of @Audio1. Keep the style of the lines close to the tone and expression of that reference audio.
Примеры промптов
Этот раздел показывает официальные примеры промптов для генерации текста, референса изображения, референса видео и редактирования видео. Промпт на каждой карточке сохраняет официальную фразу. Произнесённые реплики и слова на экране не изменены. @Image1, @Video1 и @Audio1 — токены этой студии для Image 1, Video 1 и Audio 1. Там, где официальный промпт говорит Image 1, Image 2 и Image 3, это подписи на одном референсном листе, и этот лист — один файл @Image1.
Слоганы
Шаблон промпта: [Содержание_Текста] + [Время] + [Позиционирование] + [Стиль_Входа/Появления], [Визуальные_Атрибуты (Цвет, Стиль_Шрифта)].
Seedance 2.0 может подобрать уместный стиль текста по контексту. Если к подаче текста есть строгие требования, используйте пример логотипа в разделе референса нескольких изображений.
Референсы
@Image1
Промпт
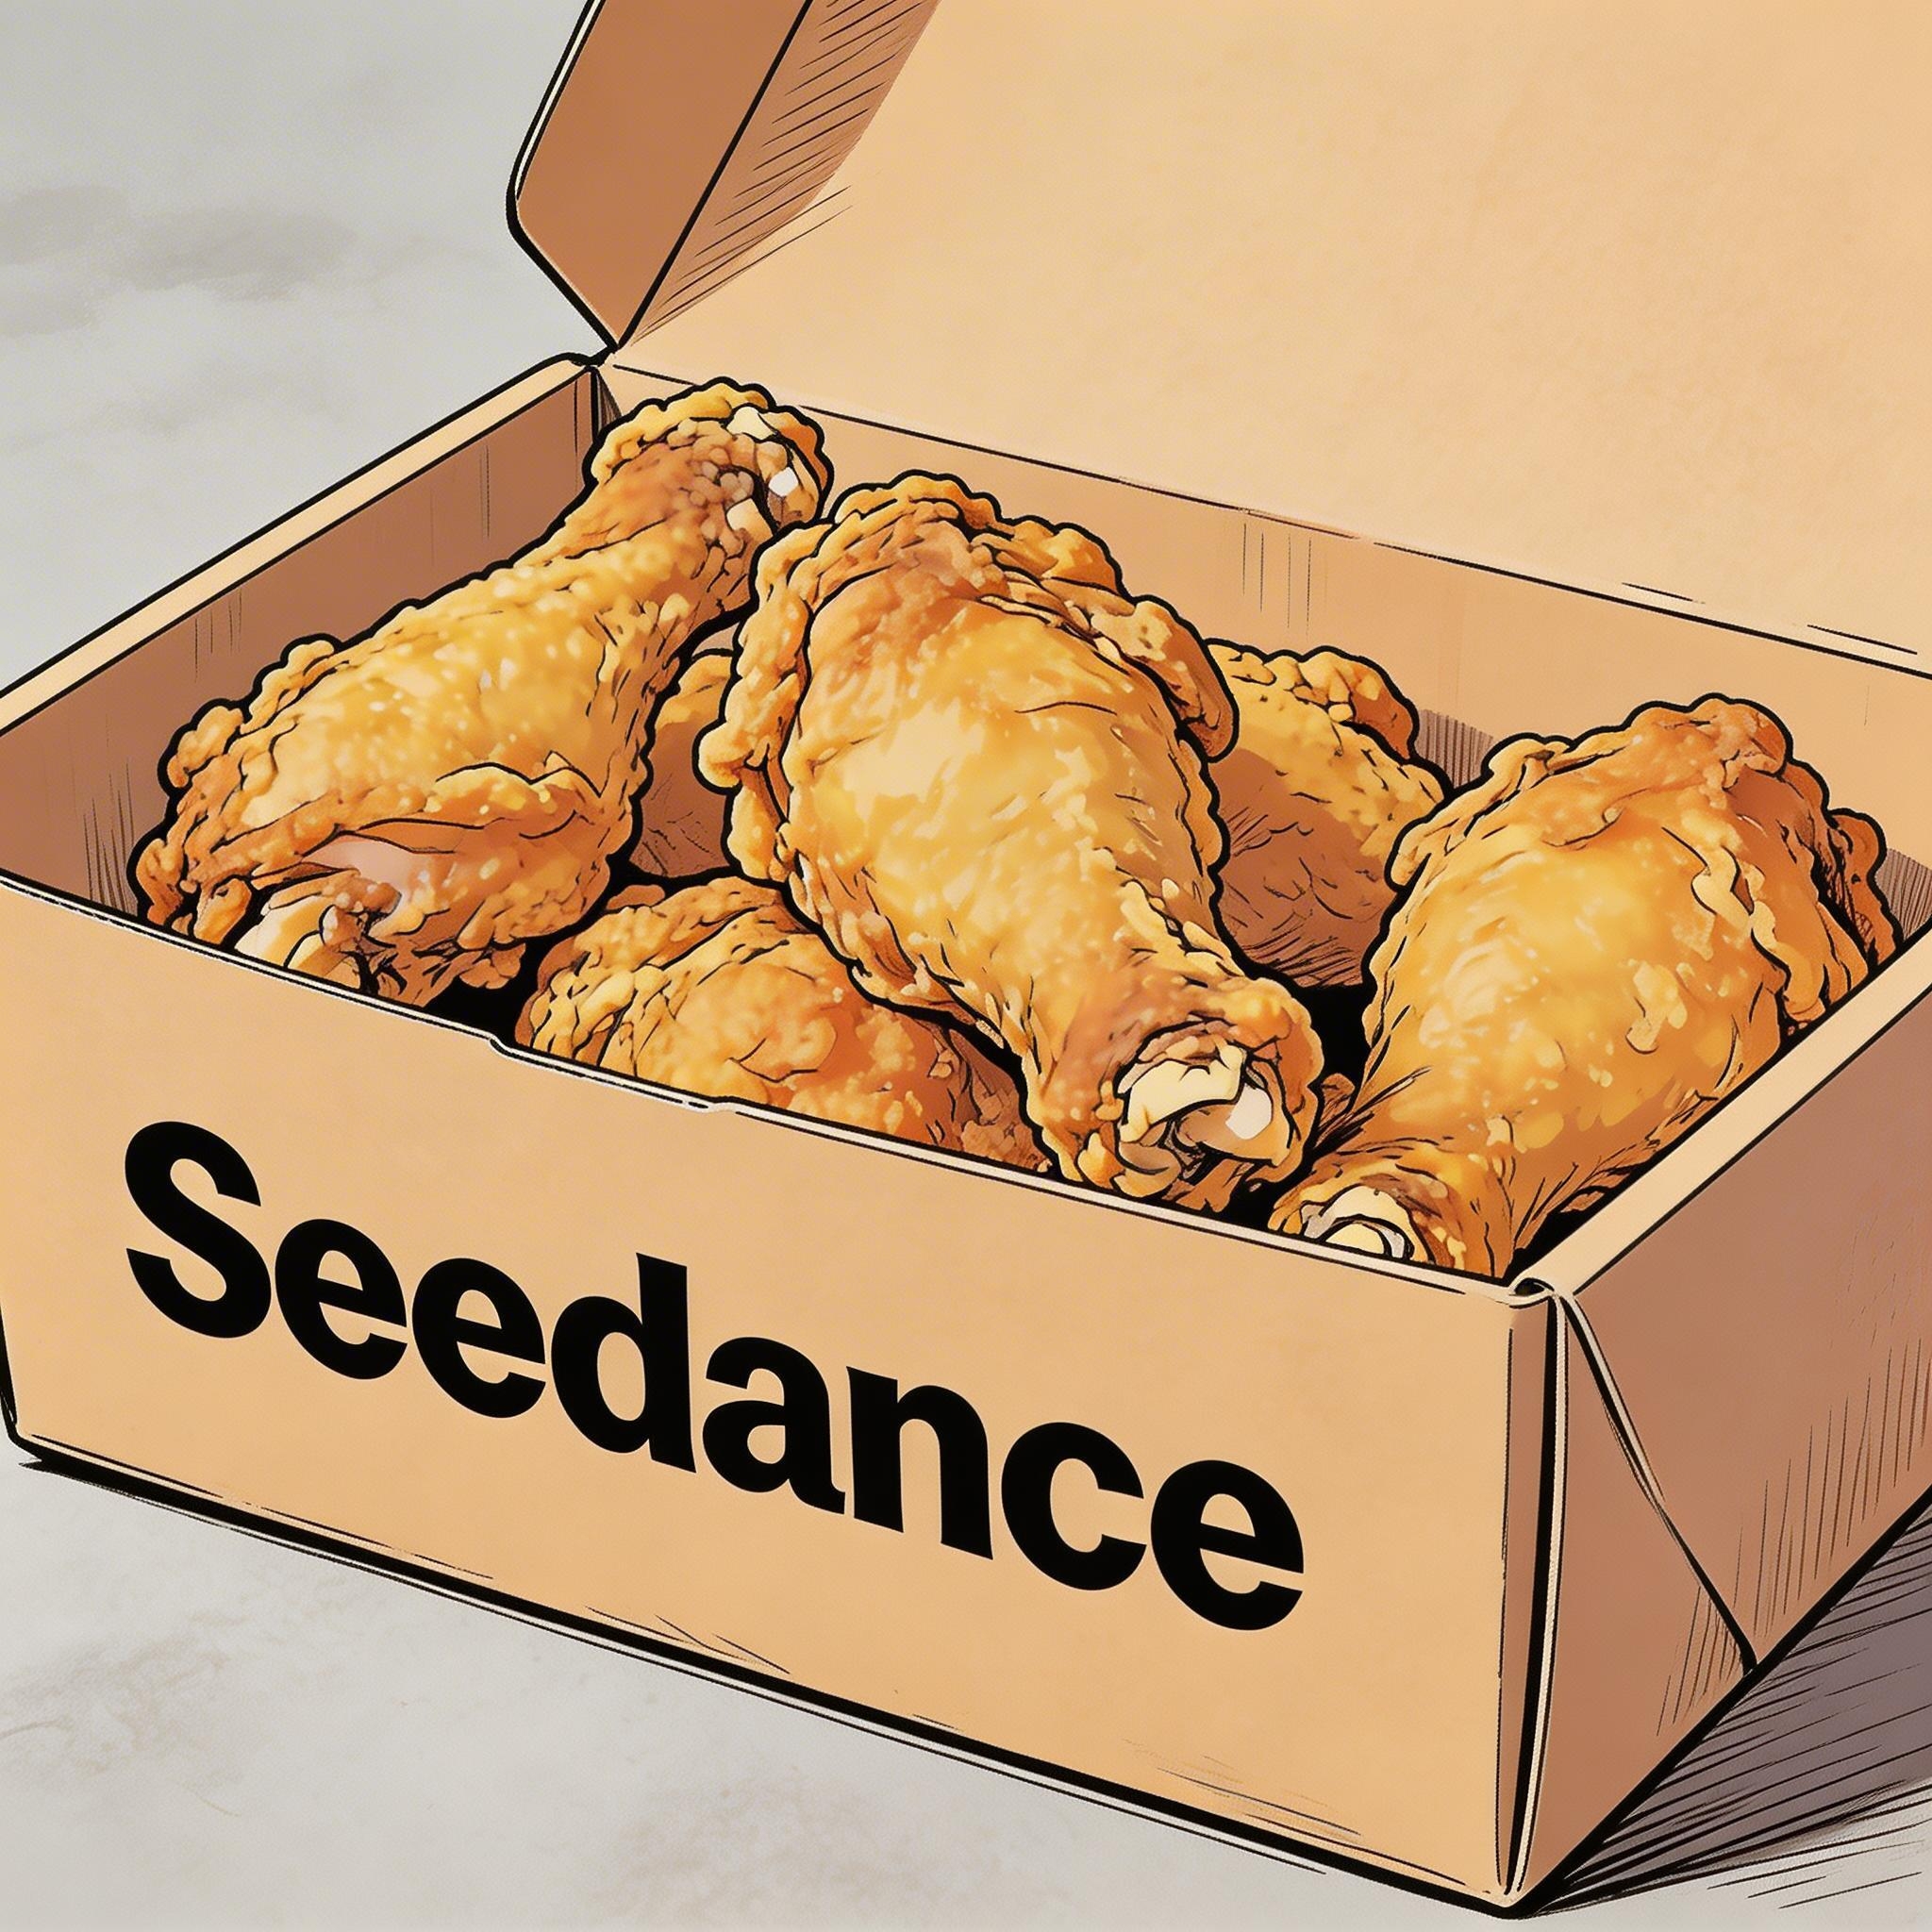
Hand-drawn comic style: Three people are sitting around a table enjoying the fried chicken shown in @Image1, with a friendly and joyful atmosphere. The frame then gradually blurs, and the text "Bite", "Laugh", and "Seedance" in order appears in the center of the screen.
Субтитры
Шаблон промпта: показывайте субтитры внизу по центру вместе с текстом. Субтитры должны быть идеально синхронизированы с ритмом и темпом аудио.
Первый пример — закадровый голос. Второй — дубляж.
Референсы
@Image1
Промпт
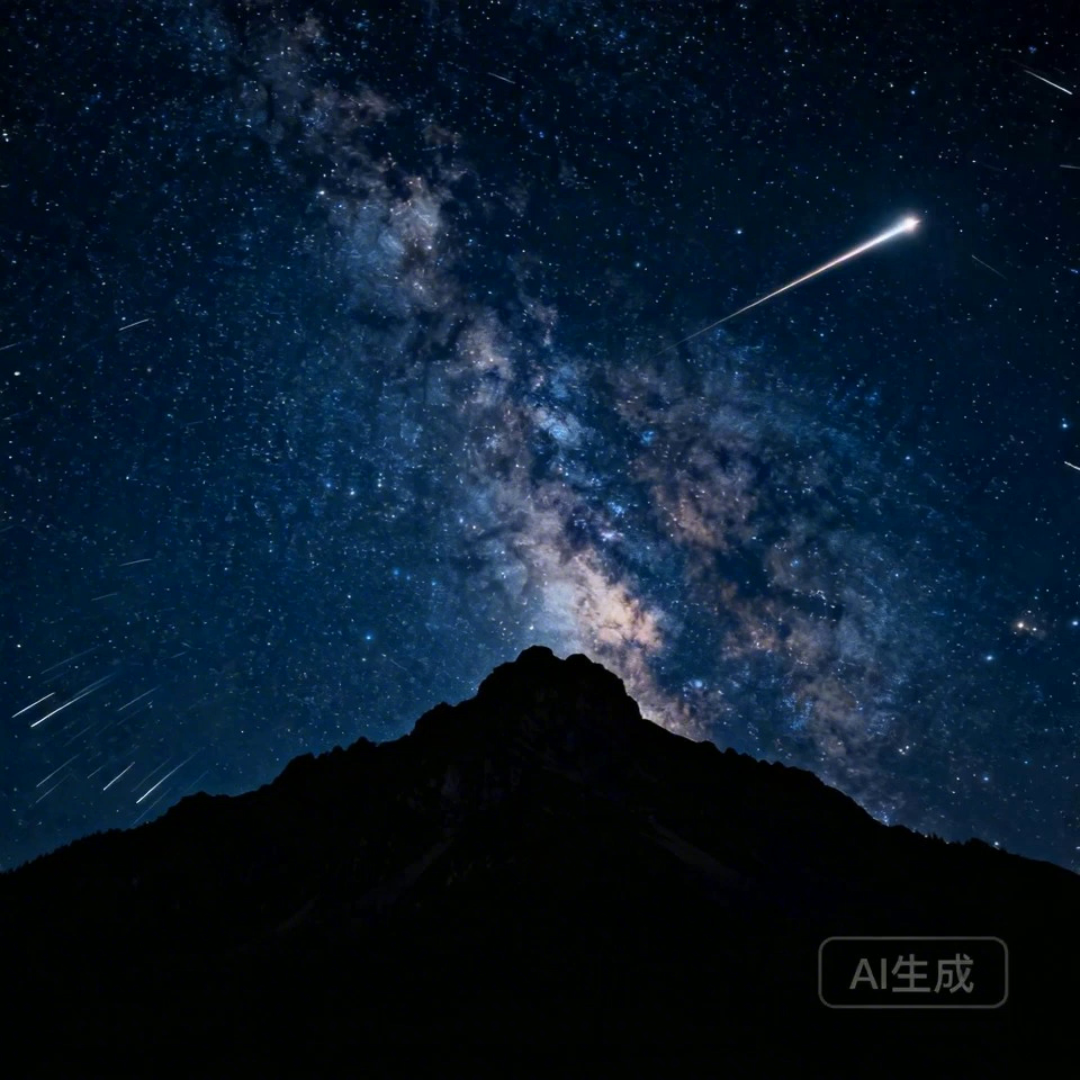
I2V: A time-lapse of a mountain landscape transitioning from a vast, starry night to a vibrant dawn. Reference @Image1. Voiceover: A deep, serene male voice says: "In the vast silence of the cosmos, our world is but a fleeting moment. Yet, within it, life defiantly thrives." Text integration: Render the narration as subtitles at the bottom-center. Subtitles must be perfectly synchronized with audio timing.
Референсы
@Image1
Промпт
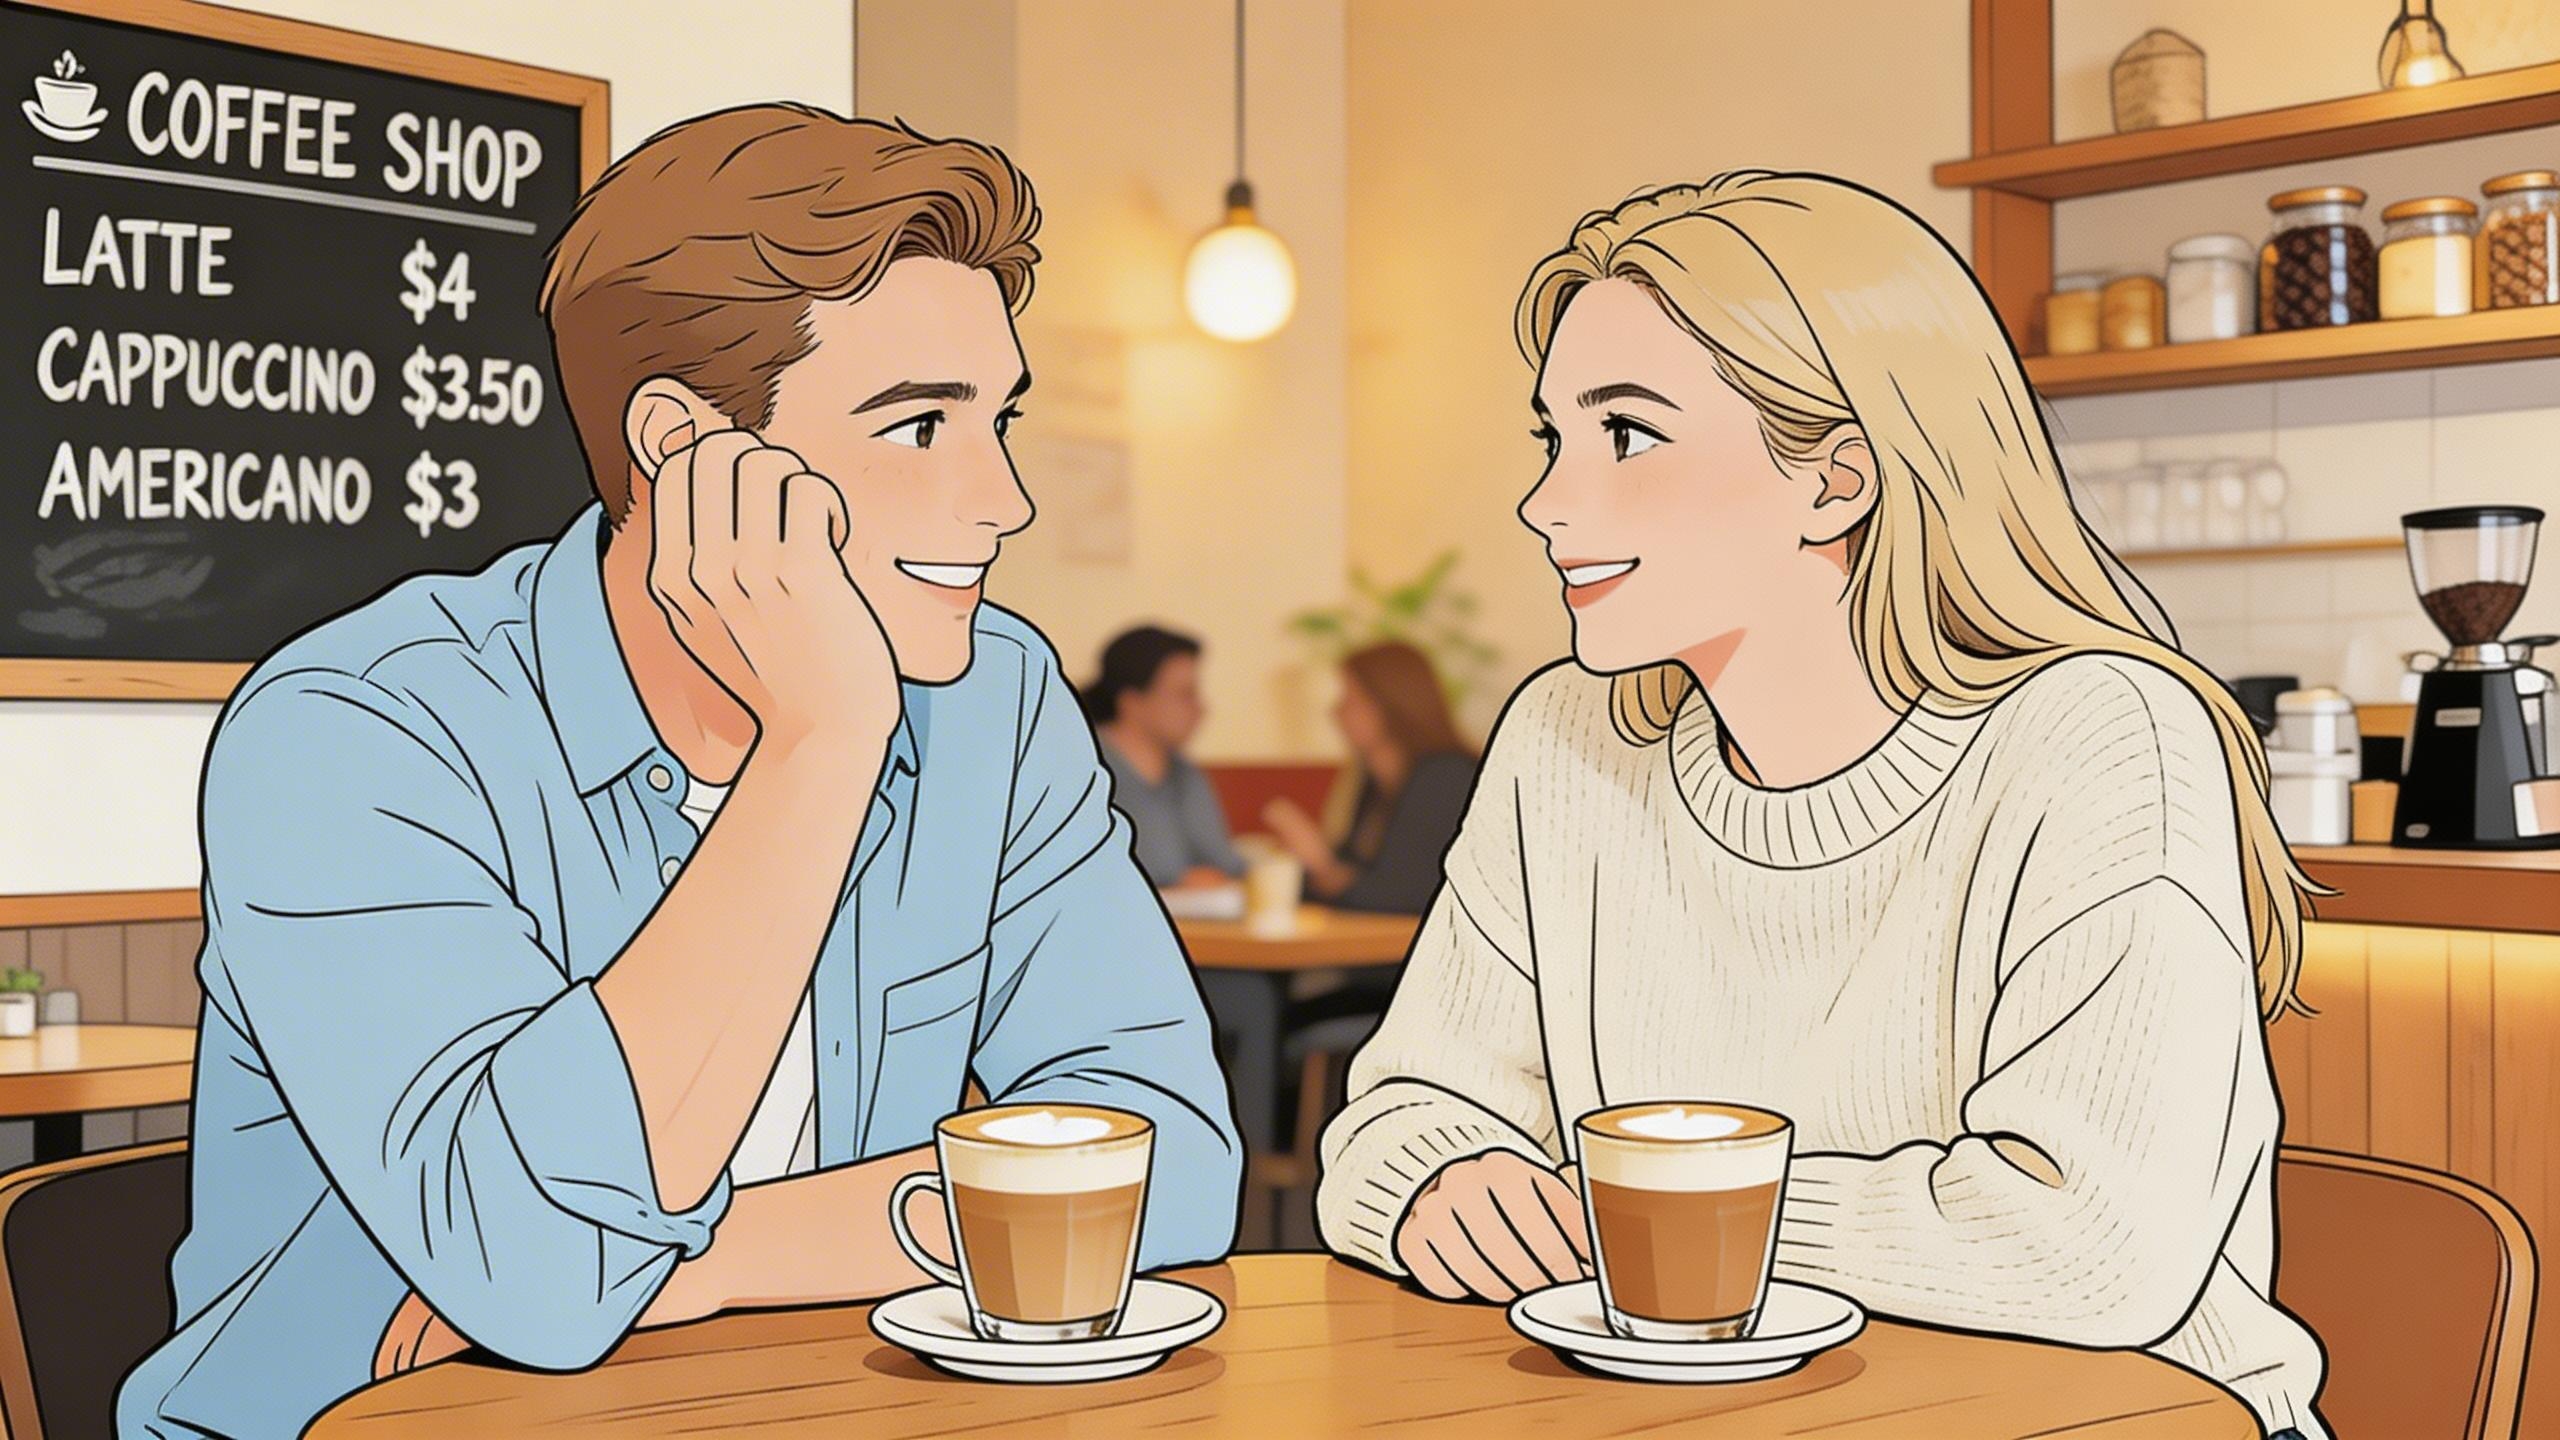
R2V: A shot of these two people in @Image1 chatting in a modern office. The woman speaks first with a playful tone: "You always arrive right on time, don't you just love that perfect timing?" followed by the man's smiling reply: "I have my own rhythm." Text integration: Render the dialogue as subtitles at the bottom-center of the screen. Subtitles should appear sequentially as each character speaks.
Речевые пузыри
Речевой пузырь содержит произнесённую реплику и появляется рядом с персонажем, который говорит.
Референсы
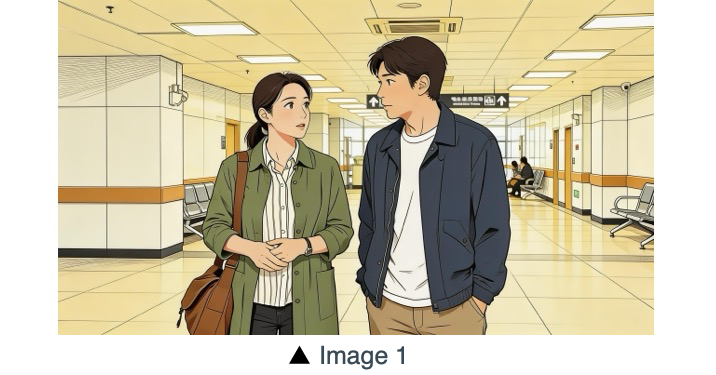
@Image1
Промпт
The two characters from @Image1, both dressed in sportswear, are running on the school playground. The girl looks at the boy, smiling confidently as she says: "We can definitely do it!". Cut to a close-up of the boy. He hesitates and replies: "Are you sure?". Cut back to a medium close-up of the girl. She speaks in a light, upbeat tone: "Yes!" Her demeanor is bright and resolute. Speech bubbles containing the corresponding lines appear around the speaking character.
Референсы
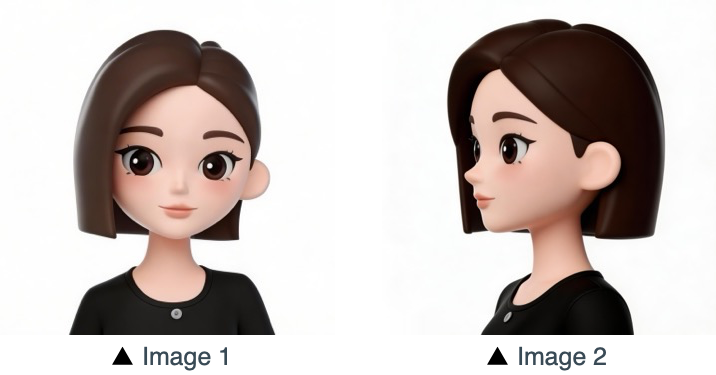
@Image1
Промпт
Refer to the character design of the girl in Image 1 and Image 2 on @Image1. The scene is set in an apple field: the girl picks one apple, takes a bite, smiles and says "This is the real deal!". A speech bubble pops up beside the girl, with this line written inside.
Референс субъекта с нескольких ракурсов
Один субъект, показанный с нескольких углов на листе: потребительская электроника, дом и образ жизни, и человек.
Референсы
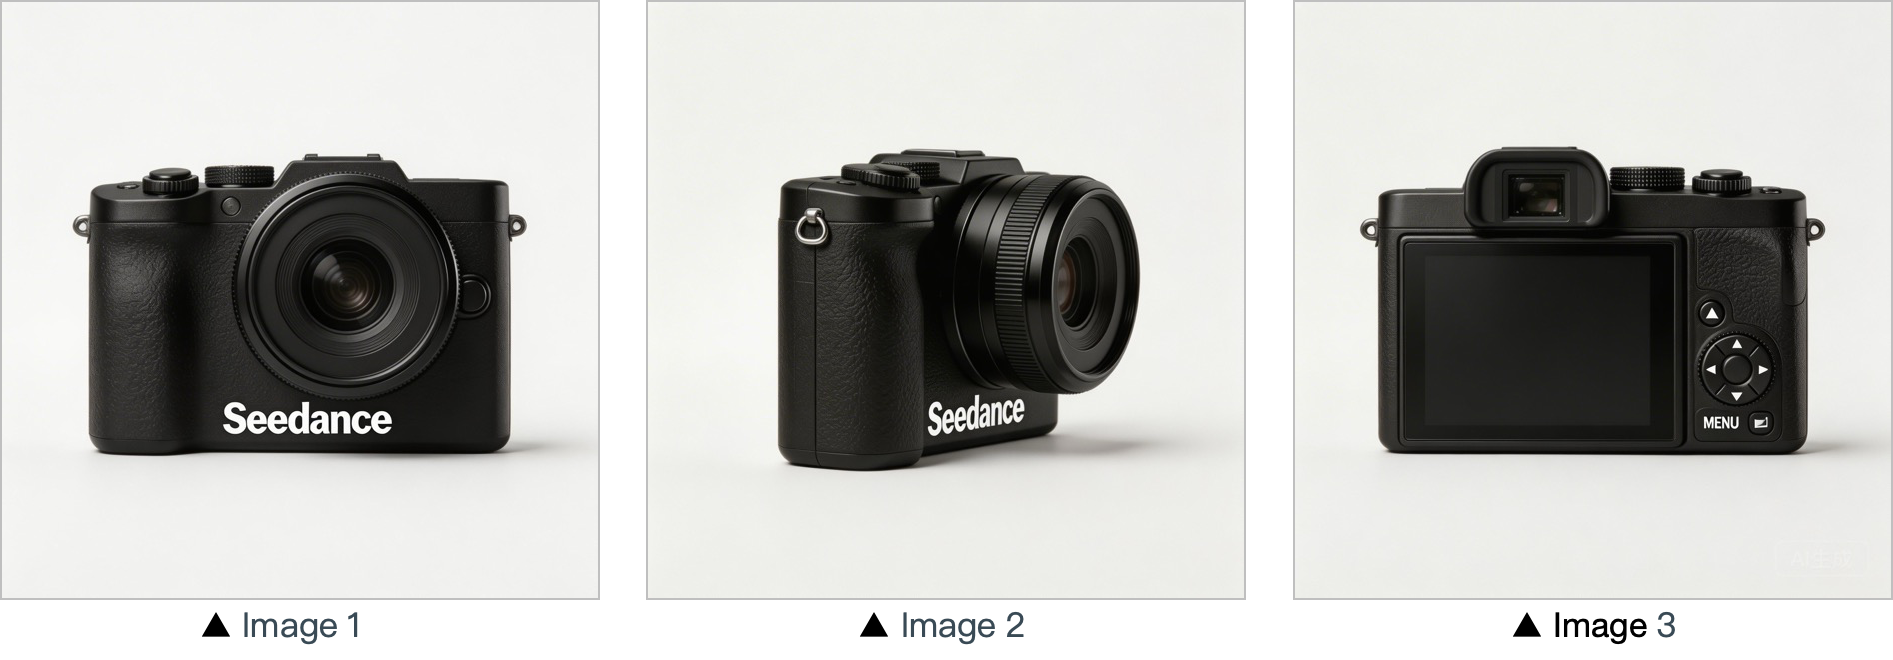
@Image1
Промпт
Use the cameras featured in Image 1, Image 2 and Image 3 on @Image1. Replace the original background with a white one, and place the cameras on a white table. The camera first focuses on the cameras in close-up, then slowly rotates 360° with the cameras as the main subject, clearly displaying the front, sides and back of each camera.
Референсы
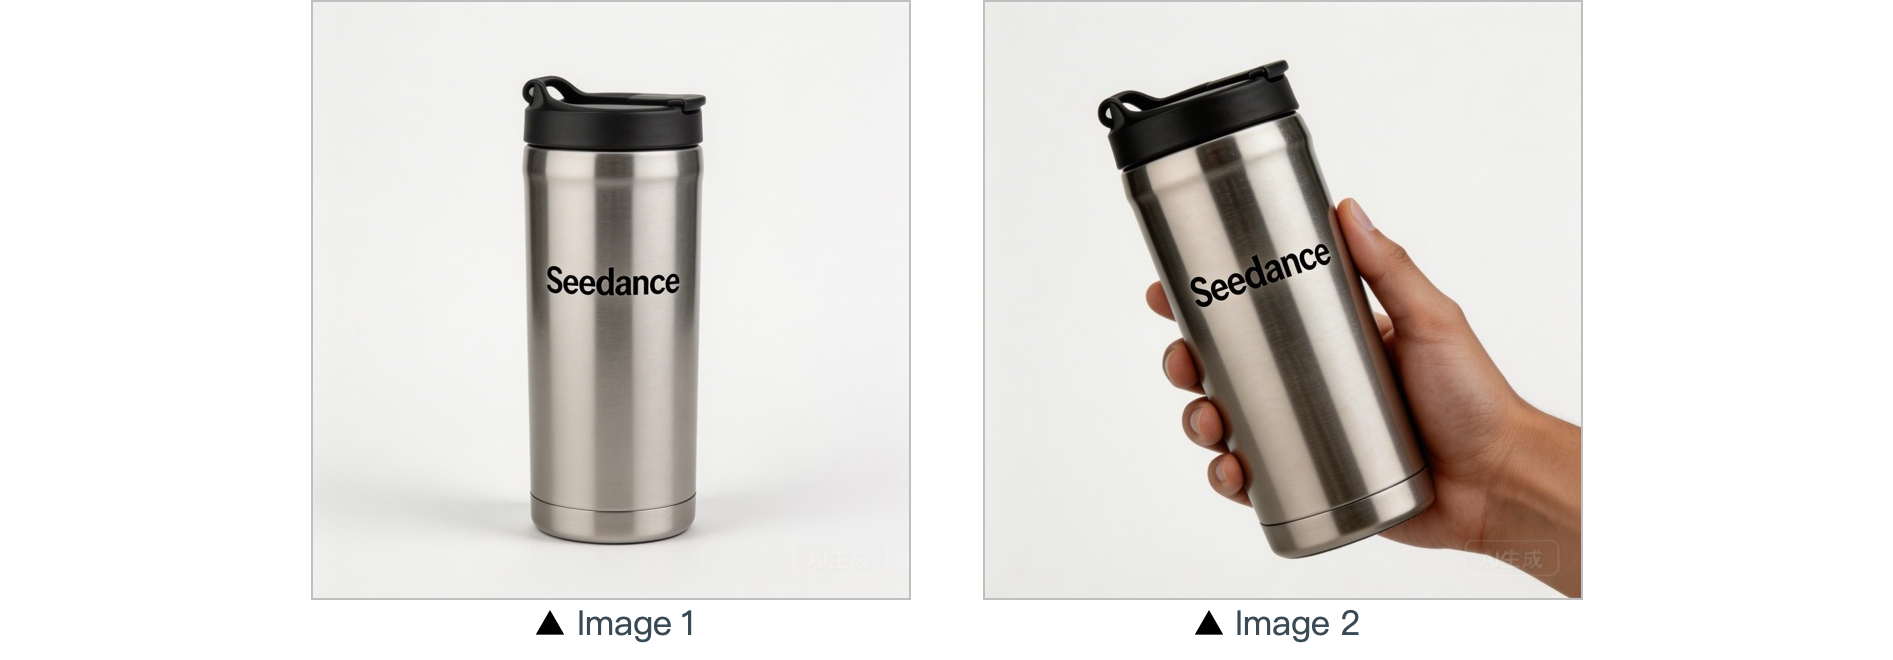
@Image1
Промпт
In a warm-toned home setting, present the thermos shown in @Image1 in a medium shot. Then smoothly push the camera into a close-up of the thermos. Next, a hand naturally enters the frame off-screen, gently grips the thermos body and picks it up. The camera follows the slight rotating motion of the hand to showcase the thermos.
Референсы
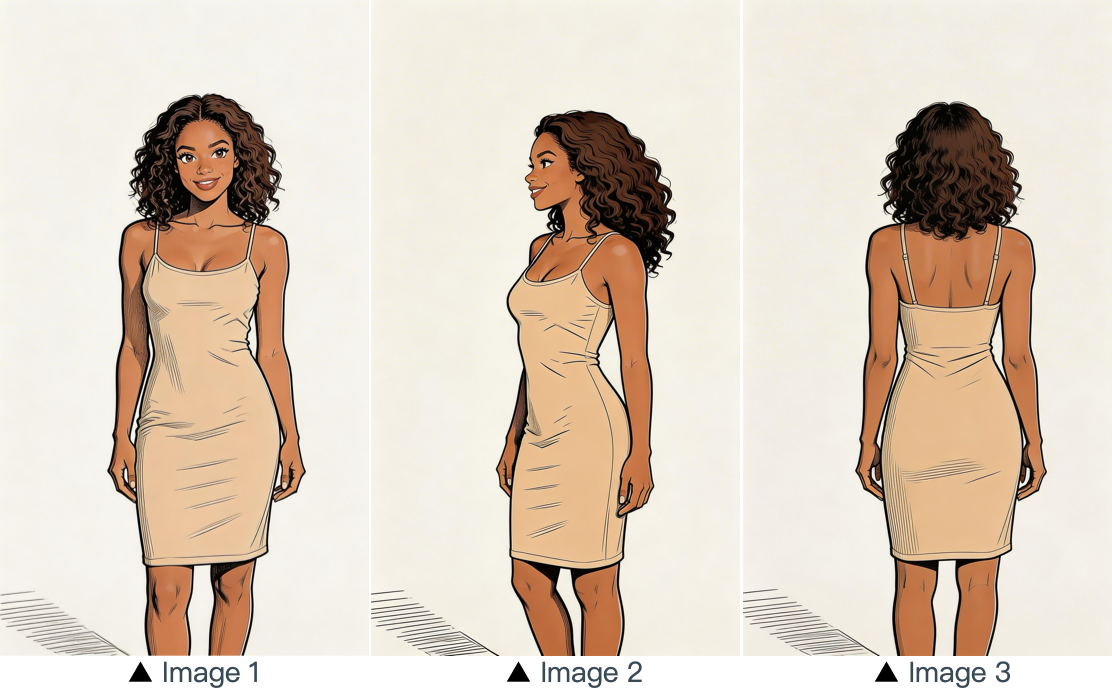
@Image1
Промпт
Refer to the image of the woman in Image 1, Image 2 and Image 3 on @Image1, and generate a scene of her eating a cake in a coffee shop.
Референс нескольких изображений
У каждой картинки на листе одна задача: логотип, несколько субъектов, состав и место, последовательность из нескольких панелей или последовательность кадров.
Референсы
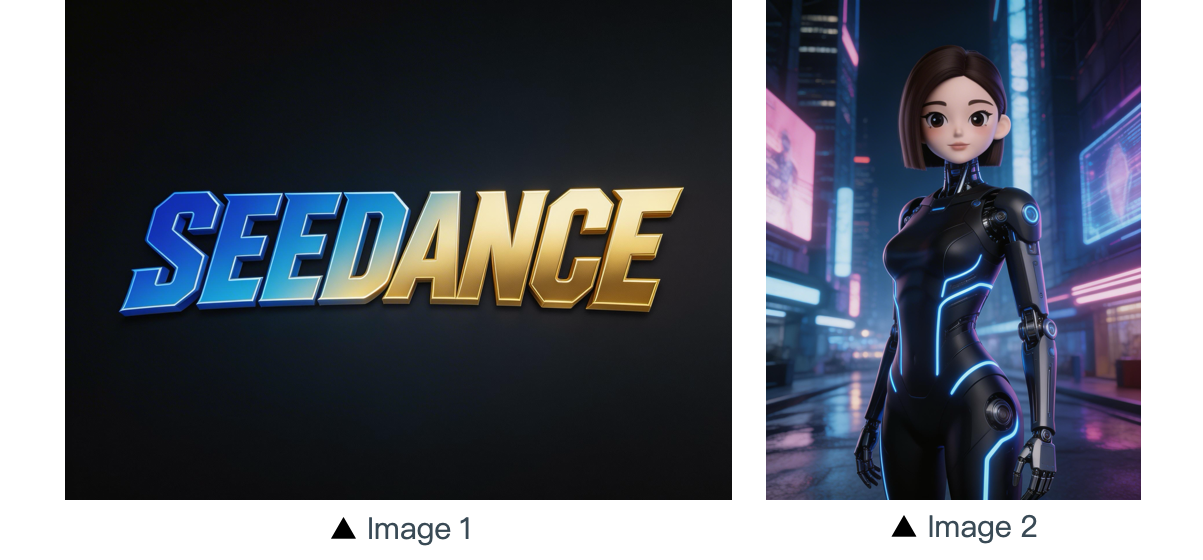
@Image1
Промпт
The scene is set on an aerial corridor in a neon-drenched futuristic metropolis, where flying vehicles and holographic ads intertwine. Featuring the girl from Image 2 on @Image1, the sequence opens with a medium shot of her releasing a silver floating lantern embedded with a holographic projection. The camera then pulls back to reveal floating lanterns flooding the sky, which gradually converge at the center of the frame to form the logo from Image 1 on @Image1. The entire piece adopts a 3D cyberpunk sci-fi animation style.
Референсы
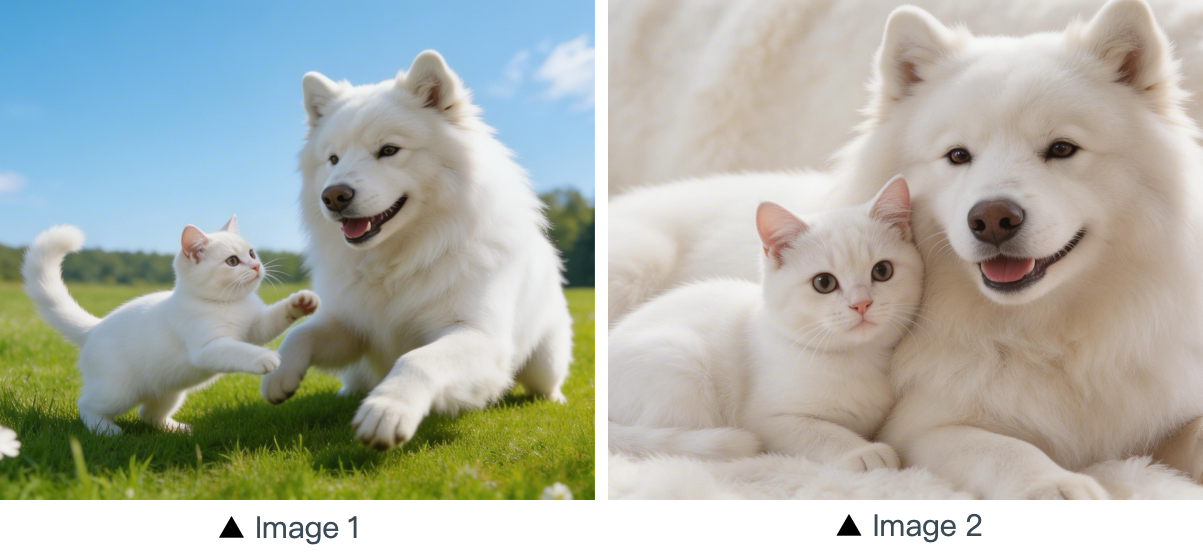
@Image1
Промпт
Using the cat and dog from Image 1 and Image 2 on @Image1 as prototypes, the scene unfolds in a cozy apartment. The dog is lying on the ground eating dog food when the cat approaches, extending a paw to nudge the dog. The dog pauses its meal upon noticing the cat, and the cat snuggles up next to the dog. The entire scene features a warm colored tone.
Референсы
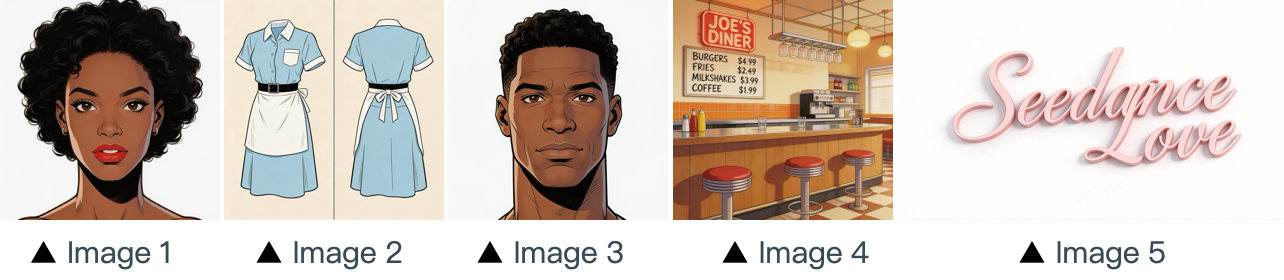
@Image1
Промпт
The scene is set in the restaurant from image 4 on @Image1, with people coming and going. The girl from image 1, wearing the clothes from image 2, is organizing the items on the counter. The boy, a customer, from image 3 approaches her to ask for her contact information. The logo from image 5 remains in the bottom right corner throughout.
Референсы
@Image1
Промпт
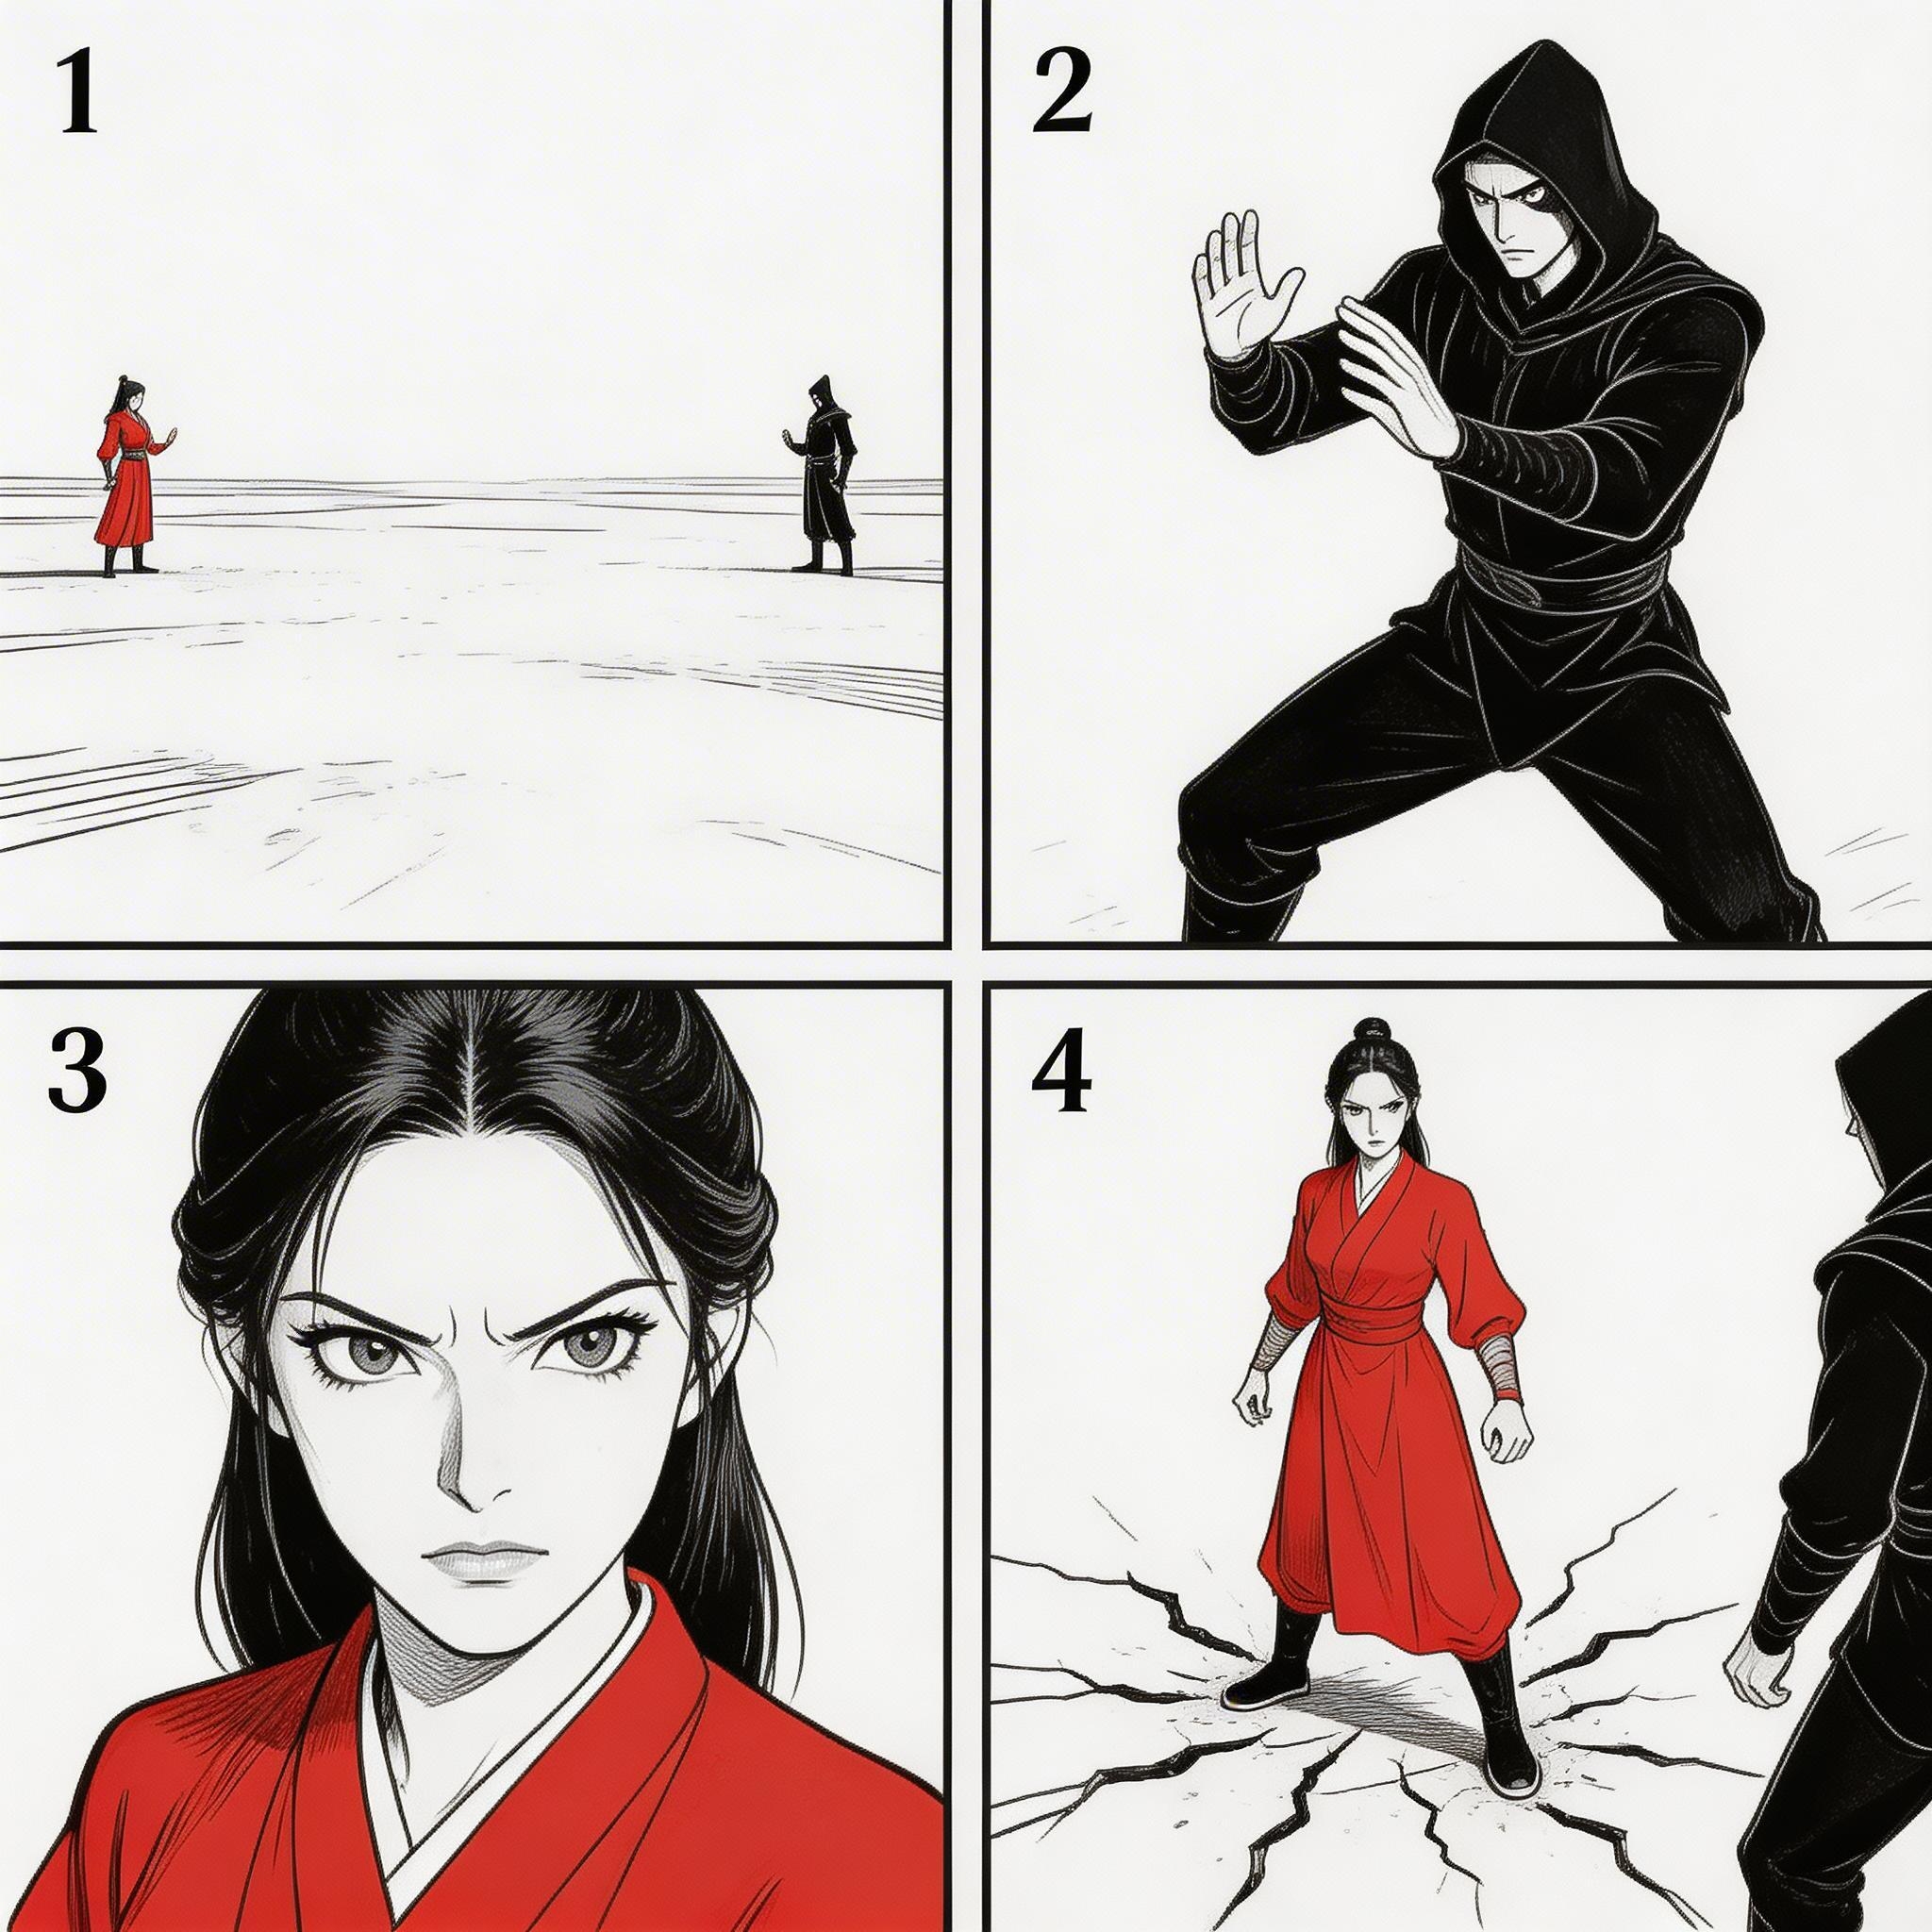
Refer to the sequence in @Image1 to create an intense high-energy fight sequence. All frame compositions from @Image1 shall be presented in strict predefined order, after which the two characters engage in fierce, fast-paced combat.
Референсы
@Image1
Промпт
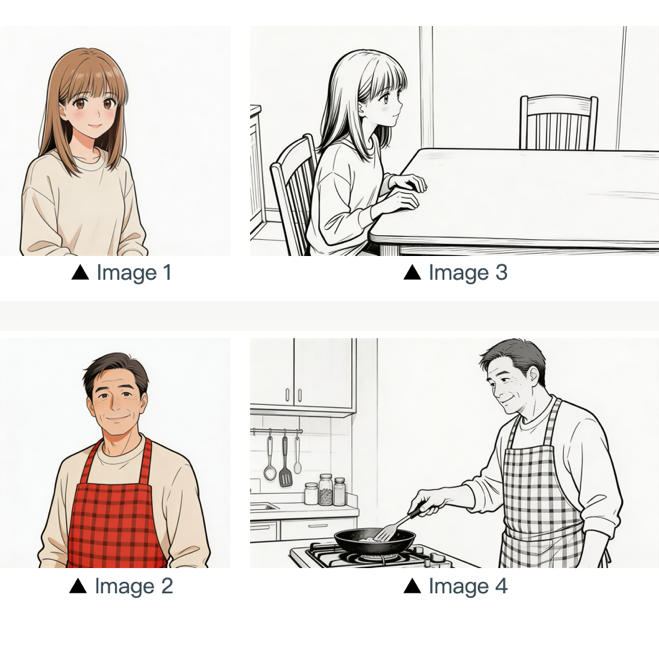
Refer to the composition in Image 3 on @Image1. A girl (her character design refers to Image 1) is waiting for her father to finish cooking, and she says: "아빠, 배고파요! 밥 다 됐어요?" Then the camera pans right and cuts to the frame and composition shown in Image 4. The father (his character design refers to Image 2) replies to her: "거의 다 됐어, 조금만 기다려!" Next, the camera cuts back to a close-up shot of the daughter's slightly disappointed facial expression, and she says: "아직 멀었어요? 맛있는 냄새 나는데..." Then the shot switches to a close-up of the father's face, and he says: "이제 진짜 금방이야. '빨리빨리' 하지 말고 손부터 씻고 와!"
Референс движения
Опирайтесь на движения персонажа и язык планов в видео, затем примените их к персонажам на изображении. Маркетинговый пример опирается на форму бега лошади в видео.
Референсы
@Image1
@Video1
Промпт
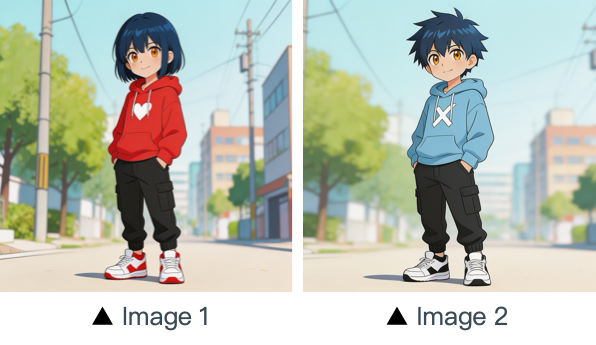
Refer to the character movements and shot language in @Video1 to create a fight scene with the character from Image 2 on @Image1 on the left and the character from Image 1 on @Image1 on the right. Include intense background music.
Референсы
@Video1
Промпт
Referencing the running shape of the horse in @Video1, generate a scene: a golden steed runs on the grassland, then freezes its magnificent running posture and turns into a horse-shaped gold pendant.
Референс движения камеры
Опирайтесь на движение камеры в видео и назовите новый субъект на изображении.
Референсы
@Image1
@Video1
Промпт
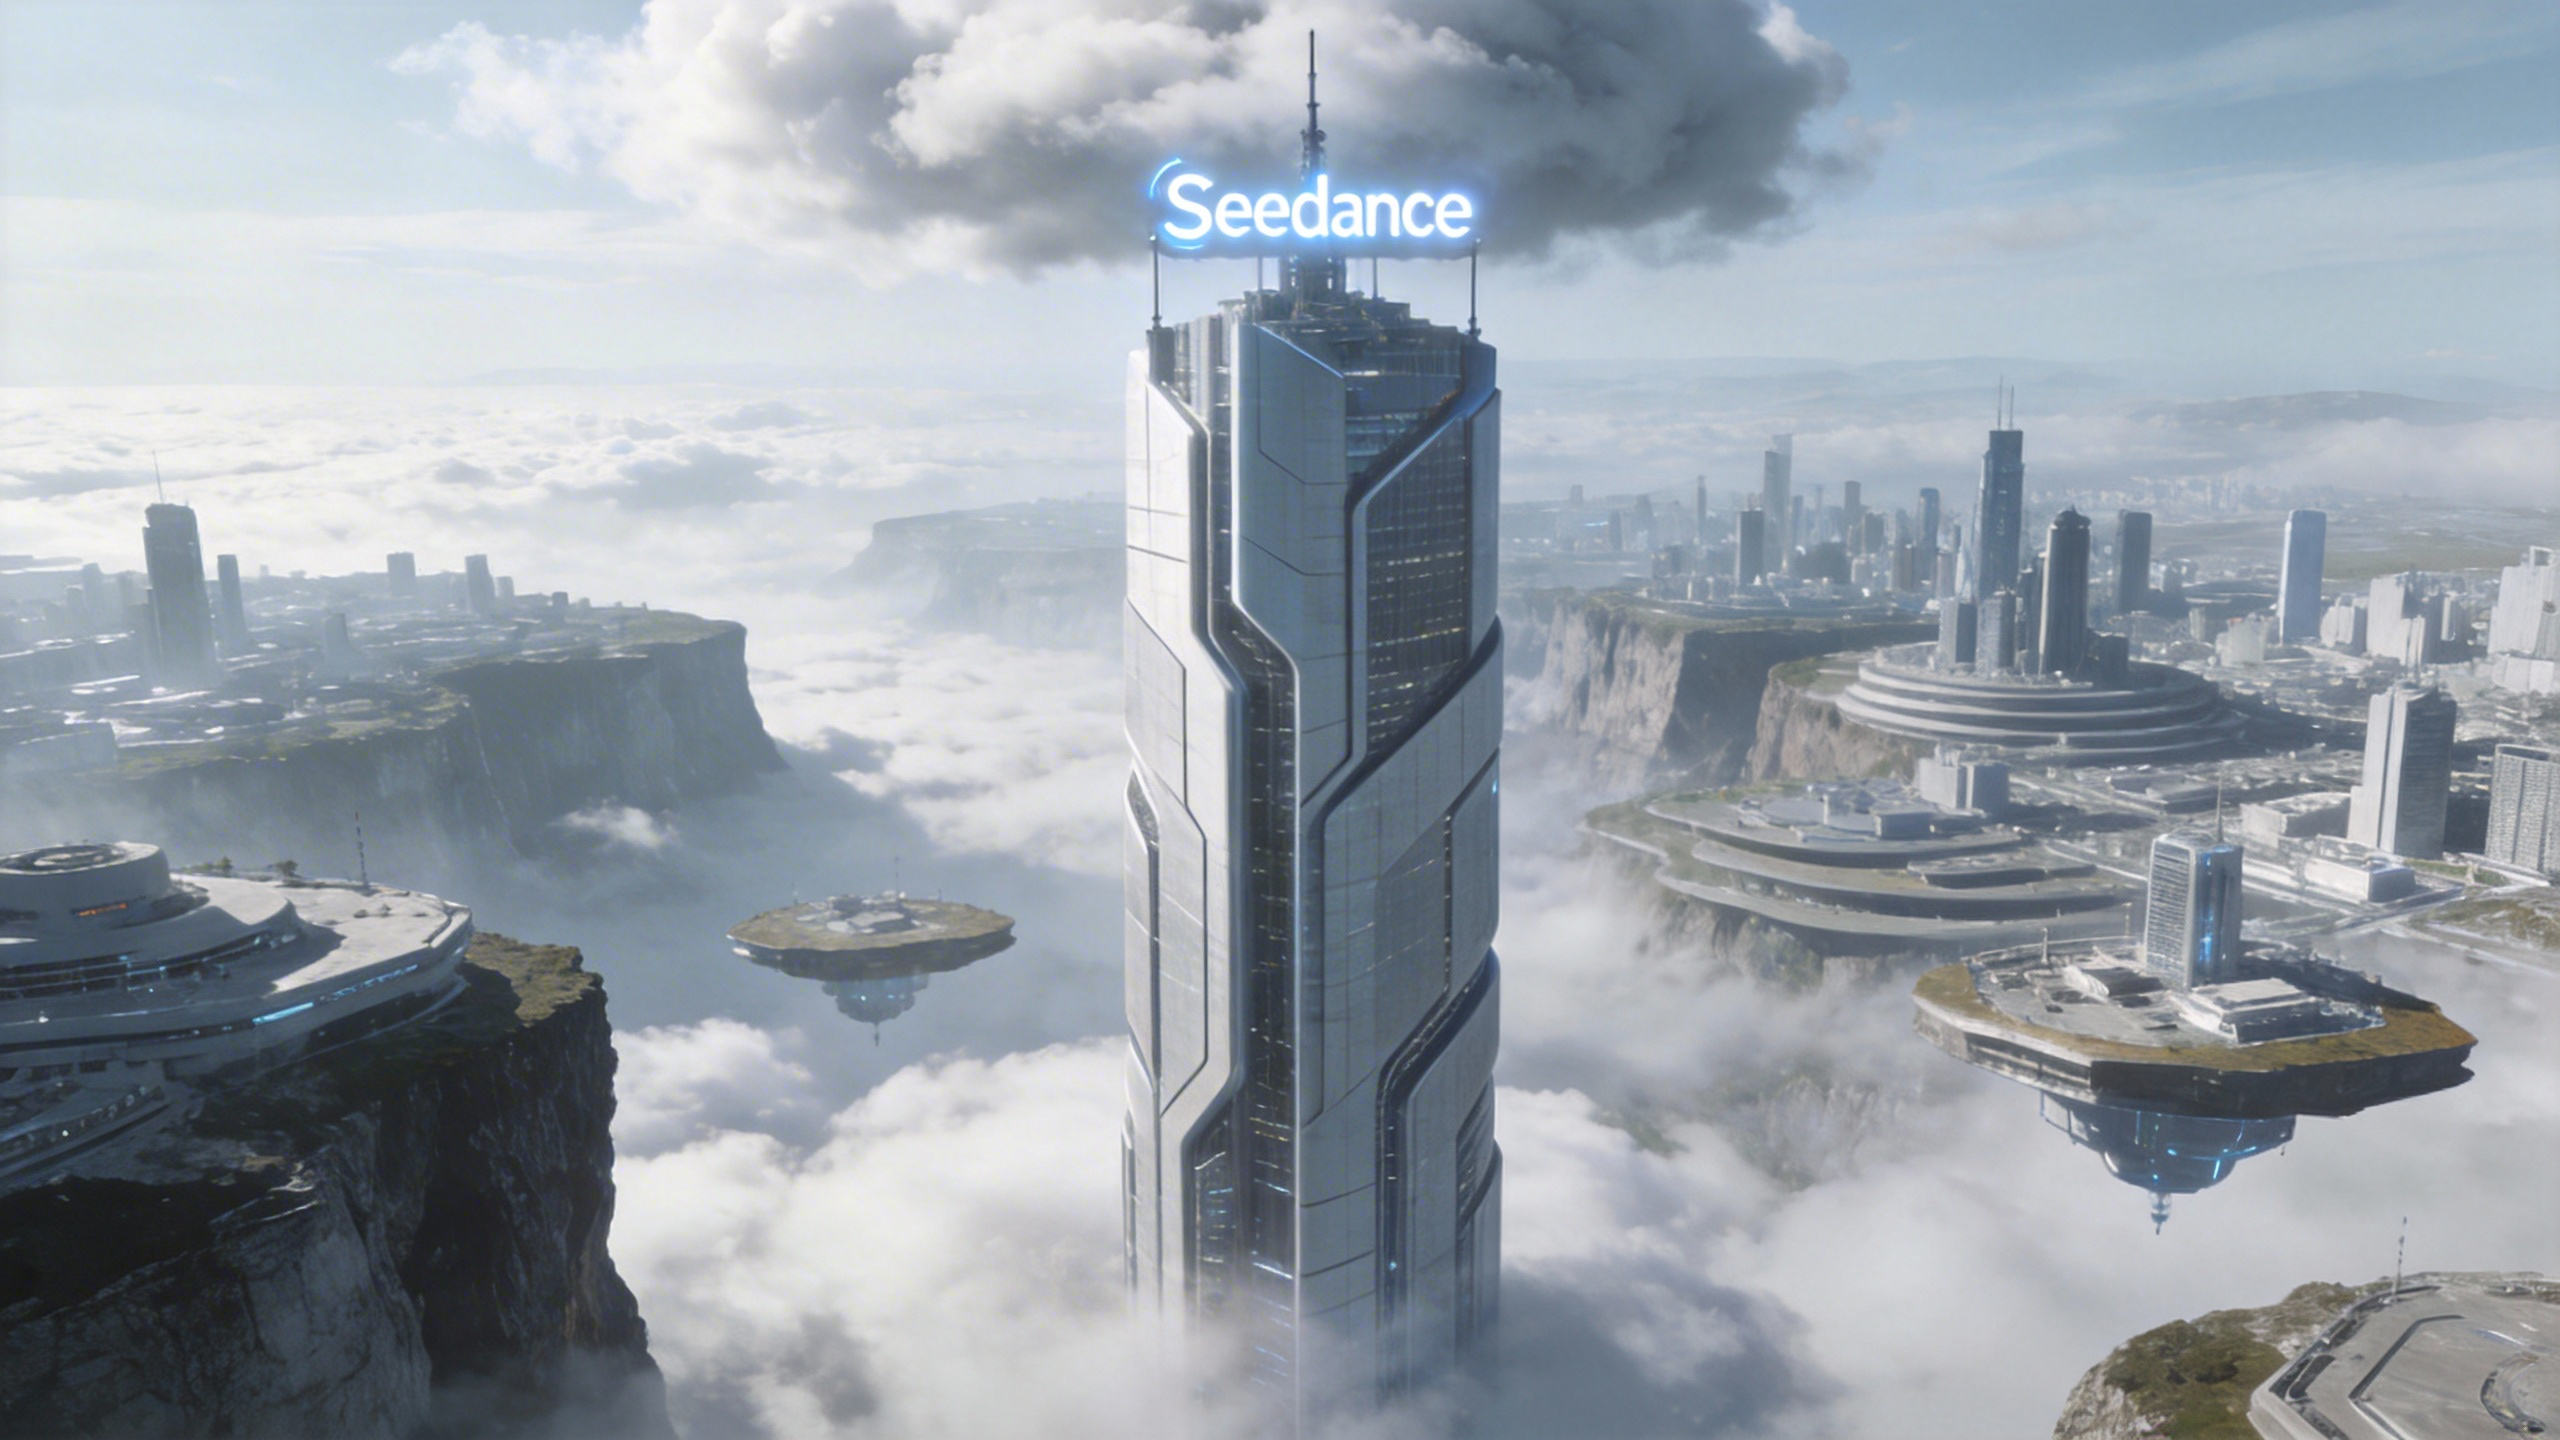
Referring to the camera movement in @Video1, create a concept video for a science and technology park, with the tall building in @Image1 as the visual center, also using a first-person diving perspective, to reflect the sense of technology in the park from @Image1.
Референс спецэффектов
Опирайтесь на спецэффект в видео и примените тот же эффект, тот же путь и ту же последовательность к персонажу на изображении.
Референсы
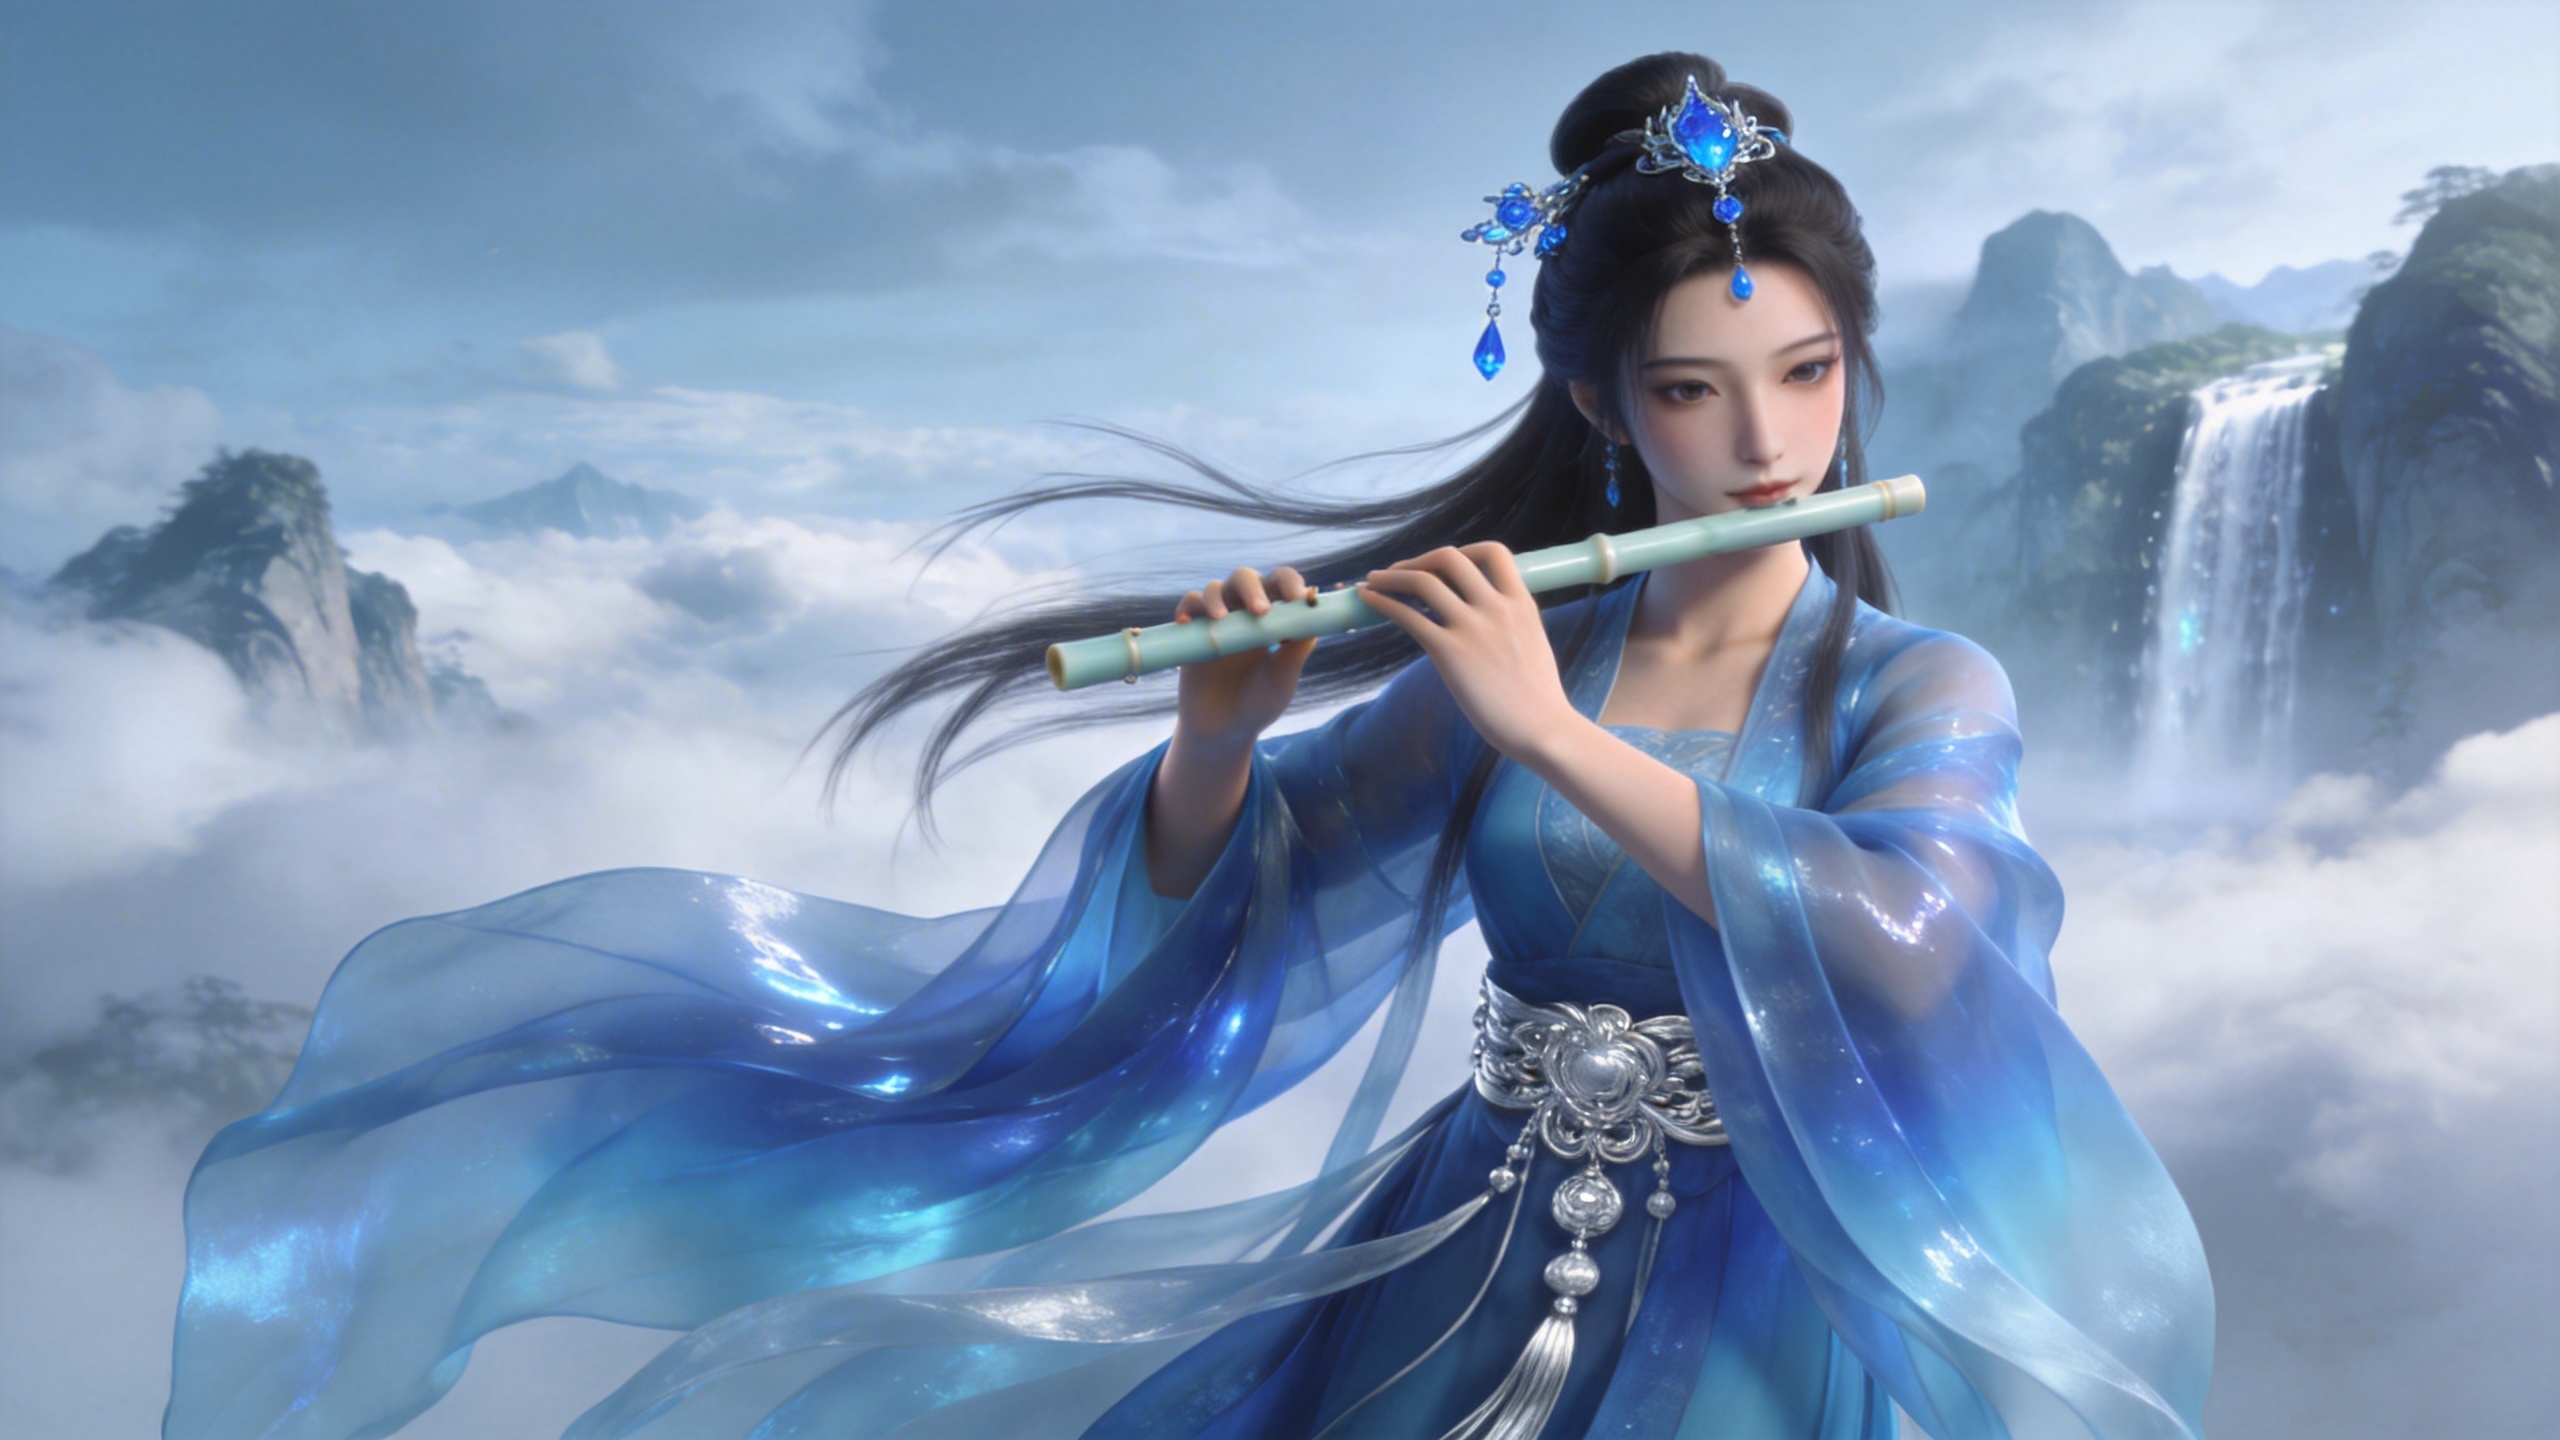
@Image1
@Video1
Промпт
Refer to the golden particle effects in @Video1, so that when the character in @Image1 plays the flute, the same particle effects surround their body.
Референсы
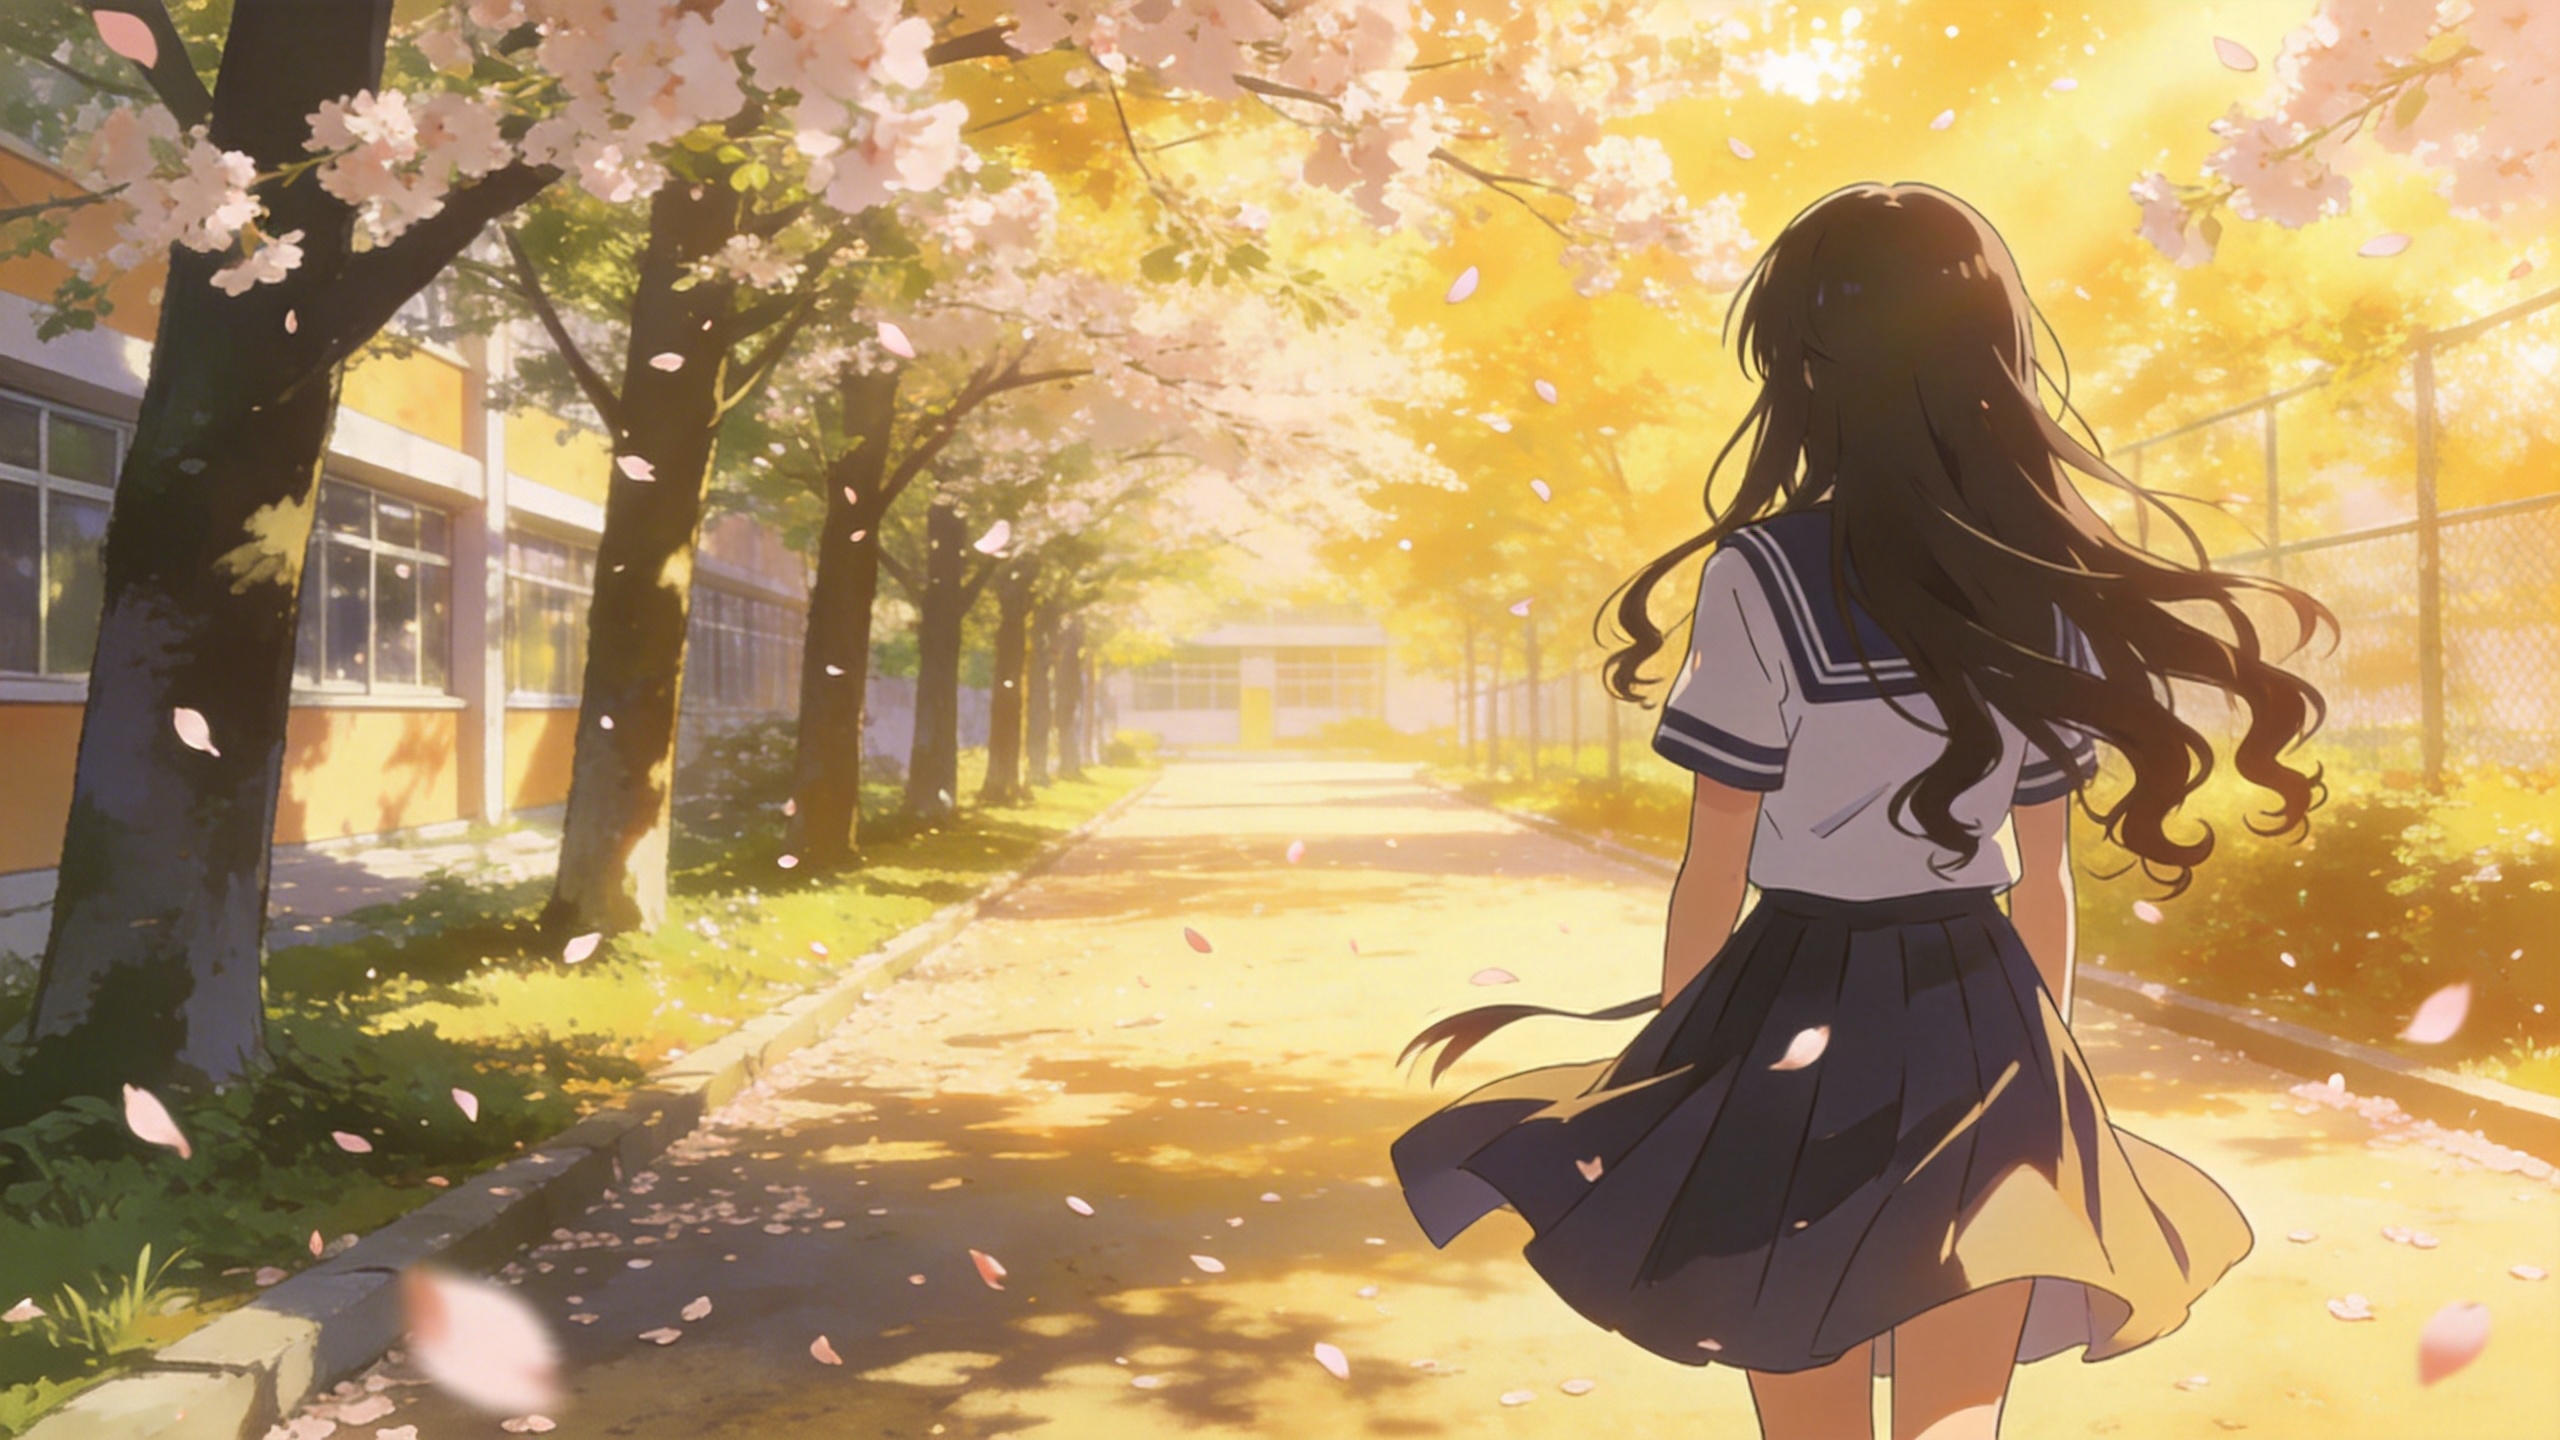
@Image1
@Video1
Промпт
Refer to the special effects shown in @Video1 to generate identical wings for the girl in @Image1, ensuring the wing formation trajectory follows the exact same motion path and sequence depicted in the video.
Добавление, удаление или изменение элементов
Добавьте, удалите или замените. Для правки не пишите "reference". Части, которые не названы, остаются без изменений.
Референсы
@Video1
Промпт
Add snacks such as fried chicken and pizza to the countertop in @Video1.
Референсы
@Video1
Промпт
Remove everything that isn't office supplies from the table in @Video1, keeping the rest of the video content unchanged.
Референсы
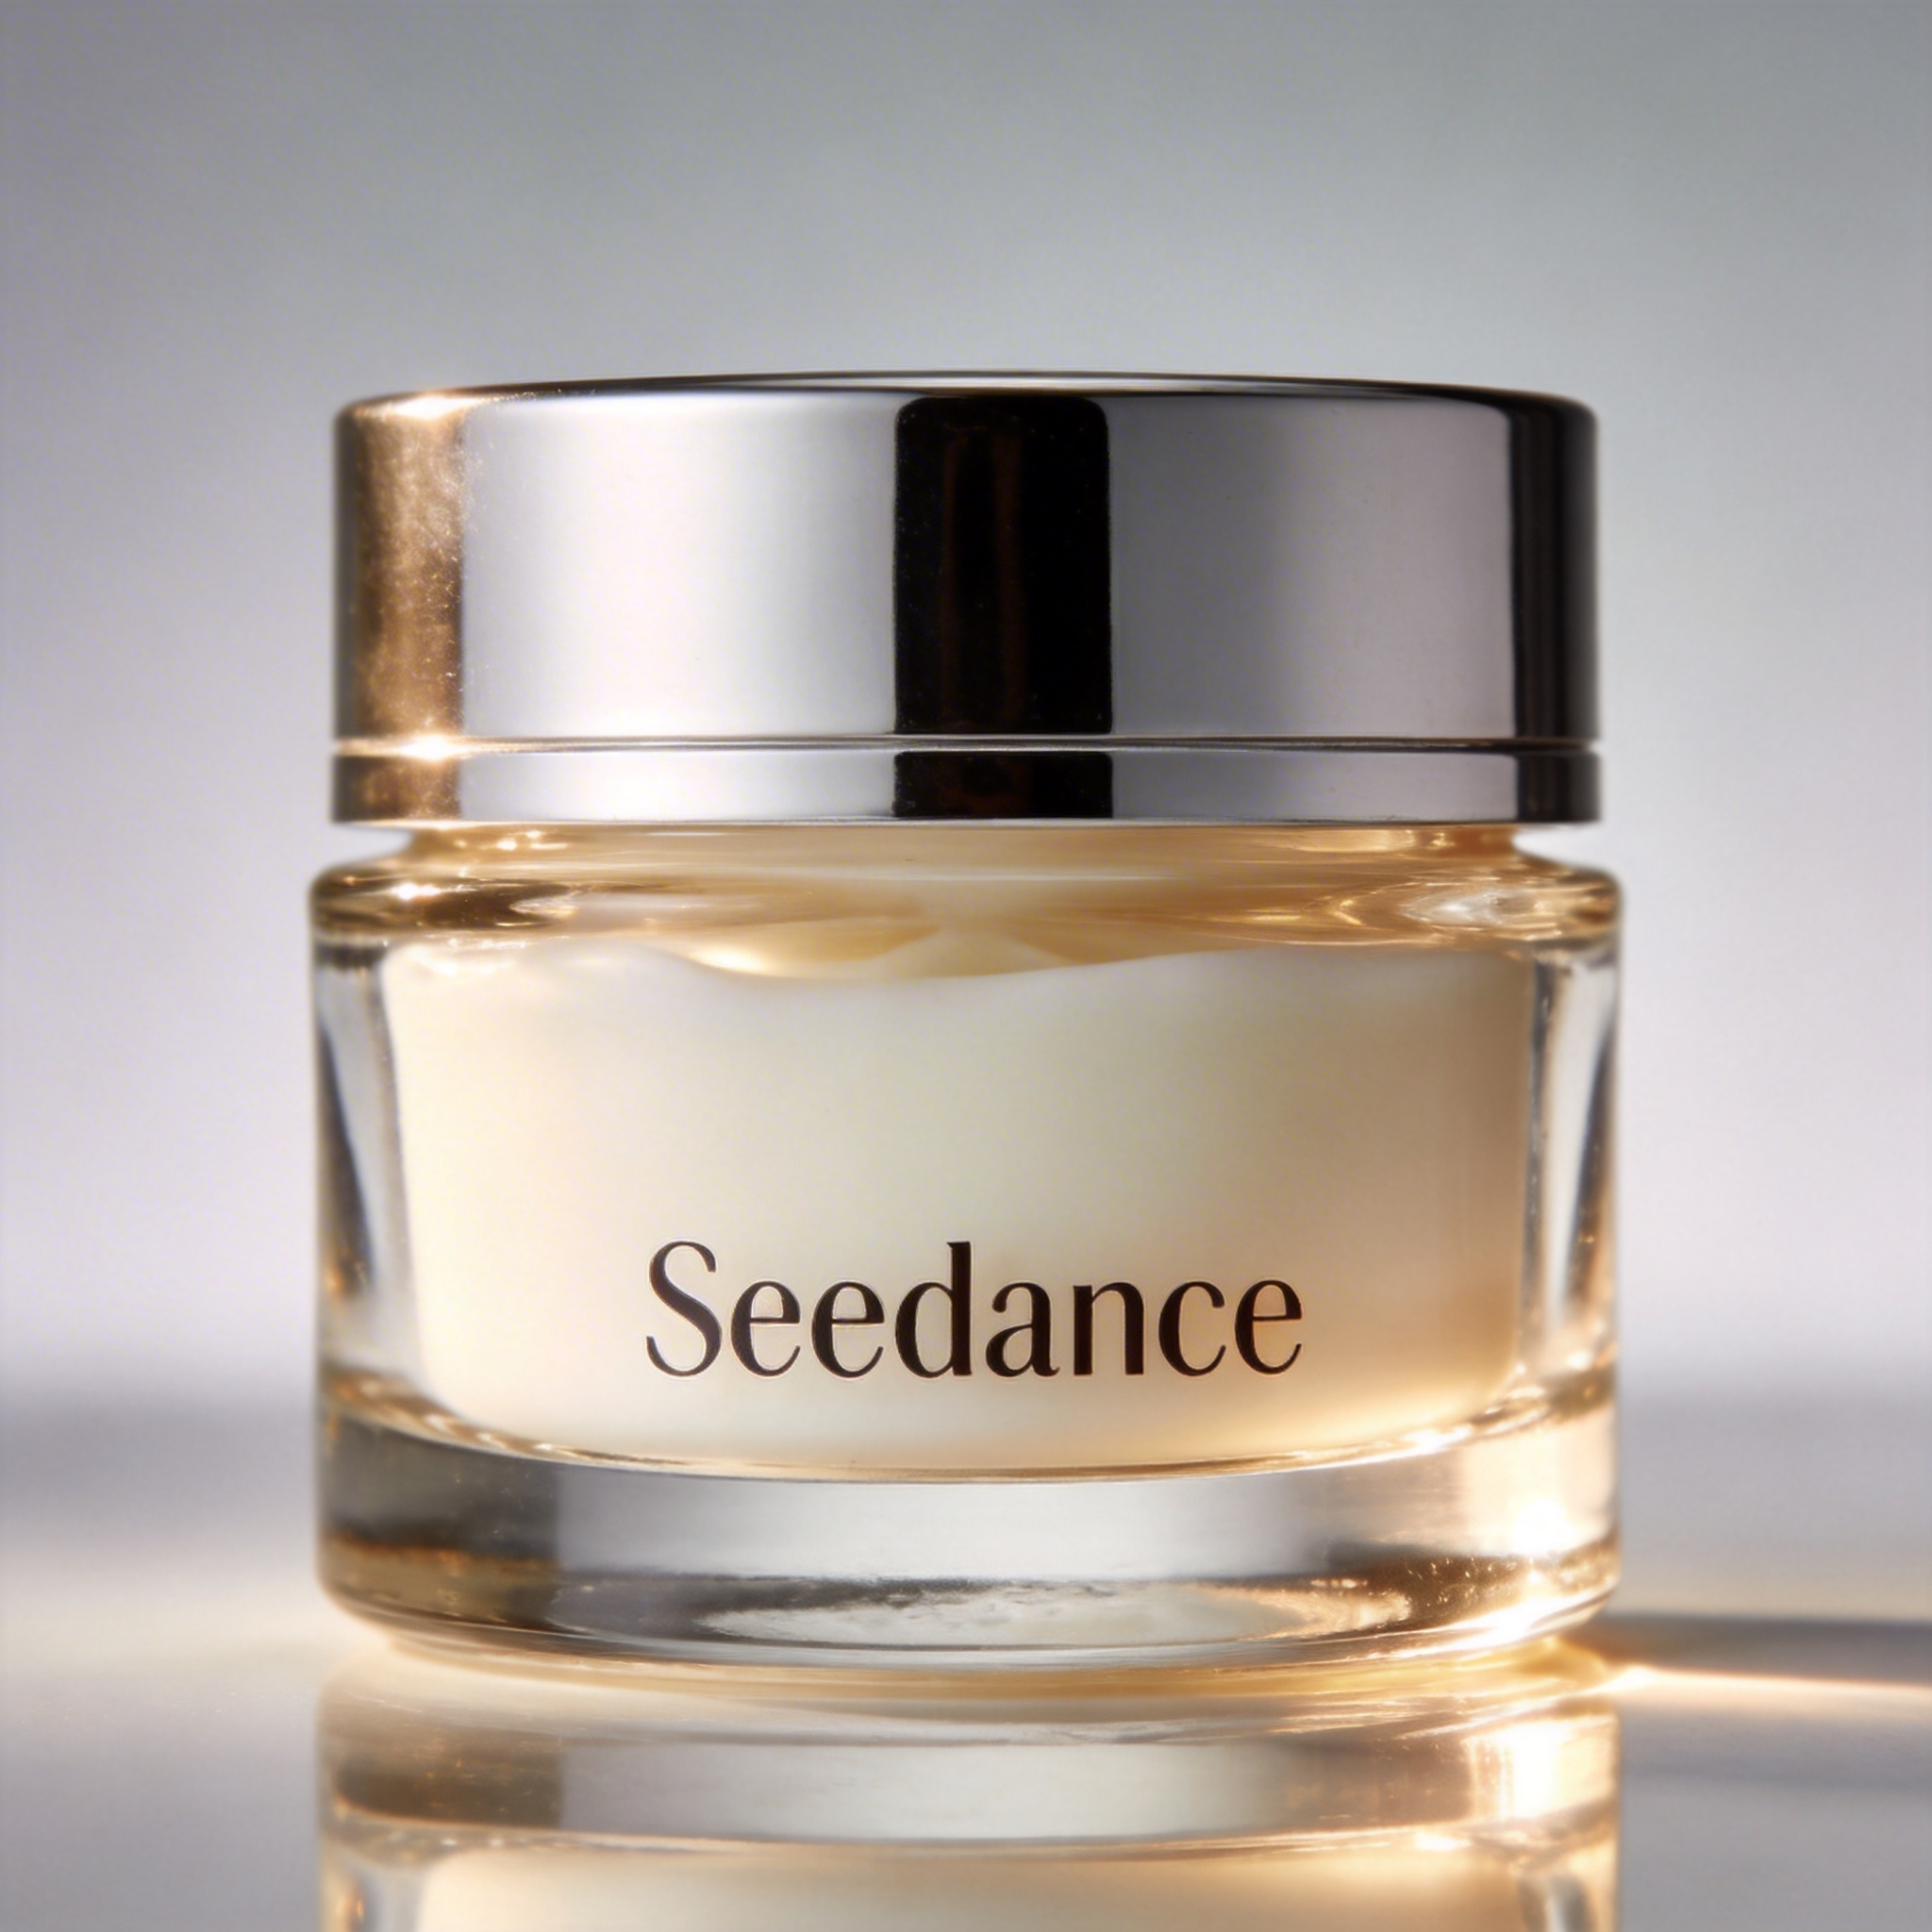
@Image1
@Video1
Промпт
Replace the perfume featured in @Video1 with the face cream from @Image1, with all original motions and camera work preserved.
Продление видео
Продление вперёд порождает содержание после видео. Продление назад продлевает начальный сегмент видео.
Референсы
@Video1
Промпт
Generate the content after @Video1: the two men who are late run towards them, the five people finally meet and have a friendly chat.
Референсы
@Video1
Промпт
Extend the opening segment of @Video1: Set up an over-the-shoulder shot of the man in a hoodie, and the man says: "It's not that bad. You're just stressed. Everyone goes through this, you just need to keep going."
Достройка дорожек
@Video1, затем мост, затем @Video2.
Референсы
@Video1
@Video2
Промпт
@Video1. The moment a leaf falls to the ground, it sets off a special effect of golden particles. A gust of wind blows by, leading into @Video2.
Лимиты одним взглядом
| Семейство Seedance 2.0 | |
|---|---|
| Референсные изображения | До 9 |
| Референсные видео | До 3, по 2–15 с, всего 15 с |
| Референсное аудио | До 3, по 2–15 с, всего 15 с |
| Длина выхода | 4–15 с |
| Разрешение выхода | 2.0: 480p–4K; Fast и Mini: 480p / 720p |
Референсные видео должны быть 480p или 720p при 24–60 fps.