本指南參考官方標準,並在此基礎上做了補充。適用於 Seedance 2.0 系列(2.0、2.0 Fast、2.0 Mini)。好的提示詞,才能讓 Seedance 的效果真正出來。
基礎公式
Seedance 2.0 系列模型支援同時參考影片、圖片和音訊等多模態素材。它可以準確鎖定角色外觀、動作效果、視覺風格、旁白音色等特徵,大大降低撰寫提示詞的門檻。在此基礎上,用一條簡單的基礎公式引導模型,藉助多模態素材的特性,快速生成符合特定要求的影片。
基於參考的影片生成細分為三類任務:全能參考、編輯影片、延長影片。根據任務型別選擇基礎提示詞公式。這三類也可以組合使用。
全能參考
從素材中提取部分元素(例如主體、風格、場景和音效),生成一條全新的影片。
適用場景: 動作遷移、主體複用、氛圍參考,以及類似的工作。
推薦句式:
- 圖片參考: 參考
@Image1中的主體,生成…… - 影片參考: 參考
@Video1中的動作,生成…… - 音訊參考: 參考
@Audio1中的音色,生成……
在本站裡,全能參考就是 多重參考。在提示詞框中輸入 @,然後點選檔案。它會插入為 @Image1、@Video1 或 @Audio1,並按該型別內部的上傳順序編號。每張縮圖都會顯示自己的標記。刪除一個檔案之後,該型別中其餘檔案的標記會重新編號。上面的句式仍然必須寫明你要取的是哪一個元素。單獨一個標記並不能告訴模型,你要的是臉、動作、風格,還是音色。
編輯影片
在原影片的基礎上做區域性或整體修改。沒有提到的部分預設保持不變。
適用場景: 區域性替換、去除主體、屬性修改,以及類似的工作。
推薦句式:
- 新增元素: 清楚描述
@Video1+ 新元素 + 它所在的位置。 - 修改元素: 嚴格編輯
@Video1,並把其中的一個元素修改成另一個。 - 刪除元素: 寫明需要刪除的元素。對於應當保持不變的元素,在提示詞中加以強調,以獲得更好的效果。
延長影片
沿時間維度把原影片接下去,要求音影片風格、主體和敘事保持一致。
適用場景: 延續情節、延長動作、補全片段,以及類似的工作。
推薦句式:
- 延長影片: 將
@Video1向前或向後延長,生成…… - 軌道補全:
@Video1+ 發生了什麼,隨後是@Video2+ 接下來發生什麼。
對於編輯和延長任務,直接指向該影片:寫「嚴格編輯 @Video1」或「將 @Video1 向前延長」。這些任務不要寫「參考 @Video1」。「參考」是全能參考的句式,模型可能把一次編輯或一次延長誤讀成一條全新的片子。
圖生影片 是單獨的模式。首幀和尾幀不能在同一次生成中與參考檔案混用。首幀就是開頭,畫幅跟隨那張圖片。當結尾幀也必須固定時,開啟 新增尾幀,並且只描述這兩幀之間發生的事。生成之前開啟 回傳尾幀。片子準備好之後,接著生成 會把該片段的最後一幀用作下一條片子的首幀,因此銜接被鎖定在一張畫面上。這就是本站以畫面鎖定來接續的方式。當來源是 多重參考 中的一條影片時,官方的延長公式仍然適用。
組合任務
上面三類任務也可以組合使用。
適用場景: 參考一份素材,同時編輯另一份素材。
推薦句式: 從 @Video1 裡取一項,例如運鏡、一種效果或一種音色,再嚴格編輯 @Video2,並且只寫這一處改動。沒有點名的部分保持原樣。
進階公式
Seedance 2.0 本質上是一位多模態 AI 導演:它同時讀取你的文字提示詞、圖片、影片和音訊,並在內部把它們分解為兩個維度,即空間層(畫面裡有什麼)和時間層(事物如何隨時間變化),以此來理解並生成畫面。
一條好的提示詞並不只是文案式的描述,而是一條工程式的指令:誰、在什麼場景、做什麼動作、鏡頭如何運動、事件按怎樣的時間順序發生,分別交給空間層和時間層。
1. 明確主體
在實際被引用的素材中,一張圖片往往包含多個主體。要精確引用素材中的某一個物件,就必須清楚地定義主體。主體可以是人、道具、場景,等等。
基本定義
核心特徵要求:使用 2–3 個清晰且穩定的靜態特徵(例如服裝、髮型、外貌或類別)來描述主體,並確保它能夠被唯一識別。
示例:
- 把
@Image1中穿紅裙子、戴草帽的女人定義為主體 1。 - 把
@Image1中穿紅裙子、戴草帽的女人定義為張紅。
跨多份素材的單一主體
當多份素材中的物件指的是同一個主體時,要把它們一致地繫結在一起。寫明 @Image1 裡的臉和 @Image2 裡的全身照是同一個人。
多主體場景
當一條影片中出現多個主體時,分別定義它們,並用標籤加以區分。標籤必須唯一且穩定,後續描述必須始終使用對應的標籤,以避免引用上的歧義。
示例:把 @Video1 中的高個子男人定義為警察,把另一個矮個子男人定義為小偷。場景設在白天擁擠的市場,陽光明亮,水果攤很多,行人密集,形成熱鬧的街市氣氛。小偷驚慌地穿過擁擠的市場向前跑,警察則全速緊跟在後面。兩人迅速在攤位之間穿行。手持鏡頭快速向前跟拍,帶著輕微而真實的鏡頭晃動,營造出緊張的追逐氣氛。
每次涉及一個主體,都必須明確地指稱它,以免遺漏。支援兩種用法:
- 對於主體尚未定義的簡單場景,每次提到該主體時,都用 @ 來強調主體與素材之間的繫結。例如:張三
@Image1。 - 對於主體已經事先定義的場景,每次提到該主體時,都使用同一個標籤。在
@Video1中的高個子男人被定義為警察、矮個子男人被定義為小偷之後,後面的句子就說警察和小偷,而不是「那個高的」和「另一個人」。
使用素材庫 id 時,你仍然需要 @Image1 或 @Video1 來指稱主體。模型無法直接把素材 id 與參考內容關聯起來,因此不得用素材 id 代替檔案標記。
描述儘量保持簡潔,避免冗餘,也避免語義衝突,例如同一主體出現互相矛盾的特徵。空間關係優先透過參考圖來表達,從而減少複雜的文字描述。
對於人物,一張頭像特寫加上一張全身照就足夠了。這裡不建議使用多視角角色圖,因為一張轉面圖是 ID drift 的常見原因。
2. 鏡頭順序
模型的內部建模把空間和時間拆開。因此,複雜影片理想的提示詞形式,是基於時間線的分鏡:把影片拆成若干個鏡頭,並按照事件發生的順序,動態地描述每一個鏡頭:誰 + 在哪裡 + 做什麼 + 鏡頭如何運動。
使用鏡頭順序。為影片的每一段寫一份簡單的 Shot 1 / Shot 2 / Shot 3 分鏡,然後再把它們合併成一條完整的提示詞。
反面示例:「一個男人緊張地在街上跑,畫面很有電影感。」
正面示例:
- Shot 1:街巷的側面鏡頭;這個男人慢慢開始奔跑,帶著呼吸急促的感覺。
- Shot 2:這個男人撞翻一個水果攤;鏡頭快速晃動,並給出他受驚面孔的特寫。
- Shot 3:這個男人翻過一堵矮牆並消失;鏡頭慢慢拉遠,定格在空無一人的街道上。
使用 Shot 1、Shot 2 和 Shot 3 這樣的標識,按照事件發生的順序組織內容,主要的在前,次要的在後。不要對每一段的時長施加嚴格限制。優先讓模型根據情節自然地生成節奏。模型對精確計時的支援並不穩定,例如 0–3 秒,強行限制時長可能導致生成結果異常。
每個鏡頭按下面的順序來組織:
- 運鏡或鏡頭轉場方式,例如「從遠景緩緩推進」「固定機位」「切到……」。
- 主體的動作與表情。 描述核心角色或物體的關鍵動作,以及表情上的變化。
- 位置或空間變化。 說明主體所在的場景、位置或空間關係。
- 音訊資訊。 描述與該鏡頭對應的音效、人聲和背景音樂。
3. 動作描述要求
身體動作的細化 + 程度的量化。 動作應當具體到雙手、雙腿、頭部、肩膀和背部等身體部位,同時還要補充幅度、速度和力度的描述。例如:慢慢舉起一隻手,快速轉動頭部,用力蹬離地面,頭微微低下。
優先使用緩慢、輕柔、連續的小動作。 優先使用緩慢、輕柔、連貫的細微動作,並儘量避免衝刺、大跳、劇烈翻滾這類高爆發、大動態的動作。例如:慢慢行走,輕輕舉起一隻手,頭微微低下,順著這個動作自然地坐下。
補上動作之間的過渡。 寫明前一個動作與後一個動作之間的慣性和連續性,使畫面上的運動連貫而自然。例如:藉助轉身的慣性,自然地舉起一隻手;從一次停頓自然地過渡到舉手。
情緒的具體外在表現。 用具體的身體細節來表達情緒,替換「很傷心」「非常生氣」這類抽象用詞。
| 抽象情緒 | 外化為動作與細節 |
|---|---|
| 悲傷 | 低下頭,肩膀微微顫抖,眼睛發紅,手指不自覺地攥住衣角,眼淚在眼裡打轉但沒有落下 |
| 喜悅 | 嘴角不受控制地揚起,眉眼放鬆,腳步變得輕快,不自覺地哼起一支曲子,忍不住在原地轉一圈 |
| 緊張 / 焦慮 | 頻繁地看錶,手指不停地敲擊桌面,呼吸急促,目光迅速移開,不自覺地咬指甲 |
| 憤怒 | 雙拳握緊,下頜線繃緊,胸口劇烈起伏,眼神銳利如刀,從咬緊的牙縫裡把字擠出來 |
| 釋然 | 長長地撥出一口氣,緊繃的肩膀完全放鬆,臉上露出久違的淡淡微笑,抬頭望向遠處 |
4. 運鏡提示
模型對運鏡術語有很強的理解,因此可以直接使用標準的運鏡術語,例如中景、特寫、遠景、緩慢推進、平穩橫移、固定鏡頭。
儘量在單個鏡頭中只指定 1 種運鏡。不要同時要求推、拉、搖和移,因為這會增加畫面的不穩定性。
5. 畫質、風格與約束詞
畫質、風格和約束詞是控制影片生成結果的關鍵。它們可以為模型劃定創作邊界,統一畫質與藝術調性,並避免視覺瑕疵和隨機偏差,因此是確保最終輸出穩定且合規所必需的配置。
- 畫質。 定義畫面的清晰度、細節紋理和光線質量,以提升最終影片的基礎畫質。例如:高畫質、豐富的細節、電影質感、自然的色彩、柔和的光線。
- 風格。 設定整體的藝術風格和視覺調性,以統一畫面的藝術氣氛。例如:賽博朋克冷調藍紫色、復古膠片、清新的日系風格。
- 約束詞。 約束詞非常重要。它們可以有效避免視覺瑕疵、畸形、崩壞和不合理的元素,並約束生成的邊界與穩定性。
常用的約束詞模板:
- 避免生成字幕: "keep it subtitle-free"、"avoid generating any text or subtitles"。
- 避免生成標誌: "do not generate a logo"。
- 避免生成水印: "do not generate a watermark"。
6. 案例
下面兩個例子展示如何使用上面的進階公式。對白留在花括號中,這是特殊字元規範裡的對白標記。
示例 1:宿舍情感短劇(以對白為重點)
素材準備:
@Image1:女主的半身照片@Image2:宿舍場景參考圖@Video1:室內對白的運鏡參考(中景推軌進入/拉出,或輕微搖鏡)@Audio1:室內環境聲或輕音樂
Use the girl in @Image1 as the main character, use @Image2 as the dormitory scene style reference, and refer to the camera movement in @Video1.

Shot 1: At dusk, girl @Image1 walks briskly to the dormitory entrance @Image2. The camera follows steadily in a medium shot. Warm yellow sunlight spills into the hallway from the window. She pauses at the doorway, takes a deep breath, and looks slightly nervous.

Shot 2: Girl @Image1 pushes the door open and enters the dormitory. The camera cuts to an indoor medium shot. Her roommates look up at her while organizing their books. One of them smiles and asks {How did the exam go? Did you pass?}. The camera slowly cuts between half-body close-ups of several people.

Shot 3: Girl @Image1 first lowers her head with a dejected expression. The camera gives her a close-up. Then she raises her head, unable to hold back a smile, laughs out loud, and says {I was kidding}. Her roommates start chasing and play-fighting with her. The camera slowly pulls back and freezes on a wide shot of the dormitory filled with laughter.

The entire video should have a high-definition cinematic documentary style, with warm tones and soft lighting. The character's face remains stable without deformation; movements are natural and smooth, with no stutter or flicker. The ambient sound blends naturally with @Audio1.
中文:
以 @Image1 裡的女孩為主角,用 @Image2 作為宿舍場景的風格參考,運鏡參考 @Video1。

鏡頭 1:黃昏,女孩 @Image1 快步走到宿舍門口 @Image2。鏡頭以中景穩定跟隨。暖黃色的陽光從窗戶灑進走廊。她在門口停住,深吸一口氣,看起來有點緊張。

鏡頭 2:女孩 @Image1 推開門走進宿舍。鏡頭切到室內中景。室友們收拾書本,抬起頭看她。其中一個人笑著問 {How did the exam go? Did you pass?}。鏡頭在幾個人的半身特寫之間慢慢切換。

鏡頭 3:女孩 @Image1 先低下頭,神情沮喪。鏡頭給她一個特寫。然後她抬起頭,忍不住笑出來,大聲說 {I was kidding}。室友們開始追著她打鬧。鏡頭慢慢拉遠,定格在充滿笑聲的宿舍全景。

整支影片是高畫質電影感紀錄片風格,暖色調,光線柔和。人物的臉保持穩定,不變形;動作自然順滑,沒有卡頓或閃爍。環境聲與 @Audio1 自然融合。
示例 2:古風懸崖對峙(以動作與氣氛為重點)
素材準備:
@Image1:紅衣女主@Image2:黑衣刺客(對手)@Image3:懸崖與竹林的場景圖@Video1:武術對峙的運鏡參考@Audio1:緊湊的鼓點或打鬥音效
Use the woman in red from @Image1 as the female lead, use the woman in black from @Image2 as the opponent, use the cliff and bamboo forest environment in @Image3 as the scene reference, refer to the overall camera movement and action rhythm in @Video1, and synchronize the background sound effects with @Audio1.

Shot 1: At dusk, the camera slowly pushes in from a side medium shot of woman in red @Image1. She stands at the edge of the cliff and lifts a wine flask to drink. Her sleeves and robe hem sway gently in the mountain wind. The camera circles halfway around her, moving from the front to her back. In the distance, a figure in black is faintly visible in the bamboo forest.

Shot 2: The camera zooms and fades into a long shot. From a drone perspective, it overlooks the entire cliff and bamboo forest. The two characters stand at opposite ends of the cliff. The mountain wind lifts their robe hems and dust, and the rhythm slightly accelerates with the drum beats.

Shot 3: The camera cuts back to a ground-level close shot. The two slowly draw their swords and face off. Woman in red @Image1 shifts from a careless expression to a cold gaze. Woman in black @Image2 looks determined, and the sword tip trembles slightly. The camera steadily follows the two as they circle each other, finally freezing on a close-up of the instant before the two swords meet.

The overall visual style should feel like a cinematic wuxia world in misty rain, with cool tones, low saturation, a film-grain texture, and rich light-and-shadow layers. The characters' faces and body proportions remain stable without deformation. Movements are continuous and natural, not stiff, with no clipping or stutter.
中文:
以 @Image1 裡的紅衣女子為女主,以 @Image2 裡的黑衣女子為對手,以 @Image3 裡的懸崖和竹林為場景參考,整體運鏡和動作節奏參考 @Video1,背景音效與 @Audio1 同步。

鏡頭 1:黃昏,鏡頭從紅衣女子 @Image1 的側面中景慢慢推進。她站在懸崖邊,舉起酒壺喝酒。衣袖和衣擺在山風裡輕輕擺動。鏡頭繞著她轉過半圈,從正面轉到背後。遠處竹林裡隱約有一個黑衣人影。

鏡頭 2:鏡頭變焦、淡入到遠景。從航拍視角俯瞰整座懸崖和竹林。兩個人站在懸崖的兩端。山風揚起衣擺和塵土,節奏隨著鼓點略微加快。

鏡頭 3:鏡頭切回地面近景。兩人慢慢拔劍對峙。紅衣女子 @Image1 從漫不經心變成冷冷的注視。黑衣女子 @Image2 神情堅定,劍尖微微發顫。鏡頭穩定跟隨兩人繞圈,最後定格在兩劍相接前一瞬的特寫。

整體視覺像煙雨中的電影武俠世界,冷色調,低飽和,帶膠片顆粒,光影層次豐富。人物的臉和身體比例保持穩定,不變形。動作連續自然,不僵硬,沒有穿模或卡頓。
其他技巧
文字生成
Seedance 2.0 系列模型支援生成常見的文字。模型可以根據上下文自動匹配合適的風格和顏色,也支援在提示詞中指定文字的顏色、風格、出現方式、出現時機和出現位置。撰寫時優先使用常見字元,避免生僻字和特殊符號,以確保最佳的呈現效果。目前支援廣告口號、字幕和對話氣泡等場景。案例在最後一節。
口號提示詞要寫清文字內容、出現時機、位置、入場方式,再加上顏色和字型風格。
Seedance 2.0 可以根據上下文匹配合適的文字風格。如果對文字呈現有嚴格要求,請使用多圖參考之下的標誌示例。
字幕提示詞模板:在底部居中顯示帶有該文字的字幕。字幕必須與音訊的節奏和步調完全同步。
影片延長與分段拼接
- 連續長鏡頭(影片延長): 適合單一場景內的對白場面,例如長對話、情緒的推進,以及沿一條路徑的移動,以達到沉浸且連貫的一鏡到底效果。
- 場景 / 動作轉折點(分段拼接): 適合情節轉折,或複雜、節奏很快的動作場面,例如追逐、打鬥和蒙太奇。可以分別生成獨立片段,再剪輯到一起,以確保節奏和視覺衝擊力。
在實際製作中,這兩種方法通常會結合起來使用。例如,先用延長生成一段連貫的對話,再拼入空鏡頭或轉場片段,在沉浸感與節奏變化之間取得平衡。
素材配置策略
素材通常分為四種功能角色:
- 角色錨定: 鎖定角色外觀。
- 場景定調: 鎖定環境與風格。
- 運鏡參考: 鎖定鏡頭語言和動作節奏。
- 節奏氣氛: 用音訊來控制情緒和音色。
推薦的配置,合計 4–5 份素材:1–2 張角色圖片(面部特寫 / 全身)+ 1 張場景圖片 + 1 條運鏡影片 + 1 條音訊。
不建議把素材數量用到上限。素材過多會讓模型難以判斷各項特徵的優先順序,這很容易造成風格衝突、主體識別模糊,以及生成結果偏離預期。
在 Seedance 2.0 系列中,音訊不能單獨與文字搭配。請至少把一張圖片或一條影片與音訊一起加入。
注意事項
語言規範
對白的語言必須保持一致,應當避免中英文混用,專有名詞除外。
特殊字元規範
在提示詞中合理地使用符號,有助於模型準確地理解不同的資訊型別。
| 資訊型別 | 符號 | 示例 |
|---|---|---|
| 音樂 | () | (背景正在播放快節奏搖滾) |
| 音效 | 官方表格把這個符號留空。用文字描述聲音,寫在該鏡頭的音訊一行裡。 | |
| 對白 | {} | {Hello, world}。如果對白使用的是既非中文也非英文的較少見語言,就必須標明語言,例如:用日語說 {こんにちは} |
| 字幕 | 【】 | 【第一章:出發】 |
常見問題
臉部參考不準
典型症狀。 生成的角色外觀與參考圖不一致,或者影片中途發生換臉(ID drift),導致影片中的角色像某位名人,並在稽核時被攔截。
根本原因。 臉部參考圖的有效性不足。
- 參考圖混在一起。 給模型的是一張合在一起的圖片,其中同時包含臉部參考、全身或半身的姿勢參考、服裝參考、細節參考以及其他參考元素。
- 臉部佔比過小。 在混合參考圖中,臉部區域佔整張圖片的比例過小。模型在提取面部特徵時分配給它們的權重不足,並且很容易受到背景或其他元素的干擾。
解決辦法。 加強臉部參考的獨立性與權重。
- 準備一張臉部特寫圖片。在原來的全身照之外,再額外準備一張只包含角色頭部的臉部特寫。一張頭像特寫,只保留臉部。沒有表情最好。儘量減少肩膀、脖子和背景等干擾元素。
- 在提示詞中清楚地定義主體:五官參考頭像特寫,妝容和造型參考全身照。
- 把重要的素材放在前面。一份素材越是需要精確參考,就越應當在提示詞中更靠前的位置出現。
對於角色參考,使用頭像特寫 + 全身照就足夠了。不建議使用多視角角色圖。多視角素材包含同一角色的不同角度,模型很容易把它們識別成多個不同的主體,這反而會加重 ID drift 的問題。
之前:影片中的角色中途換了臉,並且像某位名人。之後:整段影片中,臉都與參考圖保持一致。
改法
Prepare a close-up face image containing only the character's head, in addition to the full-body photo. No expression is best. Minimize shoulders, neck, and background. In the prompt: facial features reference the headshot, makeup and styling reference the full-body photo. Place the asset that needs precise reference earlier. A headshot plus a full-body photo is sufficient. Multi-view character images are not recommended: the model may identify them as multiple different subjects, which worsens ID drift.
中文
除了全身照,再準備一張只有頭部的臉部特寫,最好沒有表情。肩膀、脖子和背景盡量少。提示詞裡寫:五官參考頭像特寫,妝造參考全身照。需要精確參考的素材放得更靠前。一張頭像特寫加一張全身照就夠了。不建議用多視角角色圖:模型可能把它們識別成好幾個不同的人,ID drift 會更嚴重。
影片中意外出現字幕
典型症狀。 提示詞並沒有要求字幕,但生成的影片中含有字幕。
解決辦法。 無法直接 100% 避免生成字幕。只能降低機率,並提高成功率。
- 在提示詞中加入明確的約束指令:"Keep it subtitle-free" 以及 "Avoid generating any text or subtitles"。
- 如果參考圖片或參考影片中含有並非必要的文字,先去掉這些文字,使用圖片編輯或影片編輯,然後再把不含文字的素材作為輸入。
- 如果用途允許,優先生成橫屏尺寸的影片。橫屏中生成字幕的機率明顯低於豎屏。之後可以在剪輯軟體裡把它裁成豎屏。
影片中出現標誌或水印
典型症狀。 提示詞沒有提到與水印相關的內容,但生成的影片中出現了來自另一個影片平臺的標誌或水印。
解決辦法。 在提示詞中加入明確的約束指令:"Do not generate watermarks" 以及 "Do not generate Logos"。
風格漂移
典型症狀。 你期望生成的是 2D 或 3D 動畫風格,但輸入的參考圖風格相對寫實,而且提示詞沒有強調影片風格。結果,生成的影片可能會漂移成真人實拍的寫實風格。
解決辦法。 在提示詞中加入明確的風格約束詞,例如 "2D Japanese anime style" 或 "3D Chinese-style comic"。如果需要更精確的風格控制,先把參考圖轉換成目標風格,再生成影片。
之前:仙俠風格漂移成真人實拍風格。之後:保持三維中國動畫 CG 仙俠風格。
提示詞
Add an explicit style constraint, such as "2D Japanese anime style" or "3D Chinese-style comic". The after example maintains the 3D Chinese animation CG xianxia style. If more precise style control is required, first convert the reference image into the target style, then generate the video.
中文
加上明確的風格限制,例如 "2D Japanese anime style" 或 "3D Chinese-style comic"。修改後的例子保持 3D 中國動畫 CG 仙俠風格。如果需要更精確地控制風格,先把參考圖轉成目標風格,再生成影片。
影片延長的銜接處出現跳切
典型症狀。 使用影片延長生成新影片之後,把新影片與原影片拼接時,接縫處可能出現跳幀或內容回退的問題。
解決辦法。 目前的建議是在後期剪輯中透過對齊關鍵幀來修復。根本性的最佳化將透過未來的模型迭代來實現。
- 把需要拼接的影片匯入 CapCut 或其他專業的影片剪輯軟體。
- 在第一個接縫處,從前一段影片的結尾剪掉 6 幀。
- 同時,從後一段影片的開頭剪掉 1 幀。
- 對所有拼接點重複上述操作。
- 匯出,並檢查拼接後的影片是否流暢。
影片幀對齊之後,輕微的跳躍仍可能存在。建議讓較早的那一段在一次轉場切點的瞬間結束,並讓下一條影片從這次切點之後的新場景開始。
之前:過渡點會出現瞬間的畫面跳躍或內容回退。之後:過渡更加順暢。
改法
Repair the join in post-editing by aligning keyframes. At the first join, trim 6 frames from the end of the previous video segment, and trim 1 frame from the beginning of the following video segment. Repeat for all stitching points.
中文
在後製裡對齊關鍵幀,修接縫。第一處接縫:上一段影片末尾剪掉 6 幀,下一段影片開頭剪掉 1 幀。每個拼接處都這樣處理。
角色重複
典型症狀。 在畫面中角色很多、並且提供了三檢視角色圖作為參考素材的場景裡,同一幀生成畫面中很容易出現兩個一模一樣的角色。
根本原因。
- 提示詞中沒有清楚地定義角色主體,因此模型無法準確地分辨不同的角色身份。
- 當角色的三檢視或多視角圖片被用作參考素材時,很容易擾亂模型對角色的識別,導致它生成外貌相同的重複角色。
解決辦法。 無法直接 100% 避免雙胞胎問題。下面的方法只能降低它發生的機率,並提高成功率。
- 清楚地寫明角色與主體的對應關係。 在提示詞中清楚地定義每一個角色身份,並寫明身份與參考圖之間的對應關係。在每個角色名字後面標出對應的參考圖,並保持格式一致。示例:張三(對應圖片 1)把綠色存摺扔向李四(對應圖片 2),而李四當時正站著。
- 加入全域性約束指令。 在提示詞末尾加入一條固定約束:在整段影片中,禁止出現外觀、服裝和配飾完全相同的角色。不要生成重複的頭像或雙胞胎效果。同一畫面中只保留一個對應的角色,不要再複製出角色的重複副本。
- 最佳化參考素材。 角色參考圖優先使用獨立的單人照片。不建議使用三檢視或多視角素材。
- 簡化並最佳化提示詞。 不要直接把完整的劇本當作提示詞。過於冗長的文案很容易讓模型的理解發生混亂。去掉無關的描述,確保指令清楚而且集中。
之前:影片中出現雙胞胎。之後:每個角色只有一個人。
改法
Clearly define each character role and the corresponding reference image, and keep the format consistent. Example: Zhang San (corresponding to image 1) throws the green passbook toward Li Si (corresponding to image 2), who is standing. At the end of the prompt: Throughout the video, characters with completely identical appearance, clothing, and accessories are prohibited. Do not generate duplicate avatars or a twin effect. Keep only a single corresponding character in the same frame, and do not reproduce repeated copies of characters. Prioritize independent single-person photos. Three-view or multi-view assets are not recommended. Do not paste the complete script as the prompt.
中文
把每個角色和對應的參考圖寫清楚,格式保持一致。例如:張三(對應 image 1)把綠色存摺扔向站著的李四(對應 image 2)。提示詞結尾寫:整段影片禁止出現外觀、服裝、配飾完全相同的角色。不要生成重複的人,也不要雙胞胎效果。同一畫面裡每個角色只保留一個,不要複製出重複的人。優先用單獨的單人照片。不建議用三視圖或多視角素材。不要把完整劇本直接貼成提示詞。
影片延長過程中畫質下降
典型症狀。 當把模型生成的影片用作延長和續寫的輸入素材時,會出現畫質下降。多次續寫會讓這種下降疊加,角色臉部區域尤其容易出現斑駁的色塊。
解決辦法。 下面的方法可以減輕畫質下降。根本性的最佳化稍後會透過模型迭代來進行。
- 把原影片轉換成純白三維模型影片,然後再把它用作續寫的輸入素材。參考提示詞:把影片轉換成純白三維模型。所有角色都應統一為純白三維模型,沒有顏色、沒有紋理、沒有陰影;使用純白背景,結構穩定,動作平滑。
- 優先把高畫質圖片用作參考素材。
- 合理地控制影片續寫的次數,避免反覆疊加的續寫。
之前:直接基於模型輸出進行續寫。之後:先把模型輸出轉換成純白三維模型影片,再進行續寫。
提示詞
Convert the video into a white 3D model. All characters should be unified as pure white 3D models, with no color, no texture, and no shadows; use a pure white background, stable structure, and smooth motion. Then continue from that white-model video. Prioritize high-definition images as reference assets, and avoid repeated stacked continuations.
中文
把影片轉成白色 3D 模型。所有角色統一成純白 3D 模型,沒有顏色、沒有紋理、沒有陰影;純白背景,結構穩定,動作順滑。然後從這段白模影片繼續往後生成。優先用高畫質圖片做參考素材,避免一次次疊著延長。
特效不符合預期
典型症狀。 當透過提示詞文字描述某一種特定特效時,效果可能不符合預期。例如,如果提示詞指定數字 "2999" 以倒計時動畫的方式出現,實際生成的數字滾動效果可能會隨機跳動,無法遵循標準的倒計時邏輯。
解決辦法。 用一條參考影片來定義這種特效。把目標特效影片作為參考素材輸入模型,這樣模型就能準確地理解效果的形態和運動邏輯,生成結果也會更符合預期。例如:數字 "2999" 的出現方式應當參考 @Video1。
之前:數字滾動效果有明顯的紊亂跳動感。之後:加入正確的數字滾動特效影片之後,效果結果符合預期。
參考素材
@Video1
提示詞
The way the number "2999" appears should reference @Video1.
中文
數字 "2999" 的出現方式參考 @Video1。
參考角色過多
典型症狀。 當參考人物的數量超過 4 個時,模型輸出的穩定性會下降,生成的影片可能出現人數不正確(例如角色過少或過多)或角色重複等問題。
解決辦法。 可以透過下面的方式來減輕。未來會基於模型迭代進行根本性的最佳化。
- 分步生成圖片。 把人物分組,確保每一張生成圖片中的人數不超過 4 個。例如,6 個人可以分成每組 3 人的 2 組,並分別生成圖片。
- 由圖片生成影片。 把第一步生成的多張分組圖片作為參考素材,然後生成最終的影片。
之前:輸入 8 個參考角色,輸出影片中有 9 個人。之後:先由這 8 個角色生成 2 張圖片,再使用圖生影片。
改法
When the number of reference people exceeds 4, group them so that each generated image contains no more than 4 people. For example, 6 people can be divided into 2 groups of 3. Generate those images first, then generate the video from the grouped images.
中文
參考人物超過 4 個時,分組生成,每張圖裡不超過 4 個人。例如 6 個人可以分成 2 組,每組 3 人。先生成這些圖,再用分組後的圖生成影片。
影片結尾的噪音
典型症狀。 當影片包含旁白時,影片結尾很容易出現突兀的咔嗒聲和切斷噪音。
解決辦法。 重新生成影片,或者使用 CapCut 等剪輯軟體,透過音量包絡對結尾音軌做音訊淡出處理,消除切斷噪音。
具體步驟,以 CapCut 為例:
- 把生成的影片匯入 CapCut。
- 在時間線上選中影片軌道,並點選工具欄中的 Audio。
- 選擇音量包絡功能。在某些版本中,它位於 Basic / Adjust 選單。選擇關鍵幀。音軌上會出現一條代表音量的線,以及關鍵幀。
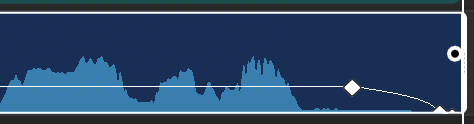
- 在靠近影片結尾的位置,把最後一個音量關鍵幀向下拖到音量 0,形成一段向下的斜坡。卡片上的曲線就是那段斜坡。
- 預覽並確認結尾音訊自然淡出,沒有突然的切斷,也沒有噪音。
之前:結尾有噪音。之後:結尾沒有噪音。
參考素材
@Image1
改法
Regenerate the video, or fade the ending audio to silence with a volume envelope. Near the end, drag the final volume keyframe down to 0 so the curve in @Image1 forms a downward slope.
中文
重新生成影片,或者用音量包絡把結尾的聲音淡出到靜音。靠近結尾時,把最後一個音量關鍵幀拖到 0,讓 @Image1 裡的曲線向下斜。
中文發音不準
典型症狀。 模型容易把多音字、生僻字以及字形相近的字讀錯。
解決辦法。 可以把容易讀錯的文字替換成發音相同的常用同音字,以避免發音偏差,並恢復預期的音訊效果。這個辦法只是一種最佳化方法,並不能完全避免所有的發音問題。
示例:可以在提示詞裡把「螭龍山」改寫成同音的「吃龍山」。
之前:「螭龍山」裡「螭」的發音不正確。之後:改成「吃龍山」之後,發音是正確的。
提示詞
Replace text that is easy to misread with a commonly used homophone of the same pronunciation. Rewrite "螭龙山" as "吃龙山". This is an optimization and cannot completely avoid all pronunciation issues.
中文
把容易讀錯的字換成同音的常用字。把 "螭龙山" 改寫成 "吃龙山"。這是優化辦法,不能完全避免所有發音問題。
聲音參考不準
典型症狀。 使用參考音訊來指定聲音時,最終生成影片裡的聲音與參考聲音相差很大。
解決辦法。
- 在提示詞中加入對聲音特徵的詳細描述。本示例中實際使用的那一句是:use the low, thick, warm, and finely grainy middle-aged male voice of
@Audio1。 - 讓影片臺詞的風格接近參考音訊的語氣和表達方式,這有助於提高聲音的還原度和穩定性。
在 多重參考 中,這個檔案是 @Audio1。在 Seedance 2.0 系列中,把音訊與至少一張圖片或一條影片搭配使用。
之前:聲音與輸入的音訊不相符。之後:在提示詞中加入聲音特徵的描述之後,聲音匹配的準確度明顯提高。
參考素材
@Audio1
提示詞
Use the low, thick, warm, and finely grainy middle-aged male voice of @Audio1. Keep the style of the lines close to the tone and expression of that reference audio.
中文
使用 @Audio1 裡那種低、厚、暖、帶細顆粒感的中年男聲。台詞的風格貼近這段參考音訊的語氣和表達。
提示詞示例
這一節展示文字生成、圖片參考、影片參考和影片編輯的官方提示詞示例。每張卡片上的提示詞都保留官方原句。對白和畫面上的文字保持不變。@Image1、@Video1 和 @Audio1 是本站用來表示 Image 1、Video 1 和 Audio 1 的標記。官方提示詞中寫到的 Image 1、Image 2 和 Image 3,是一張參考圖上的標籤,而這張圖本身是單個檔案 @Image1。
口號
口號提示詞要寫清文字內容、出現時機、位置、入場方式,再加上顏色和字型風格。
Seedance 2.0 可以根據上下文匹配合適的文字風格。如果對文字呈現有嚴格要求,請使用多圖參考之下的標誌示例。
參考素材
@Image1
提示詞
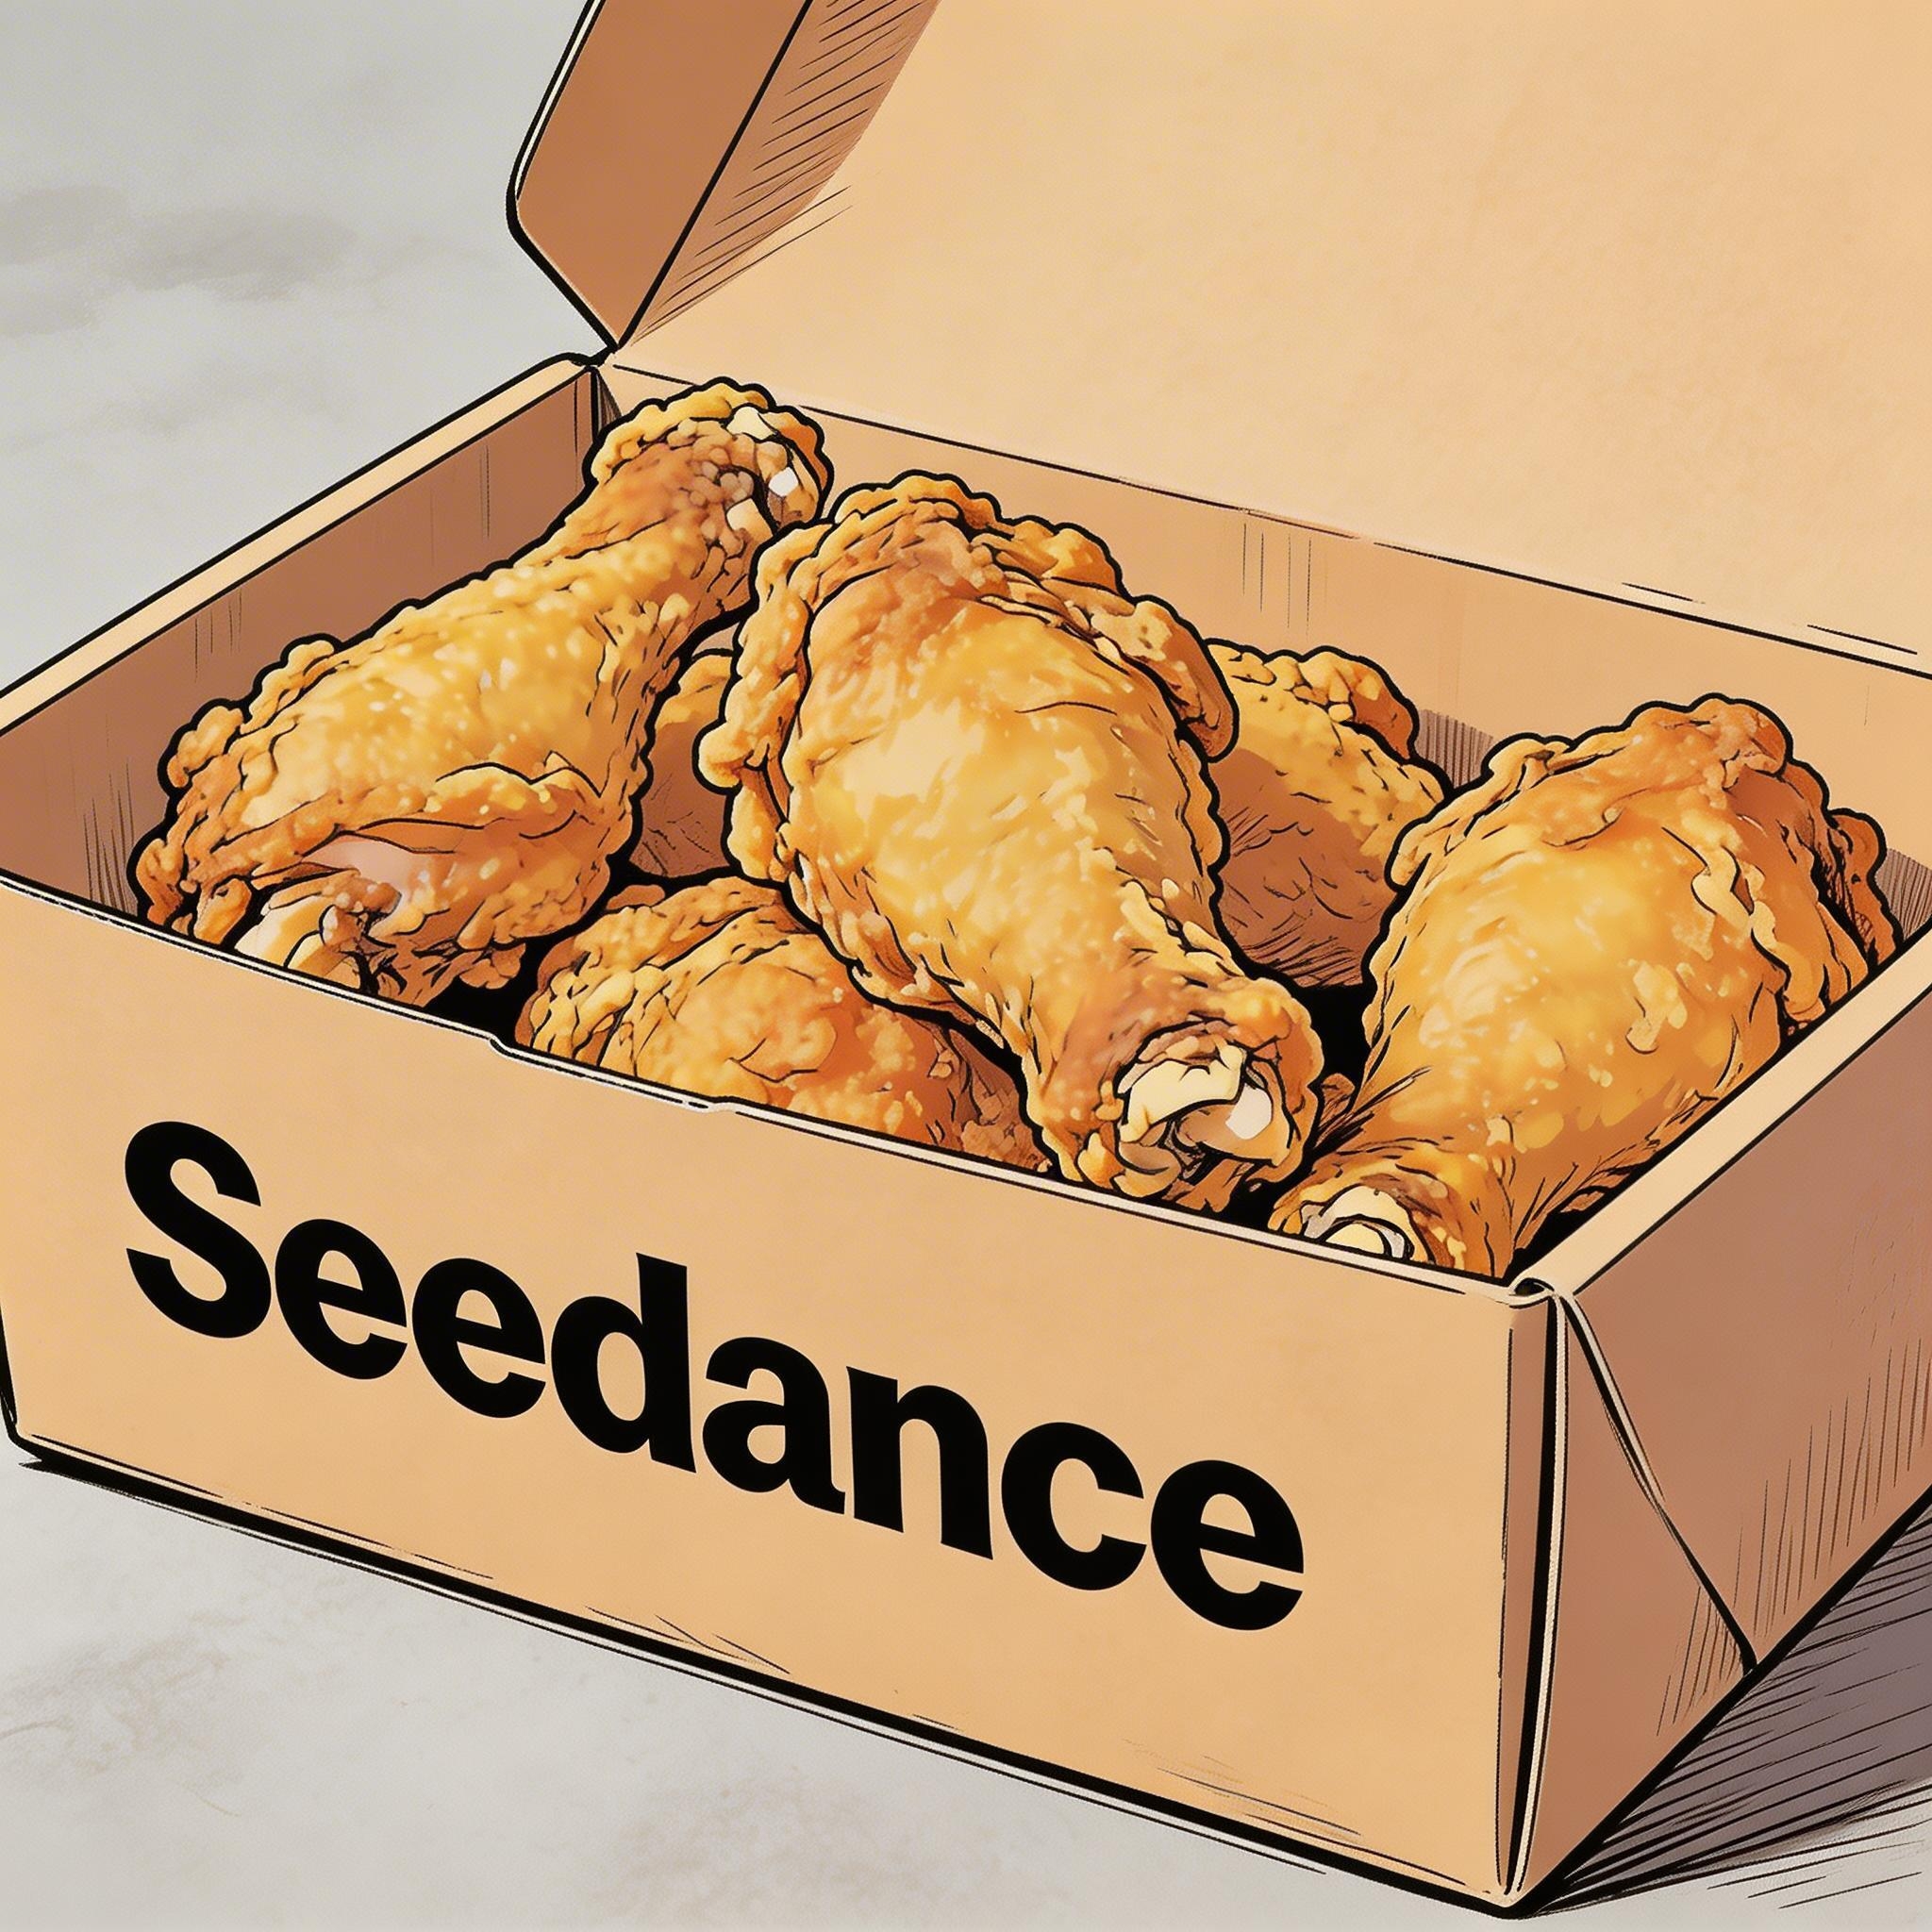
Hand-drawn comic style: Three people are sitting around a table enjoying the fried chicken shown in @Image1, with a friendly and joyful atmosphere. The frame then gradually blurs, and the text "Bite", "Laugh", and "Seedance" in order appears in the center of the screen.
中文
手繪漫畫風格:三個人圍坐在桌邊,享用 @Image1 裡的炸雞,氣氛友好、愉快。隨後畫面逐漸模糊,螢幕中央依次出現文字 "Bite"、"Laugh"、"Seedance"。
字幕
提示詞模板:在底部居中顯示帶有該文字的字幕。字幕必須與音訊的節奏和步調完全同步。
第一個例子是旁白。第二個是配音。
參考素材
@Image1
提示詞
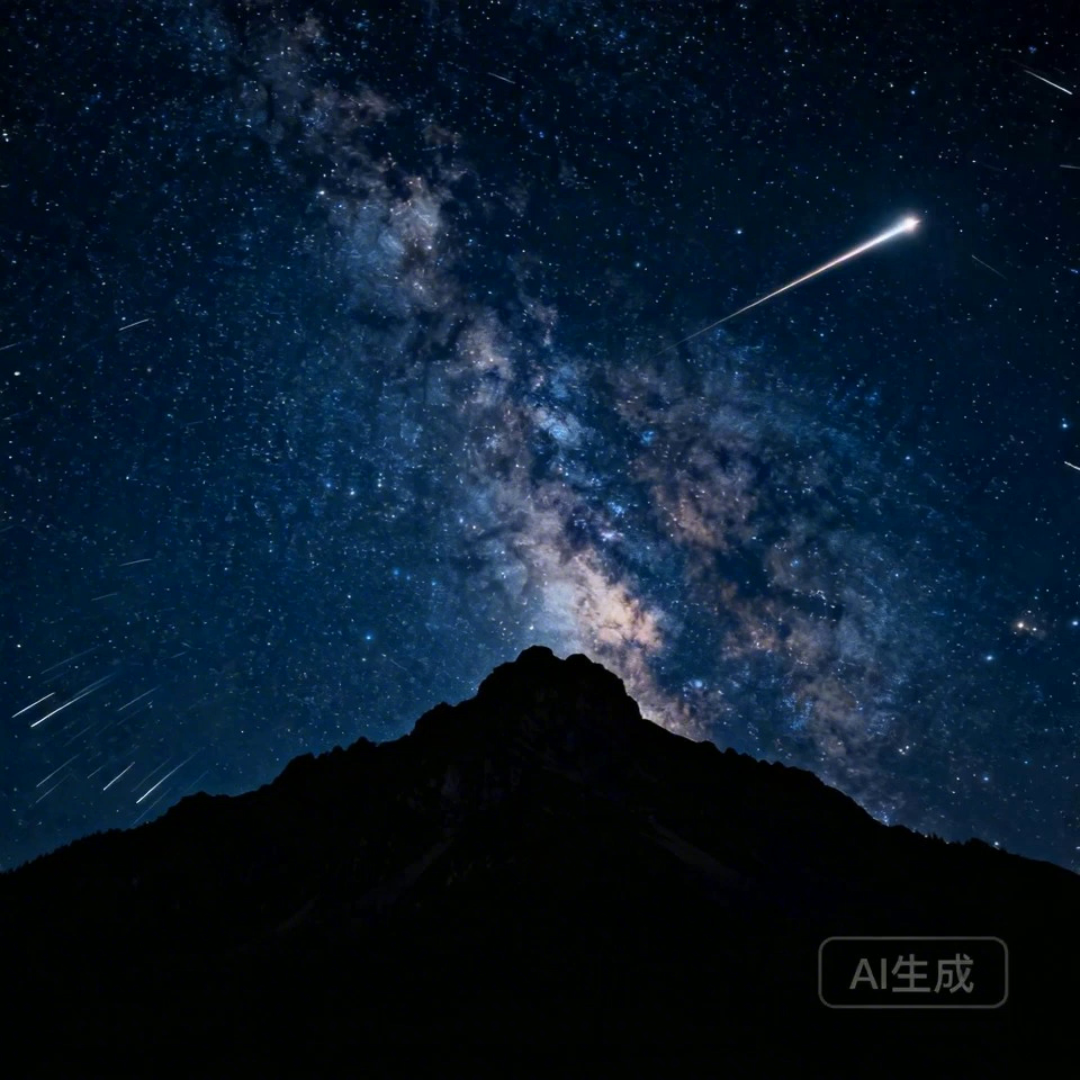
I2V: A time-lapse of a mountain landscape transitioning from a vast, starry night to a vibrant dawn. Reference @Image1. Voiceover: A deep, serene male voice says: "In the vast silence of the cosmos, our world is but a fleeting moment. Yet, within it, life defiantly thrives." Text integration: Render the narration as subtitles at the bottom-center. Subtitles must be perfectly synchronized with audio timing.
中文
I2V:山景延時,從遼闊的星空夜色過渡到明亮的黎明。參考 @Image1。旁白:低沉、平靜的男聲說:"In the vast silence of the cosmos, our world is but a fleeting moment. Yet, within it, life defiantly thrives." 文字:把旁白做成字幕,放在畫面底部置中。字幕必須與音訊時間完全同步。
參考素材
@Image1
提示詞
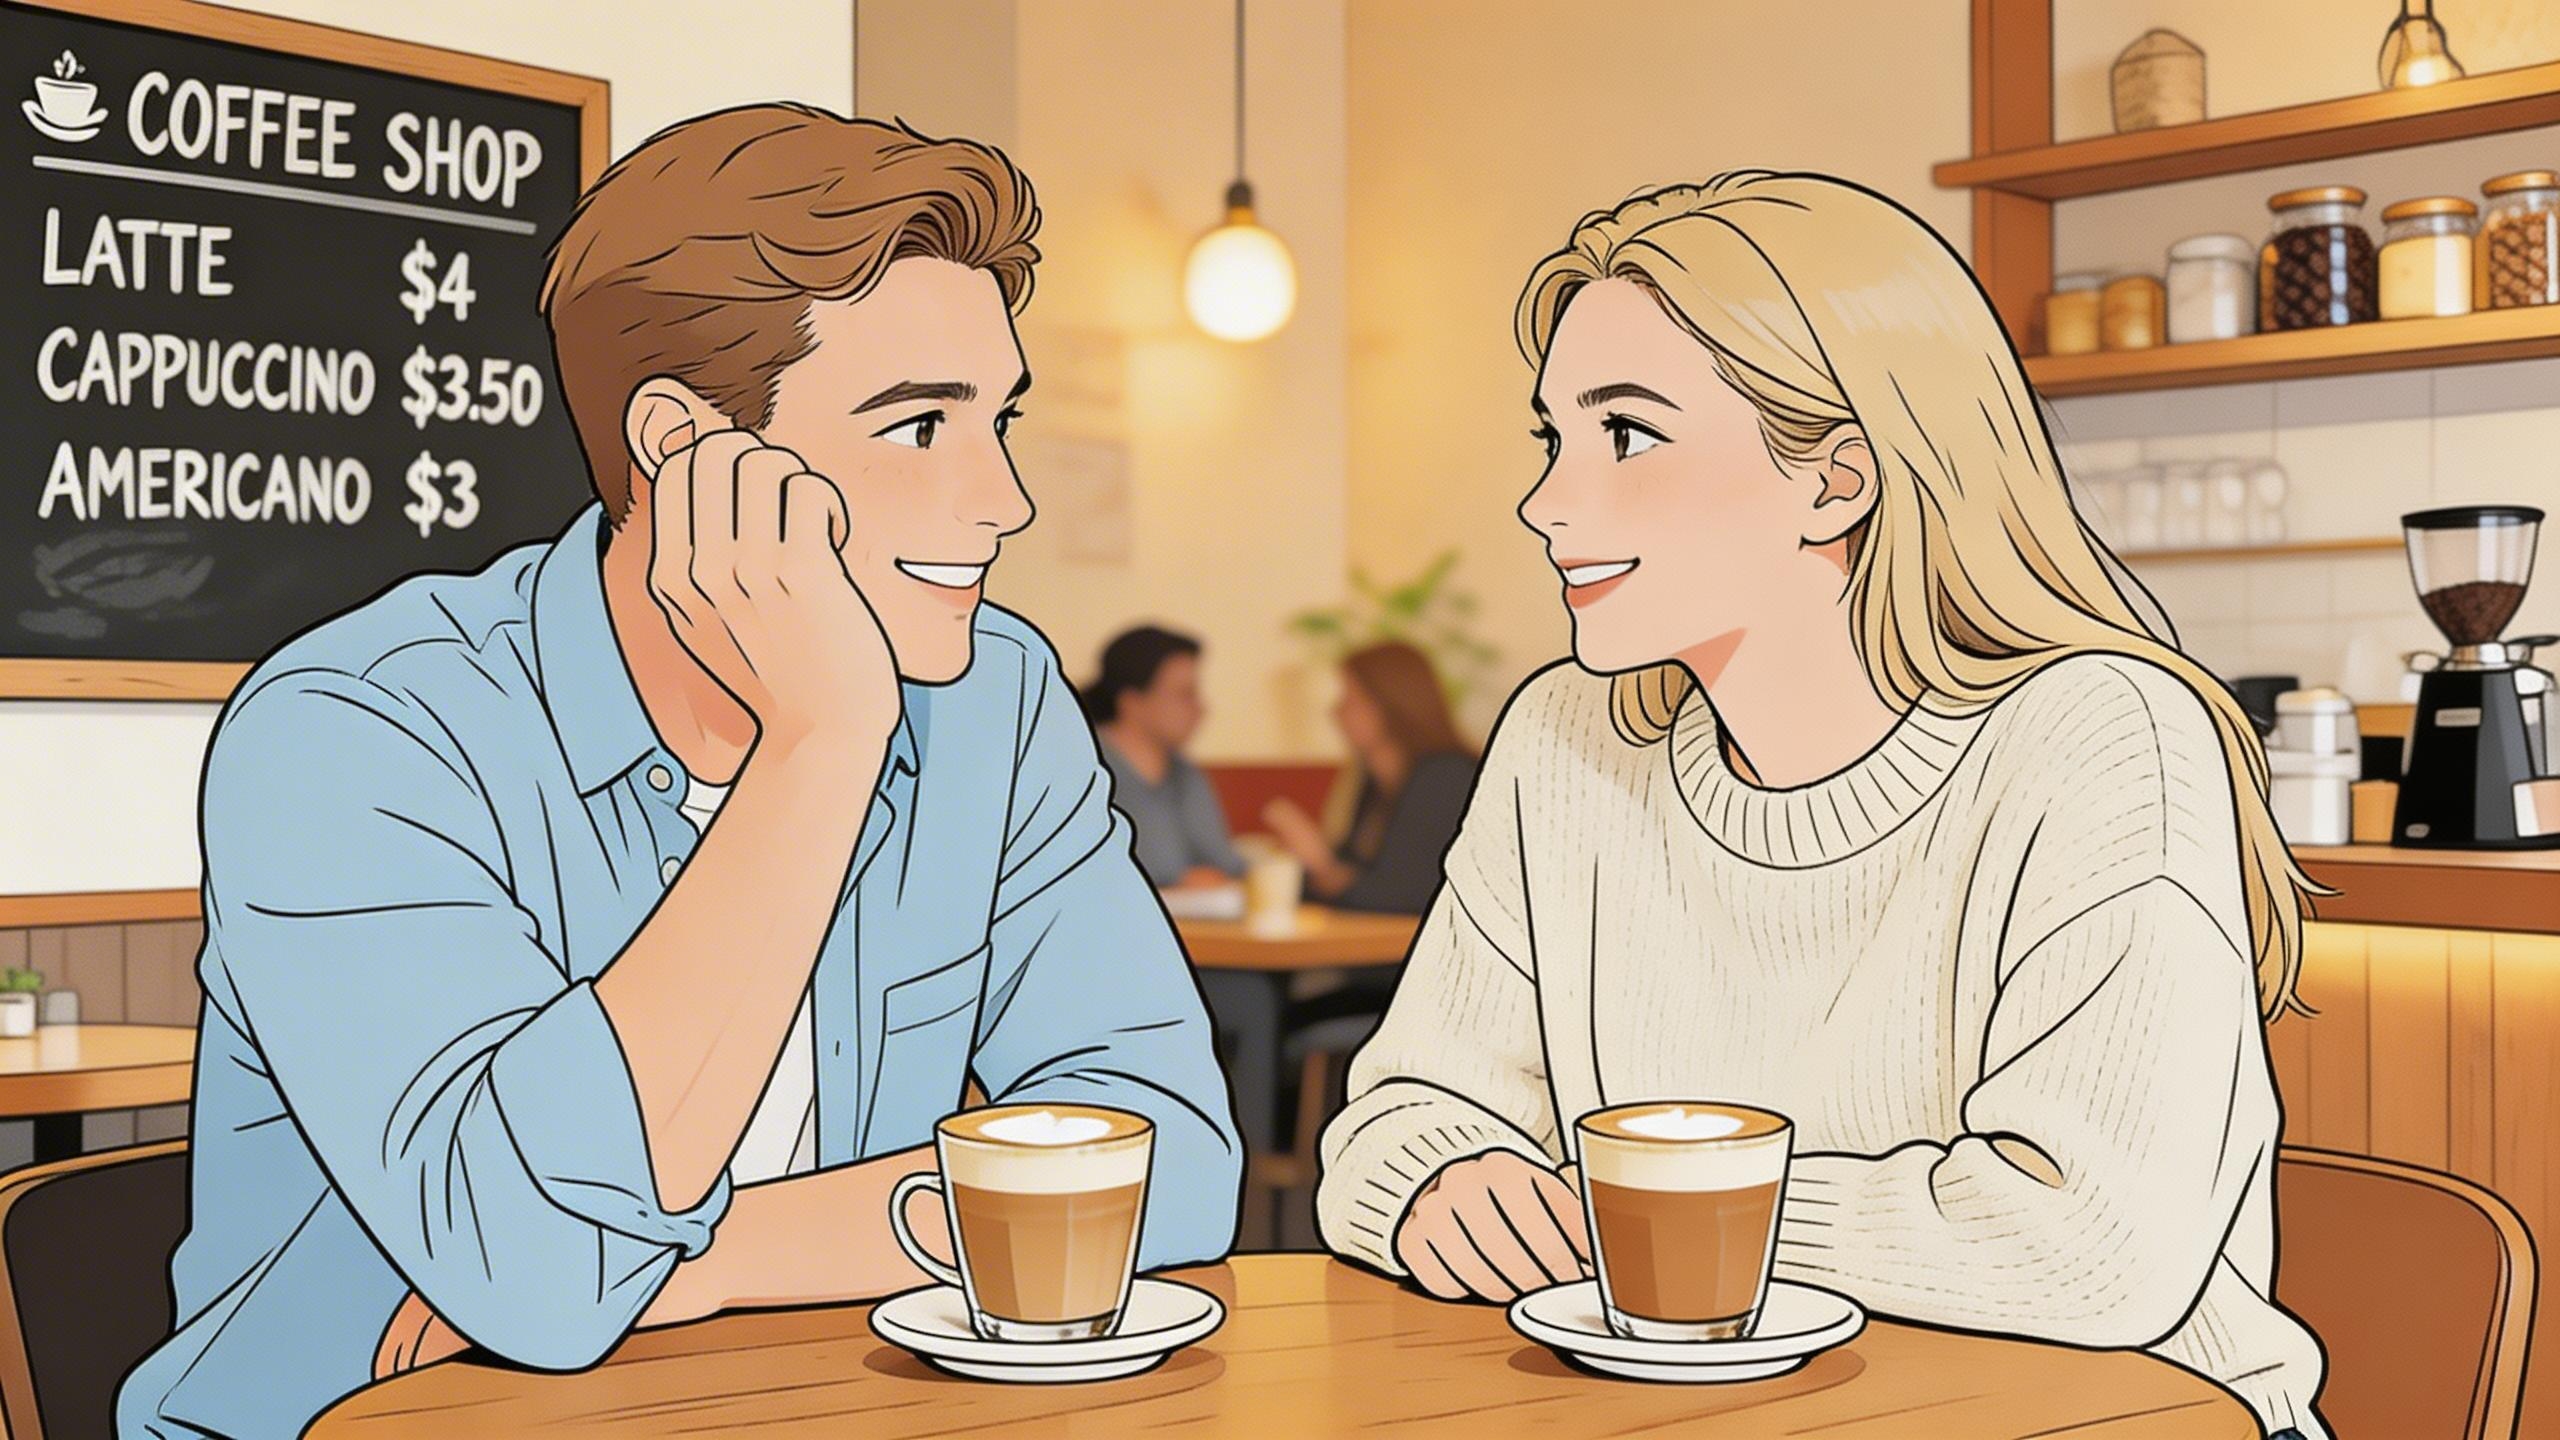
R2V: A shot of these two people in @Image1 chatting in a modern office. The woman speaks first with a playful tone: "You always arrive right on time, don't you just love that perfect timing?" followed by the man's smiling reply: "I have my own rhythm." Text integration: Render the dialogue as subtitles at the bottom-center of the screen. Subtitles should appear sequentially as each character speaks.
中文
R2V:@Image1 裡的兩個人在現代辦公室聊天。女生先開口,語氣俏皮:"You always arrive right on time, don't you just love that perfect timing?" 男生笑著回答:"I have my own rhythm." 文字:把對白做成字幕,放在畫面底部置中。字幕按每個人說話的順序依次出現。
對話氣泡
對話氣泡裡包含說出的那句臺詞,並出現在正在說話的角色旁邊。
參考素材
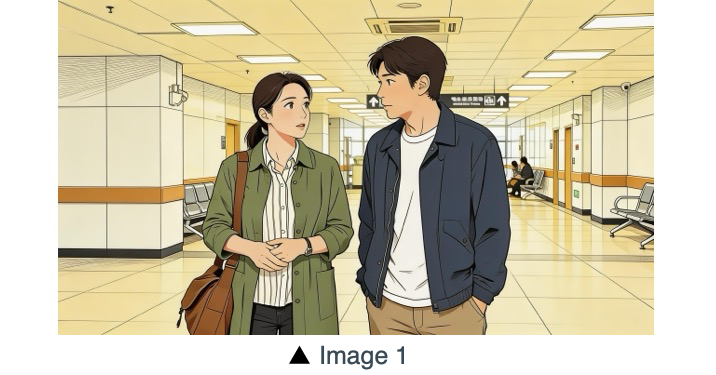
@Image1
提示詞
The two characters from @Image1, both dressed in sportswear, are running on the school playground. The girl looks at the boy, smiling confidently as she says: "We can definitely do it!". Cut to a close-up of the boy. He hesitates and replies: "Are you sure?". Cut back to a medium close-up of the girl. She speaks in a light, upbeat tone: "Yes!" Her demeanor is bright and resolute. Speech bubbles containing the corresponding lines appear around the speaking character.
中文
@Image1 裡的兩個人都穿著運動服,在學校操場上跑步。女孩看著男孩,自信地笑著說:"We can definitely do it!"。切到男孩的特寫。他猶豫了一下,回答:"Are you sure?"。再切回女孩的中近景。她用輕快的語氣說:"Yes!"。她的神情明亮、堅定。說話的人旁邊出現對話泡泡,裡面是對應的這句台詞。
參考素材
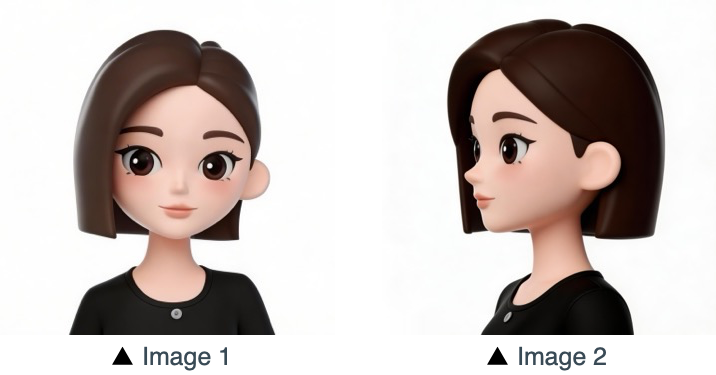
@Image1
提示詞
Refer to the character design of the girl in Image 1 and Image 2 on @Image1. The scene is set in an apple field: the girl picks one apple, takes a bite, smiles and says "This is the real deal!". A speech bubble pops up beside the girl, with this line written inside.
中文
參考 @Image1 上 Image 1 和 Image 2 裡女孩的角色設計。場景是蘋果園:女孩摘下一顆蘋果,咬了一口,笑著說 "This is the real deal!"。女孩身旁彈出一個對話泡泡,裡面寫著這句台詞。
多視角主體參考
一個主體,經由參考圖上的幾個角度被引用:消費電子、家居與生活方式,以及人物。
參考素材
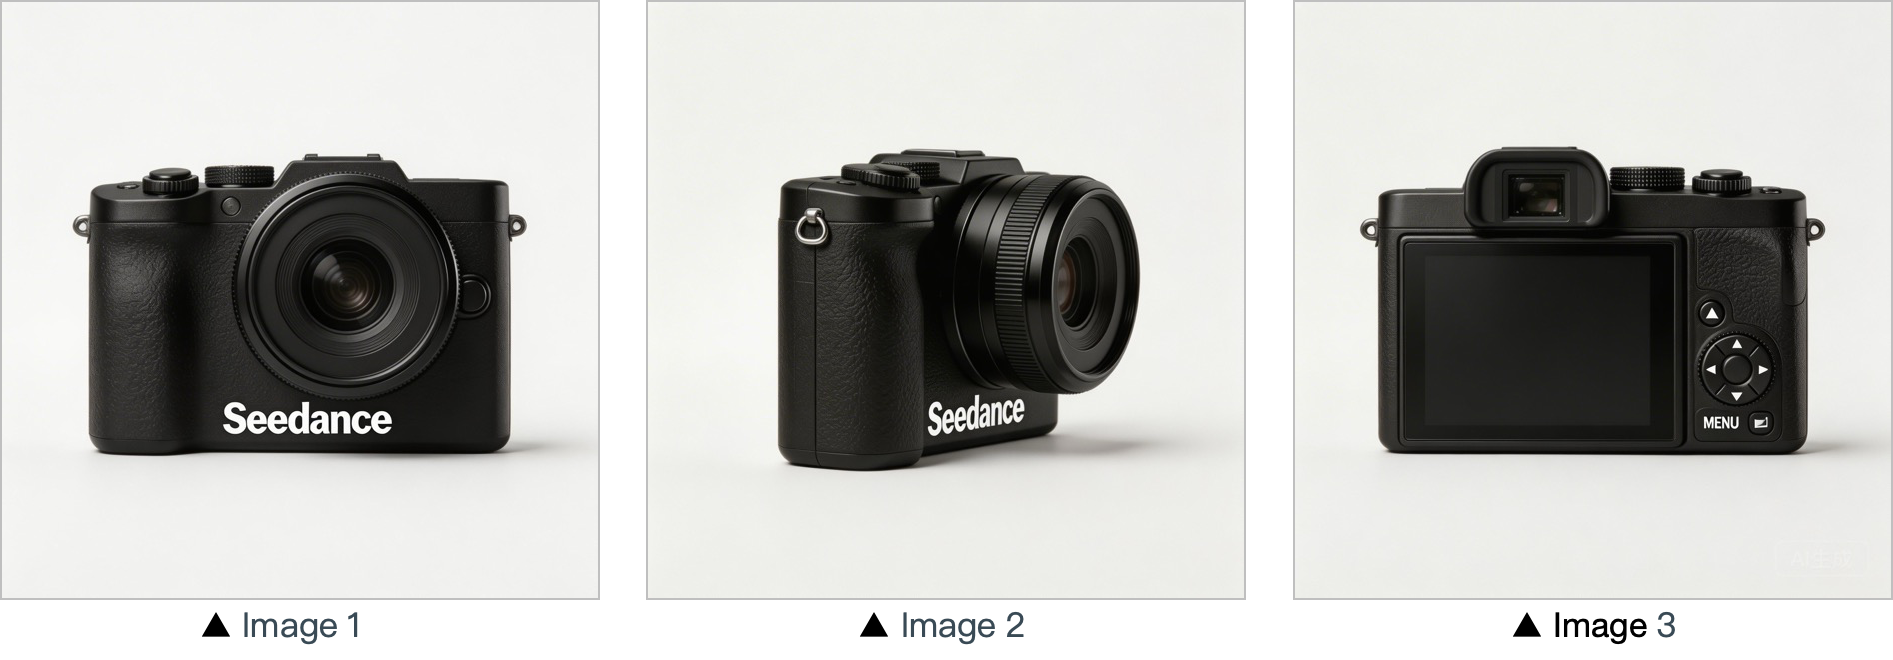
@Image1
提示詞
Use the cameras featured in Image 1, Image 2 and Image 3 on @Image1. Replace the original background with a white one, and place the cameras on a white table. The camera first focuses on the cameras in close-up, then slowly rotates 360° with the cameras as the main subject, clearly displaying the front, sides and back of each camera.
中文
使用 @Image1 上 Image 1、Image 2 和 Image 3 裡的相機。把原來的背景換成白色,把相機放在白色桌子上。鏡頭先特寫這些相機,再以相機為主體緩慢旋轉 360°,把每臺相機的正面、側面和背面都看清楚。
參考素材
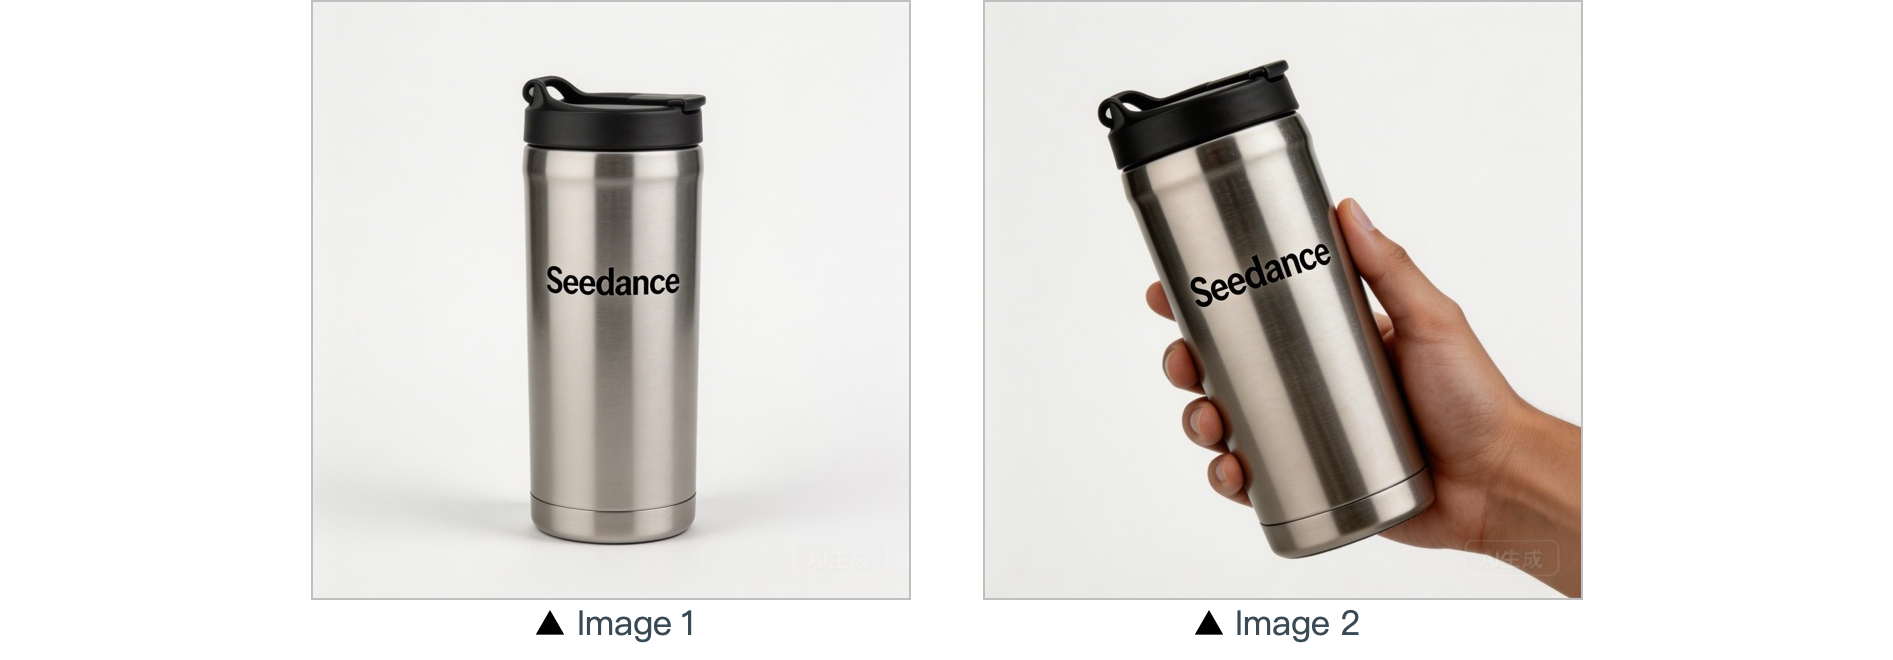
@Image1
提示詞
In a warm-toned home setting, present the thermos shown in @Image1 in a medium shot. Then smoothly push the camera into a close-up of the thermos. Next, a hand naturally enters the frame off-screen, gently grips the thermos body and picks it up. The camera follows the slight rotating motion of the hand to showcase the thermos.
中文
在暖色調的居家環境裡,用中景展示 @Image1 裡的保溫杯。然後鏡頭平穩推進,變成保溫杯的特寫。接著,一隻手從畫面外自然入畫,輕輕握住杯身並拿起來。鏡頭跟著這隻手輕微轉動的動作,把保溫杯展示出來。
參考素材
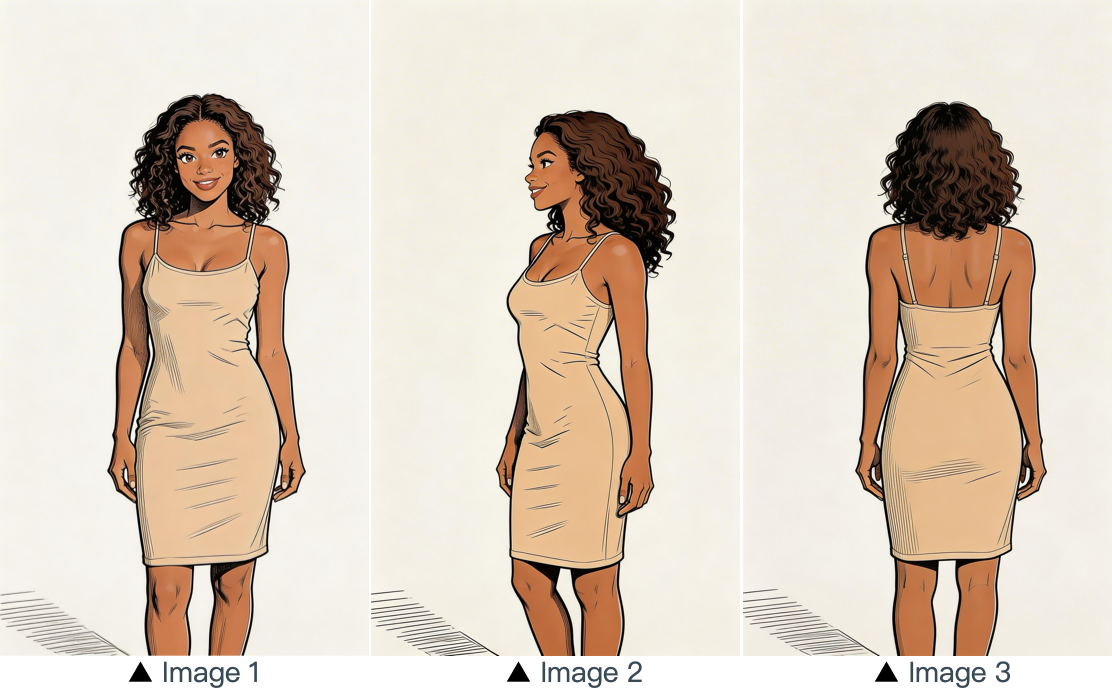
@Image1
提示詞
Refer to the image of the woman in Image 1, Image 2 and Image 3 on @Image1, and generate a scene of her eating a cake in a coffee shop.
中文
參考 @Image1 上 Image 1、Image 2 和 Image 3 裡的女性形象,生成她在咖啡店吃蛋糕的場景。
多圖參考
參考圖上的每一張圖片各有一件事:標誌、多個主體、一組角色和一個地點、一組多格序列,或一串連續畫面。
參考素材
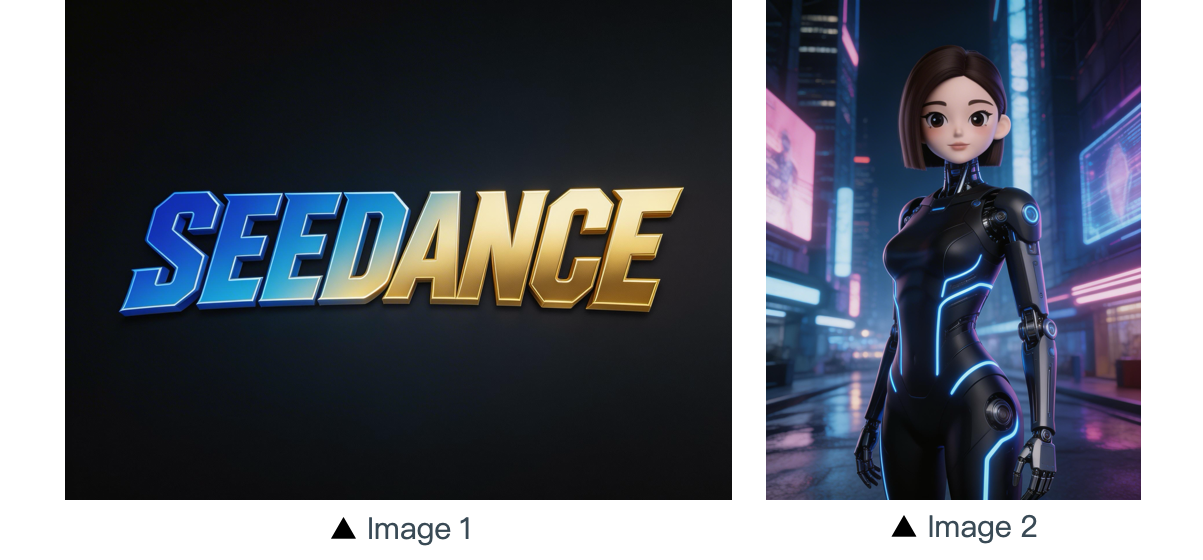
@Image1
提示詞
The scene is set on an aerial corridor in a neon-drenched futuristic metropolis, where flying vehicles and holographic ads intertwine. Featuring the girl from Image 2 on @Image1, the sequence opens with a medium shot of her releasing a silver floating lantern embedded with a holographic projection. The camera then pulls back to reveal floating lanterns flooding the sky, which gradually converge at the center of the frame to form the logo from Image 1 on @Image1. The entire piece adopts a 3D cyberpunk sci-fi animation style.
中文
場景在霓虹未來都市的空中走廊,飛行器和全息廣告交織。主角是 @Image1 上 Image 2 裡的女孩。開場是中景:她放飛一盞嵌著全息投影的銀色漂浮燈籠。鏡頭隨後拉遠,天空布滿漂浮燈籠,它們逐漸在畫面中央匯聚,組成 @Image1 上 Image 1 裡的標誌。整支片子是 3D 賽博龐克科幻動畫風格。
參考素材
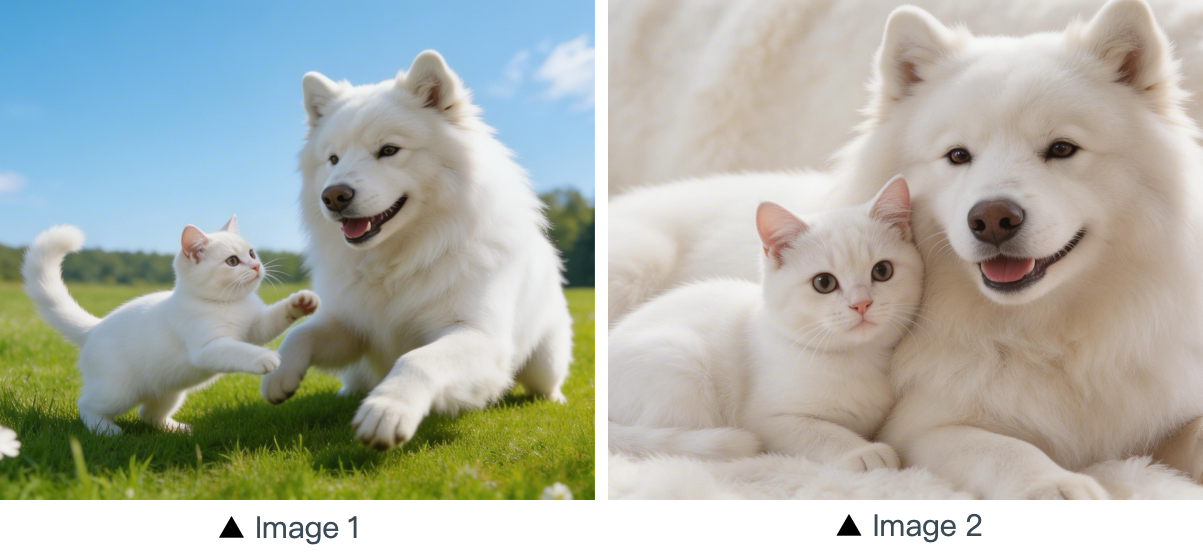
@Image1
提示詞
Using the cat and dog from Image 1 and Image 2 on @Image1 as prototypes, the scene unfolds in a cozy apartment. The dog is lying on the ground eating dog food when the cat approaches, extending a paw to nudge the dog. The dog pauses its meal upon noticing the cat, and the cat snuggles up next to the dog. The entire scene features a warm colored tone.
中文
以 @Image1 上 Image 1 和 Image 2 裡的貓和狗為原型,場景在一間舒適的公寓。狗趴在地上吃狗糧,貓走過來,伸出爪子碰了碰狗。狗注意到貓,停下來不吃了,貓依偎到狗身邊。整段色調溫暖。
參考素材
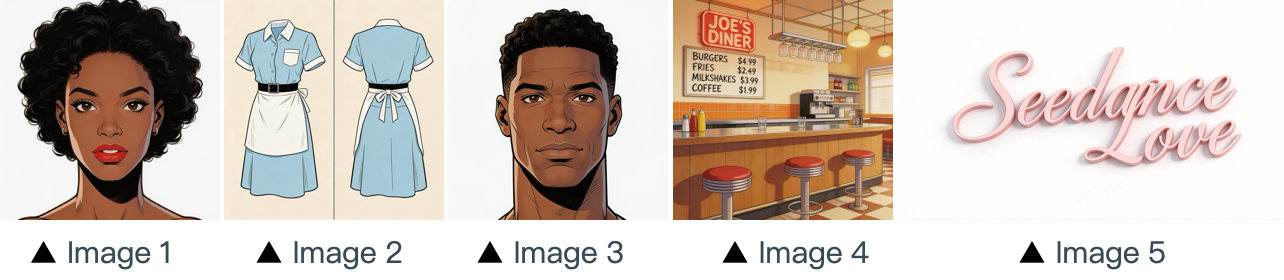
@Image1
提示詞
The scene is set in the restaurant from image 4 on @Image1, with people coming and going. The girl from image 1, wearing the clothes from image 2, is organizing the items on the counter. The boy, a customer, from image 3 approaches her to ask for her contact information. The logo from image 5 remains in the bottom right corner throughout.
中文
場景是 @Image1 上 image 4 裡的餐廳,人來人往。image 1 裡的女孩穿著 image 2 裡的衣服,在整理櫃檯上的東西。image 3 裡的男孩是顧客,走上前向她要聯絡方式。image 5 裡的標誌一直留在右下角。
參考素材
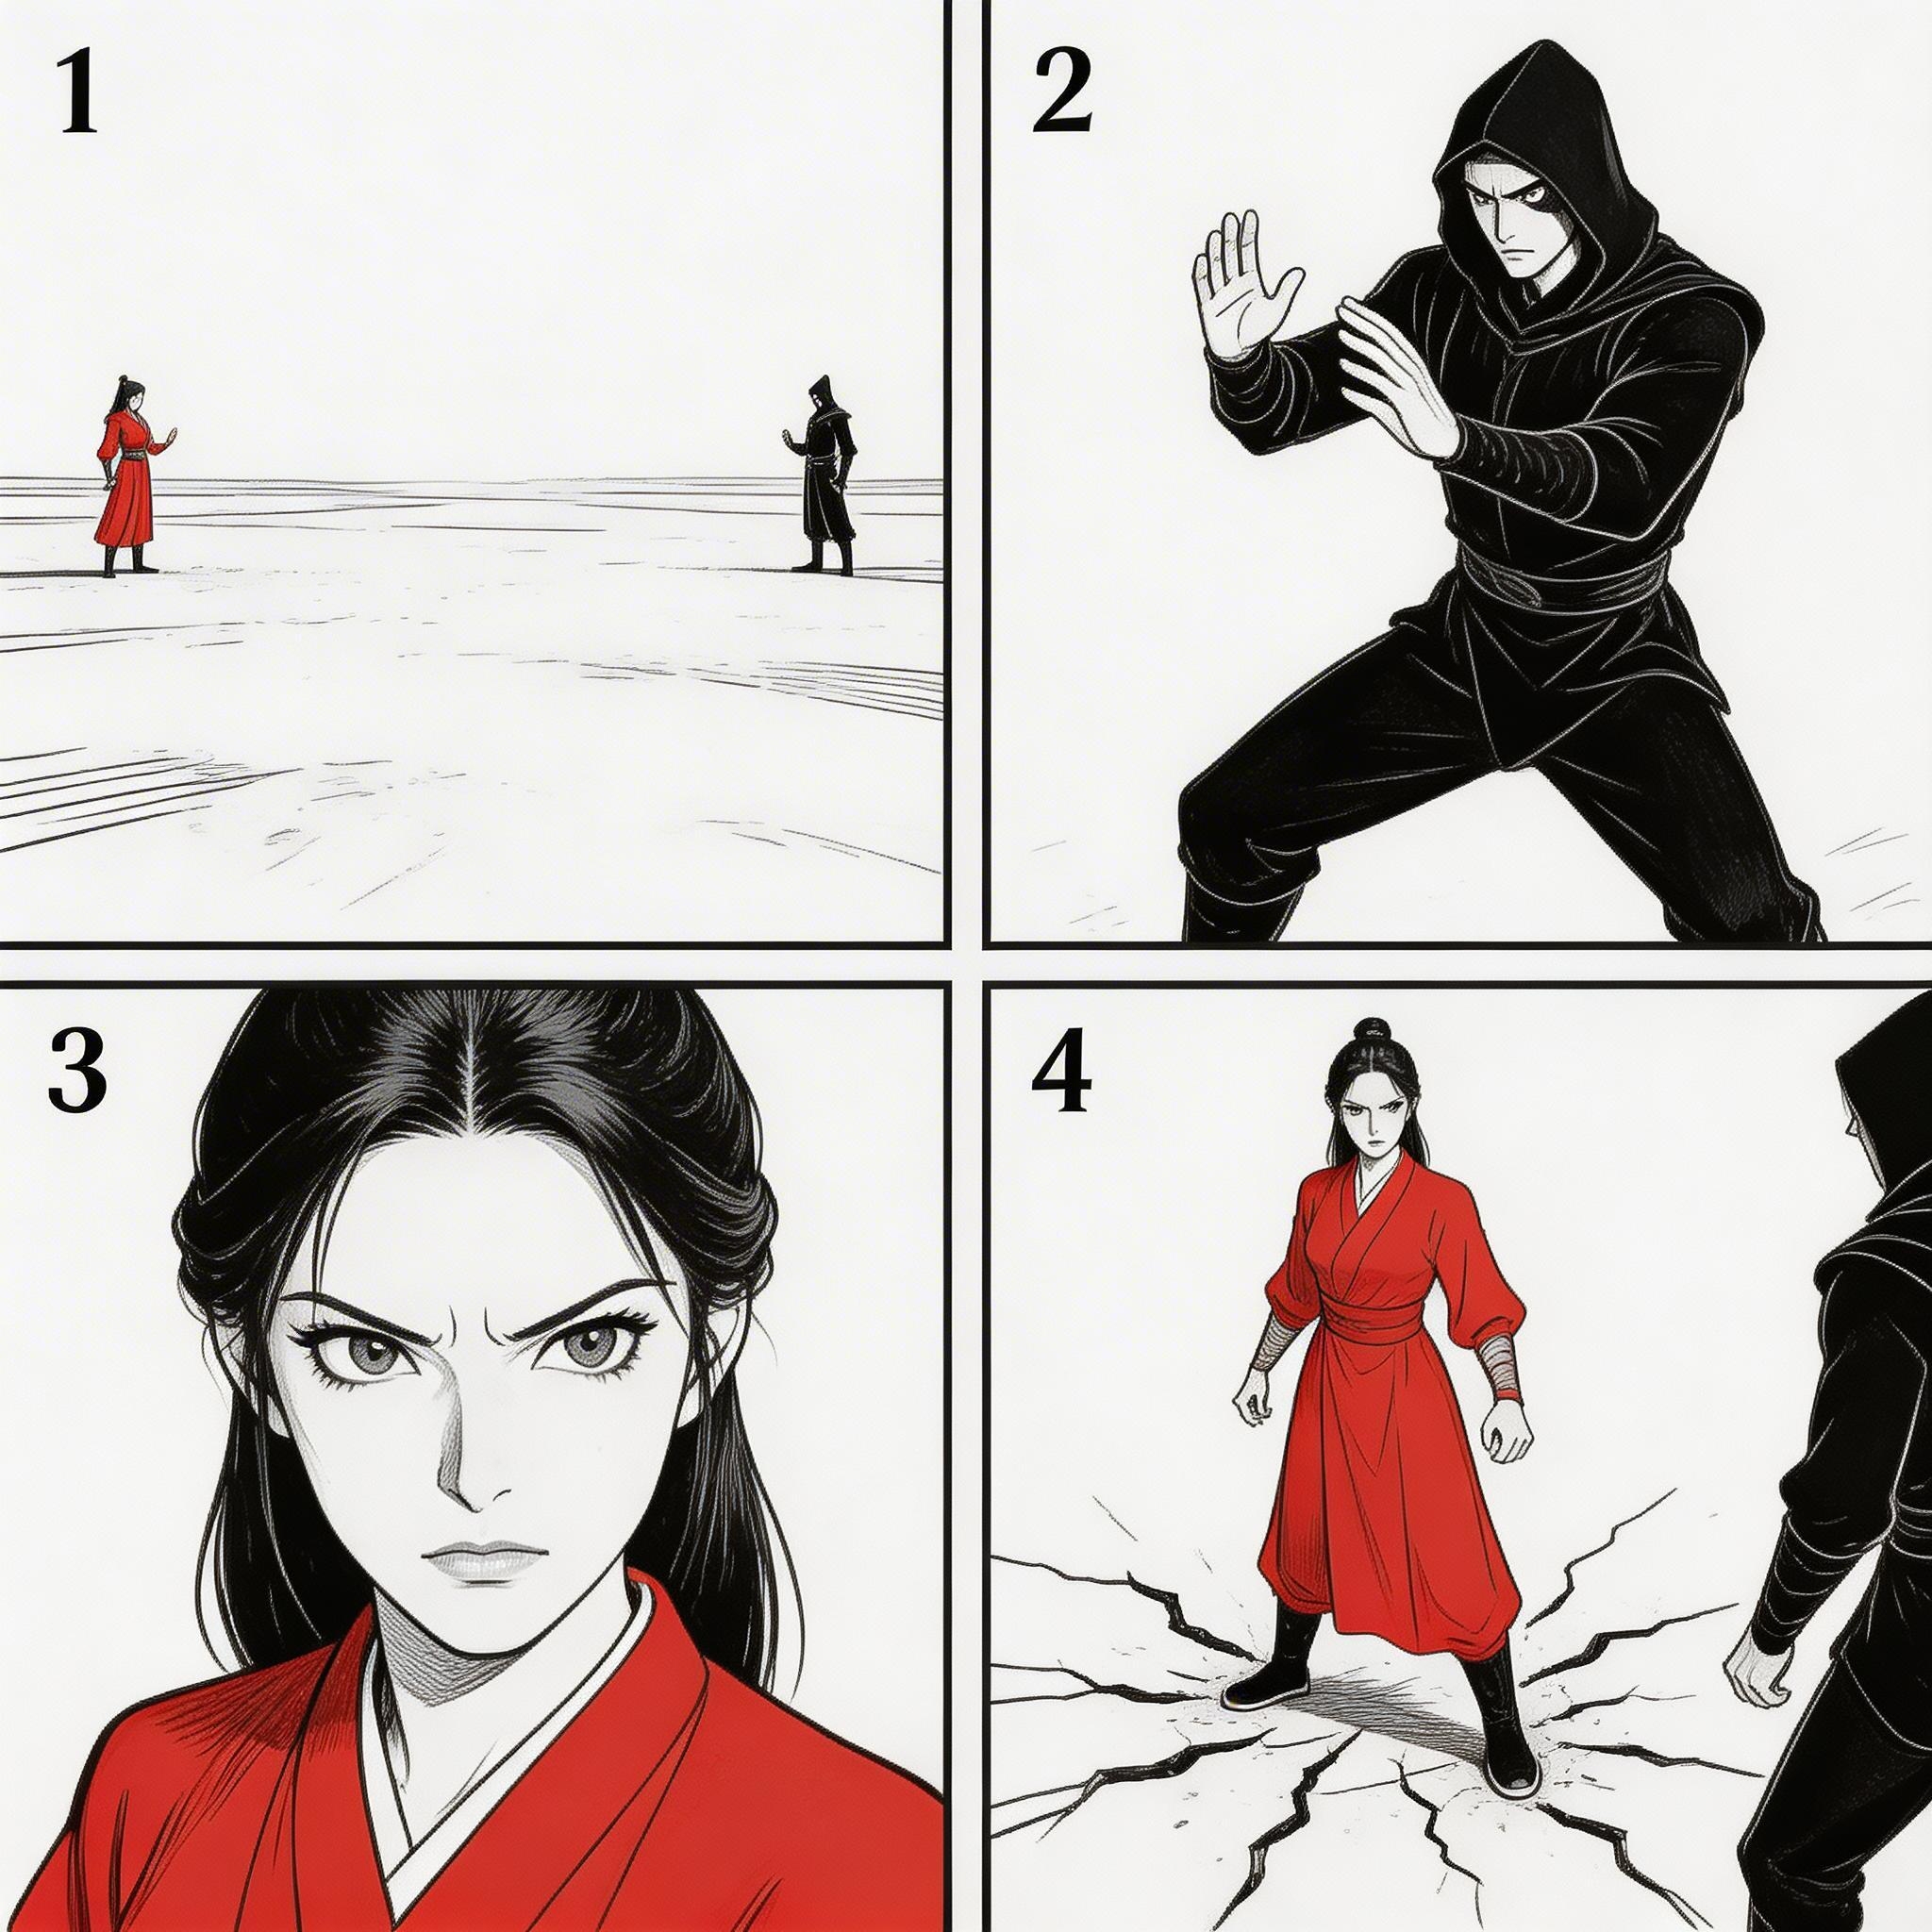
@Image1
提示詞
Refer to the sequence in @Image1 to create an intense high-energy fight sequence. All frame compositions from @Image1 shall be presented in strict predefined order, after which the two characters engage in fierce, fast-paced combat.
中文
參考 @Image1 裡的順序,做一段激烈、高能量的打鬥。@Image1 裡的每個畫面構圖都按預先定好的順序嚴格出現,然後這兩個角色展開激烈、快節奏的對打。
參考素材
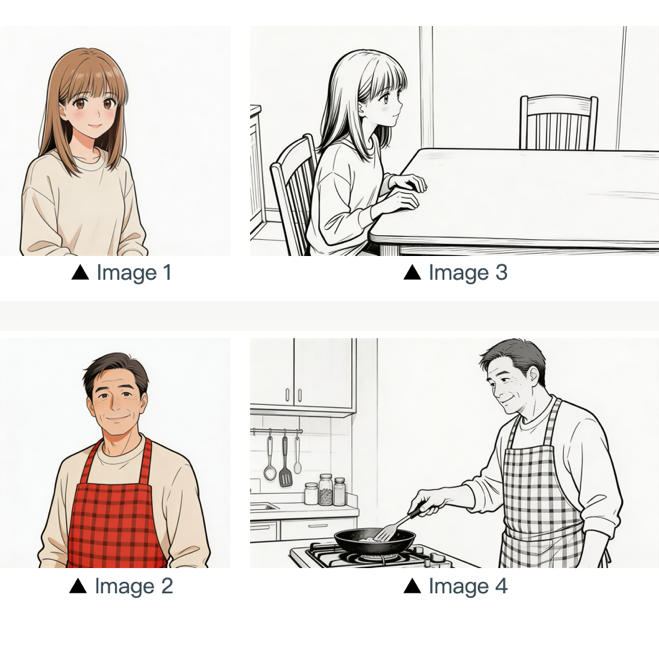
@Image1
提示詞
Refer to the composition in Image 3 on @Image1. A girl (her character design refers to Image 1) is waiting for her father to finish cooking, and she says: "아빠, 배고파요! 밥 다 됐어요?" Then the camera pans right and cuts to the frame and composition shown in Image 4. The father (his character design refers to Image 2) replies to her: "거의 다 됐어, 조금만 기다려!" Next, the camera cuts back to a close-up shot of the daughter's slightly disappointed facial expression, and she says: "아직 멀었어요? 맛있는 냄새 나는데..." Then the shot switches to a close-up of the father's face, and he says: "이제 진짜 금방이야. '빨리빨리' 하지 말고 손부터 씻고 와!"
中文
參考 @Image1 上 Image 3 的構圖。女孩(角色設計參考 Image 1)等爸爸做完飯,她說:"아빠, 배고파요! 밥 다 됐어요?" 然後鏡頭向右搖,切到 Image 4 的畫面和構圖。爸爸(角色設計參考 Image 2)回答她:"거의 다 됐어, 조금만 기다려!" 接著鏡頭切回女兒略帶失望的面部特寫,她說:"아직 멀었어요? 맛있는 냄새 나는데..." 然後切到爸爸的面部特寫,他說:"이제 진짜 금방이야. '빨리빨리' 하지 말고 손부터 씻고 와!"
動作參考
參考影片中的角色動作和鏡頭語言,再把它們用到圖片中的角色上。營銷示例參考的是影片中那匹馬的奔跑形態。
參考素材
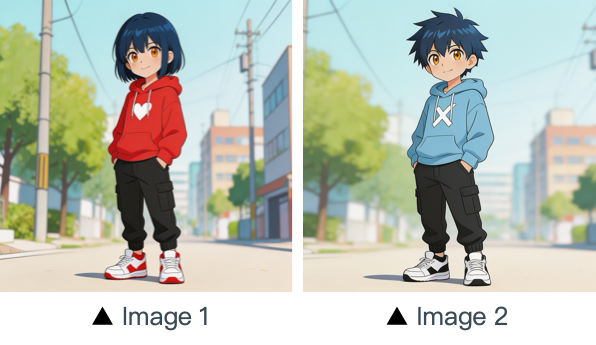
@Image1
@Video1
提示詞
Refer to the character movements and shot language in @Video1 to create a fight scene with the character from Image 2 on @Image1 on the left and the character from Image 1 on @Image1 on the right. Include intense background music.
中文
參考 @Video1 裡的角色動作和鏡頭語言,做一段打鬥:@Image1 上 Image 2 的角色在左邊,@Image1 上 Image 1 的角色在右邊。加上強烈的背景音樂。
參考素材
@Video1
提示詞
Referencing the running shape of the horse in @Video1, generate a scene: a golden steed runs on the grassland, then freezes its magnificent running posture and turns into a horse-shaped gold pendant.
中文
參考 @Video1 裡馬奔跑的姿態,生成一段畫面:一匹金馬在草原上奔跑,然後定格在奔馳的姿態,變成馬形的金吊墜。
運鏡參考
參考影片中的運鏡,並點名圖片中的新主體。
參考素材
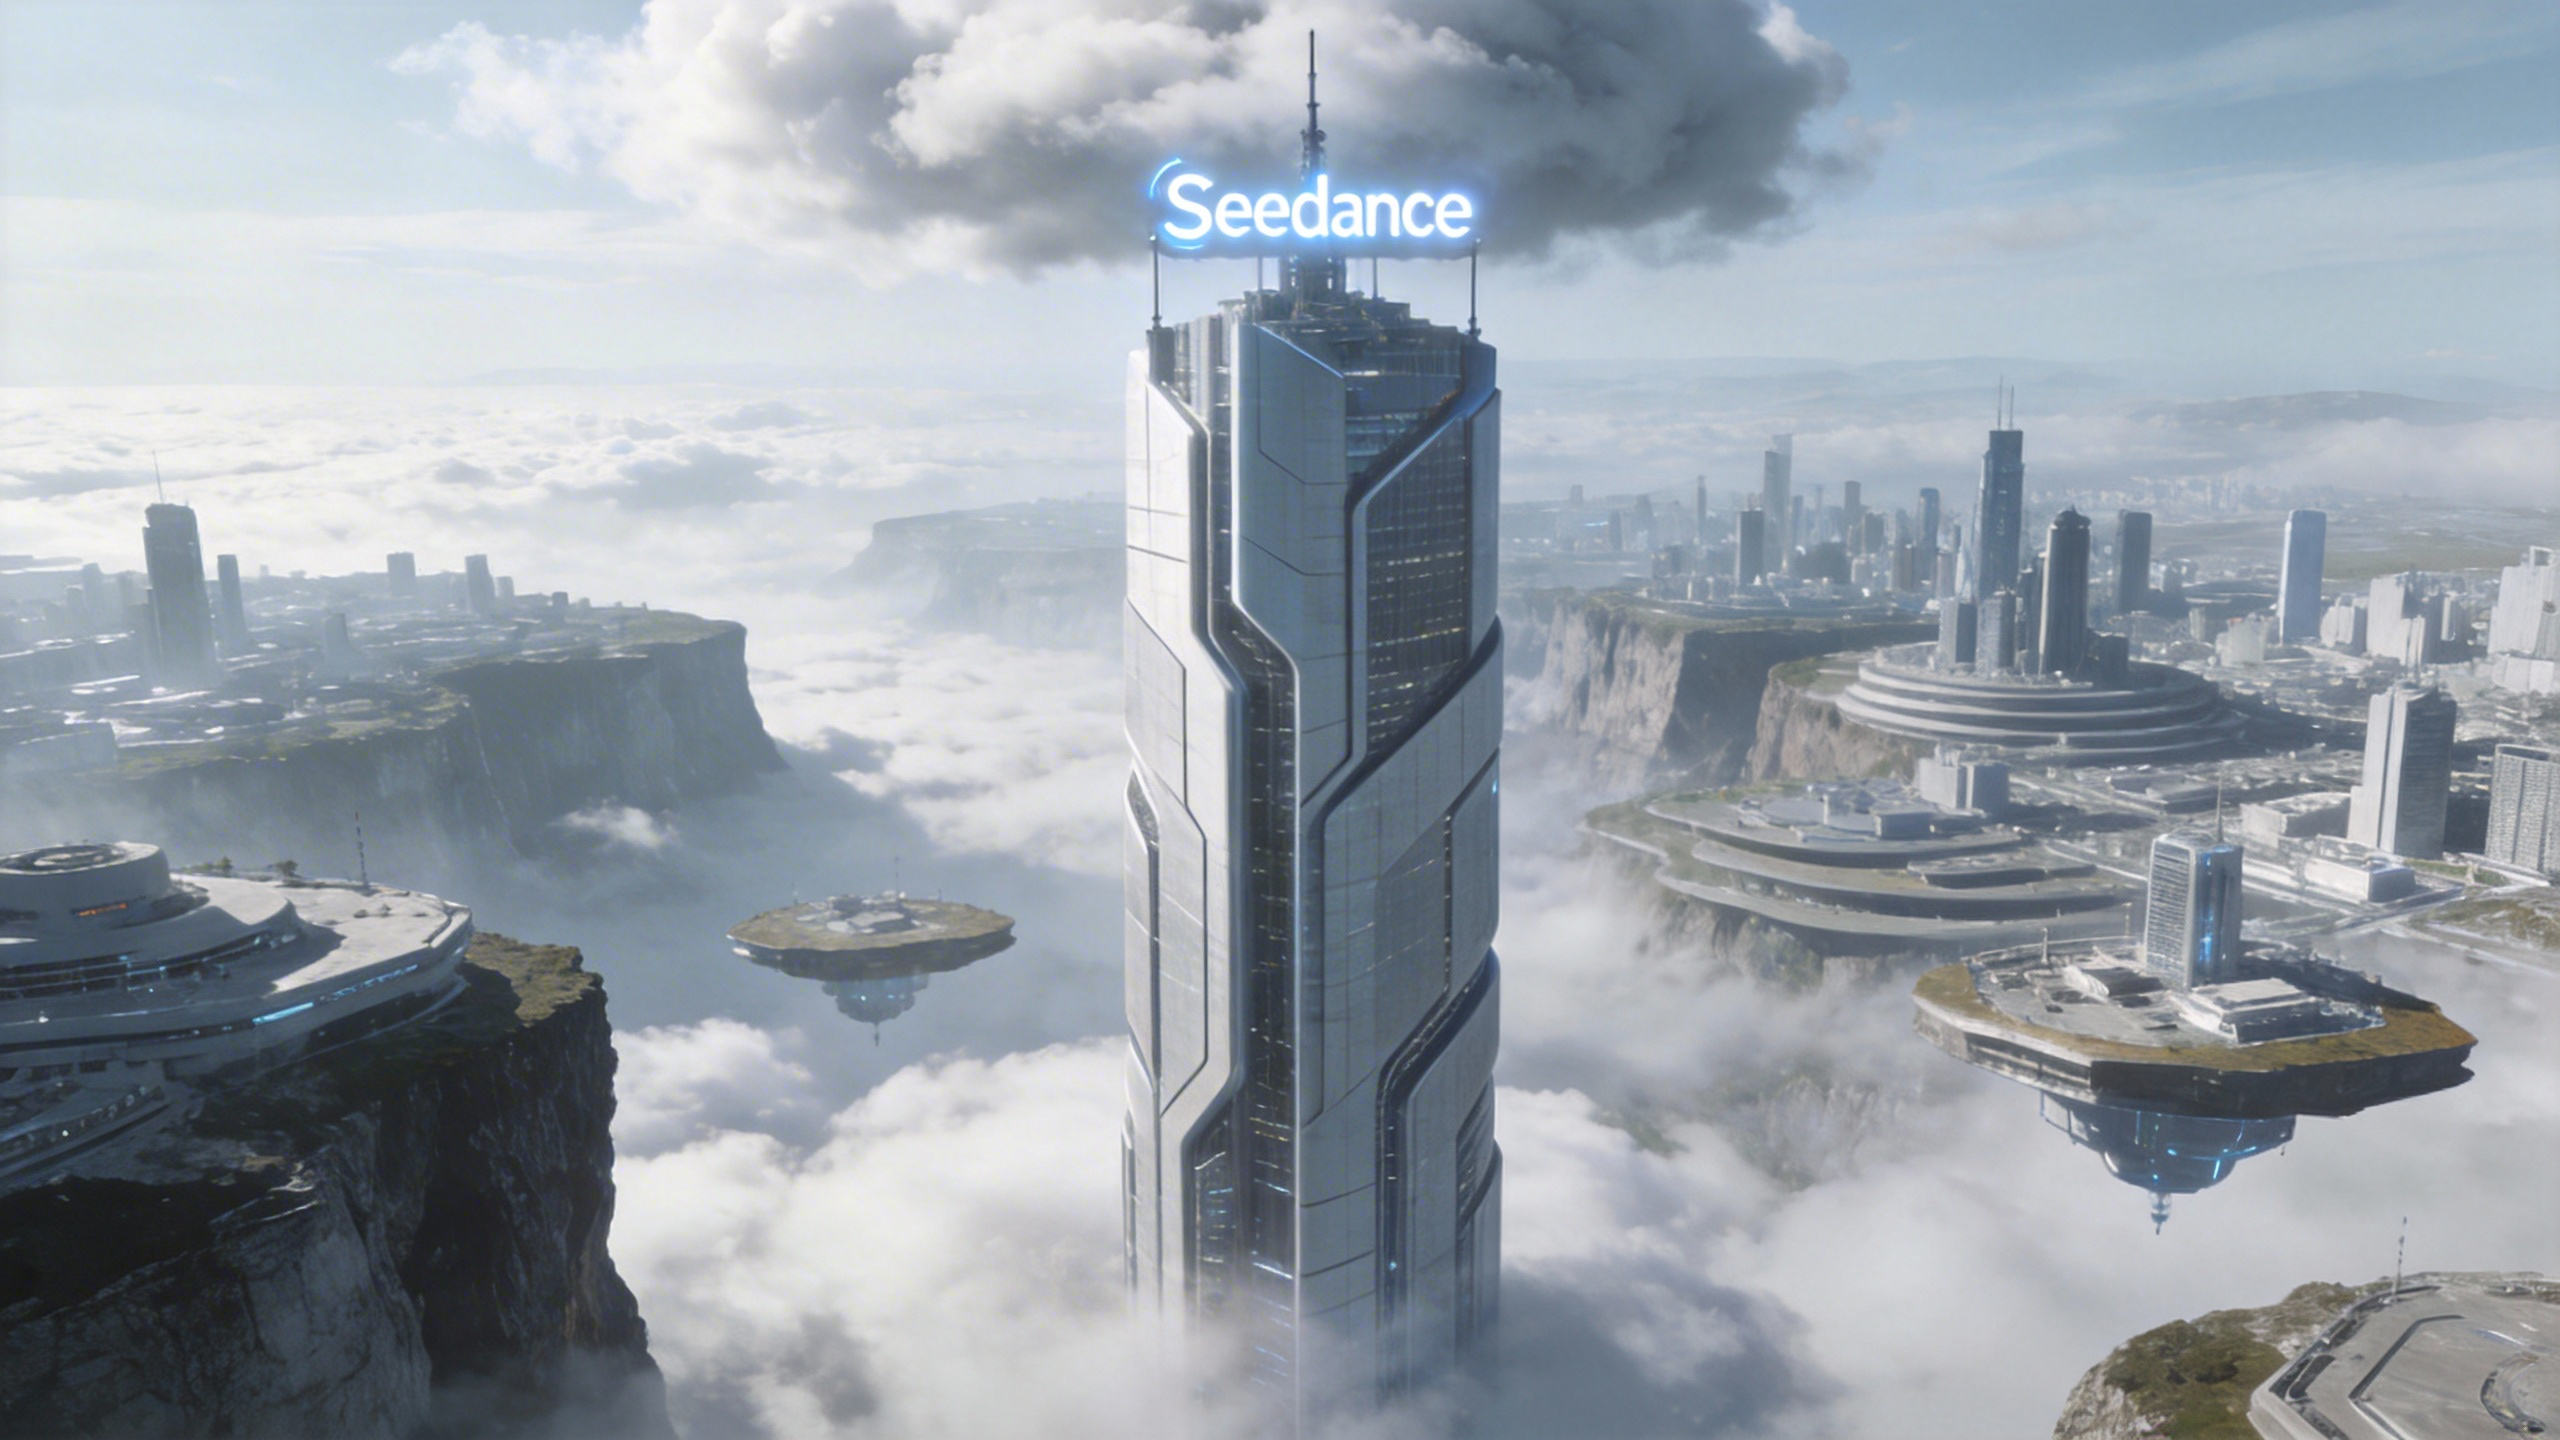
@Image1
@Video1
提示詞
Referring to the camera movement in @Video1, create a concept video for a science and technology park, with the tall building in @Image1 as the visual center, also using a first-person diving perspective, to reflect the sense of technology in the park from @Image1.
中文
參考 @Video1 的運鏡,做一支科技園區概念影片。以 @Image1 裡的高樓為視覺中心,同樣用第一人稱俯衝視角,體現 @Image1 裡園區的科技感。
特效參考
參考影片中的特效,並把同樣的效果、路徑和順序用到圖片中的角色上。
參考素材
@Image1
@Video1
提示詞
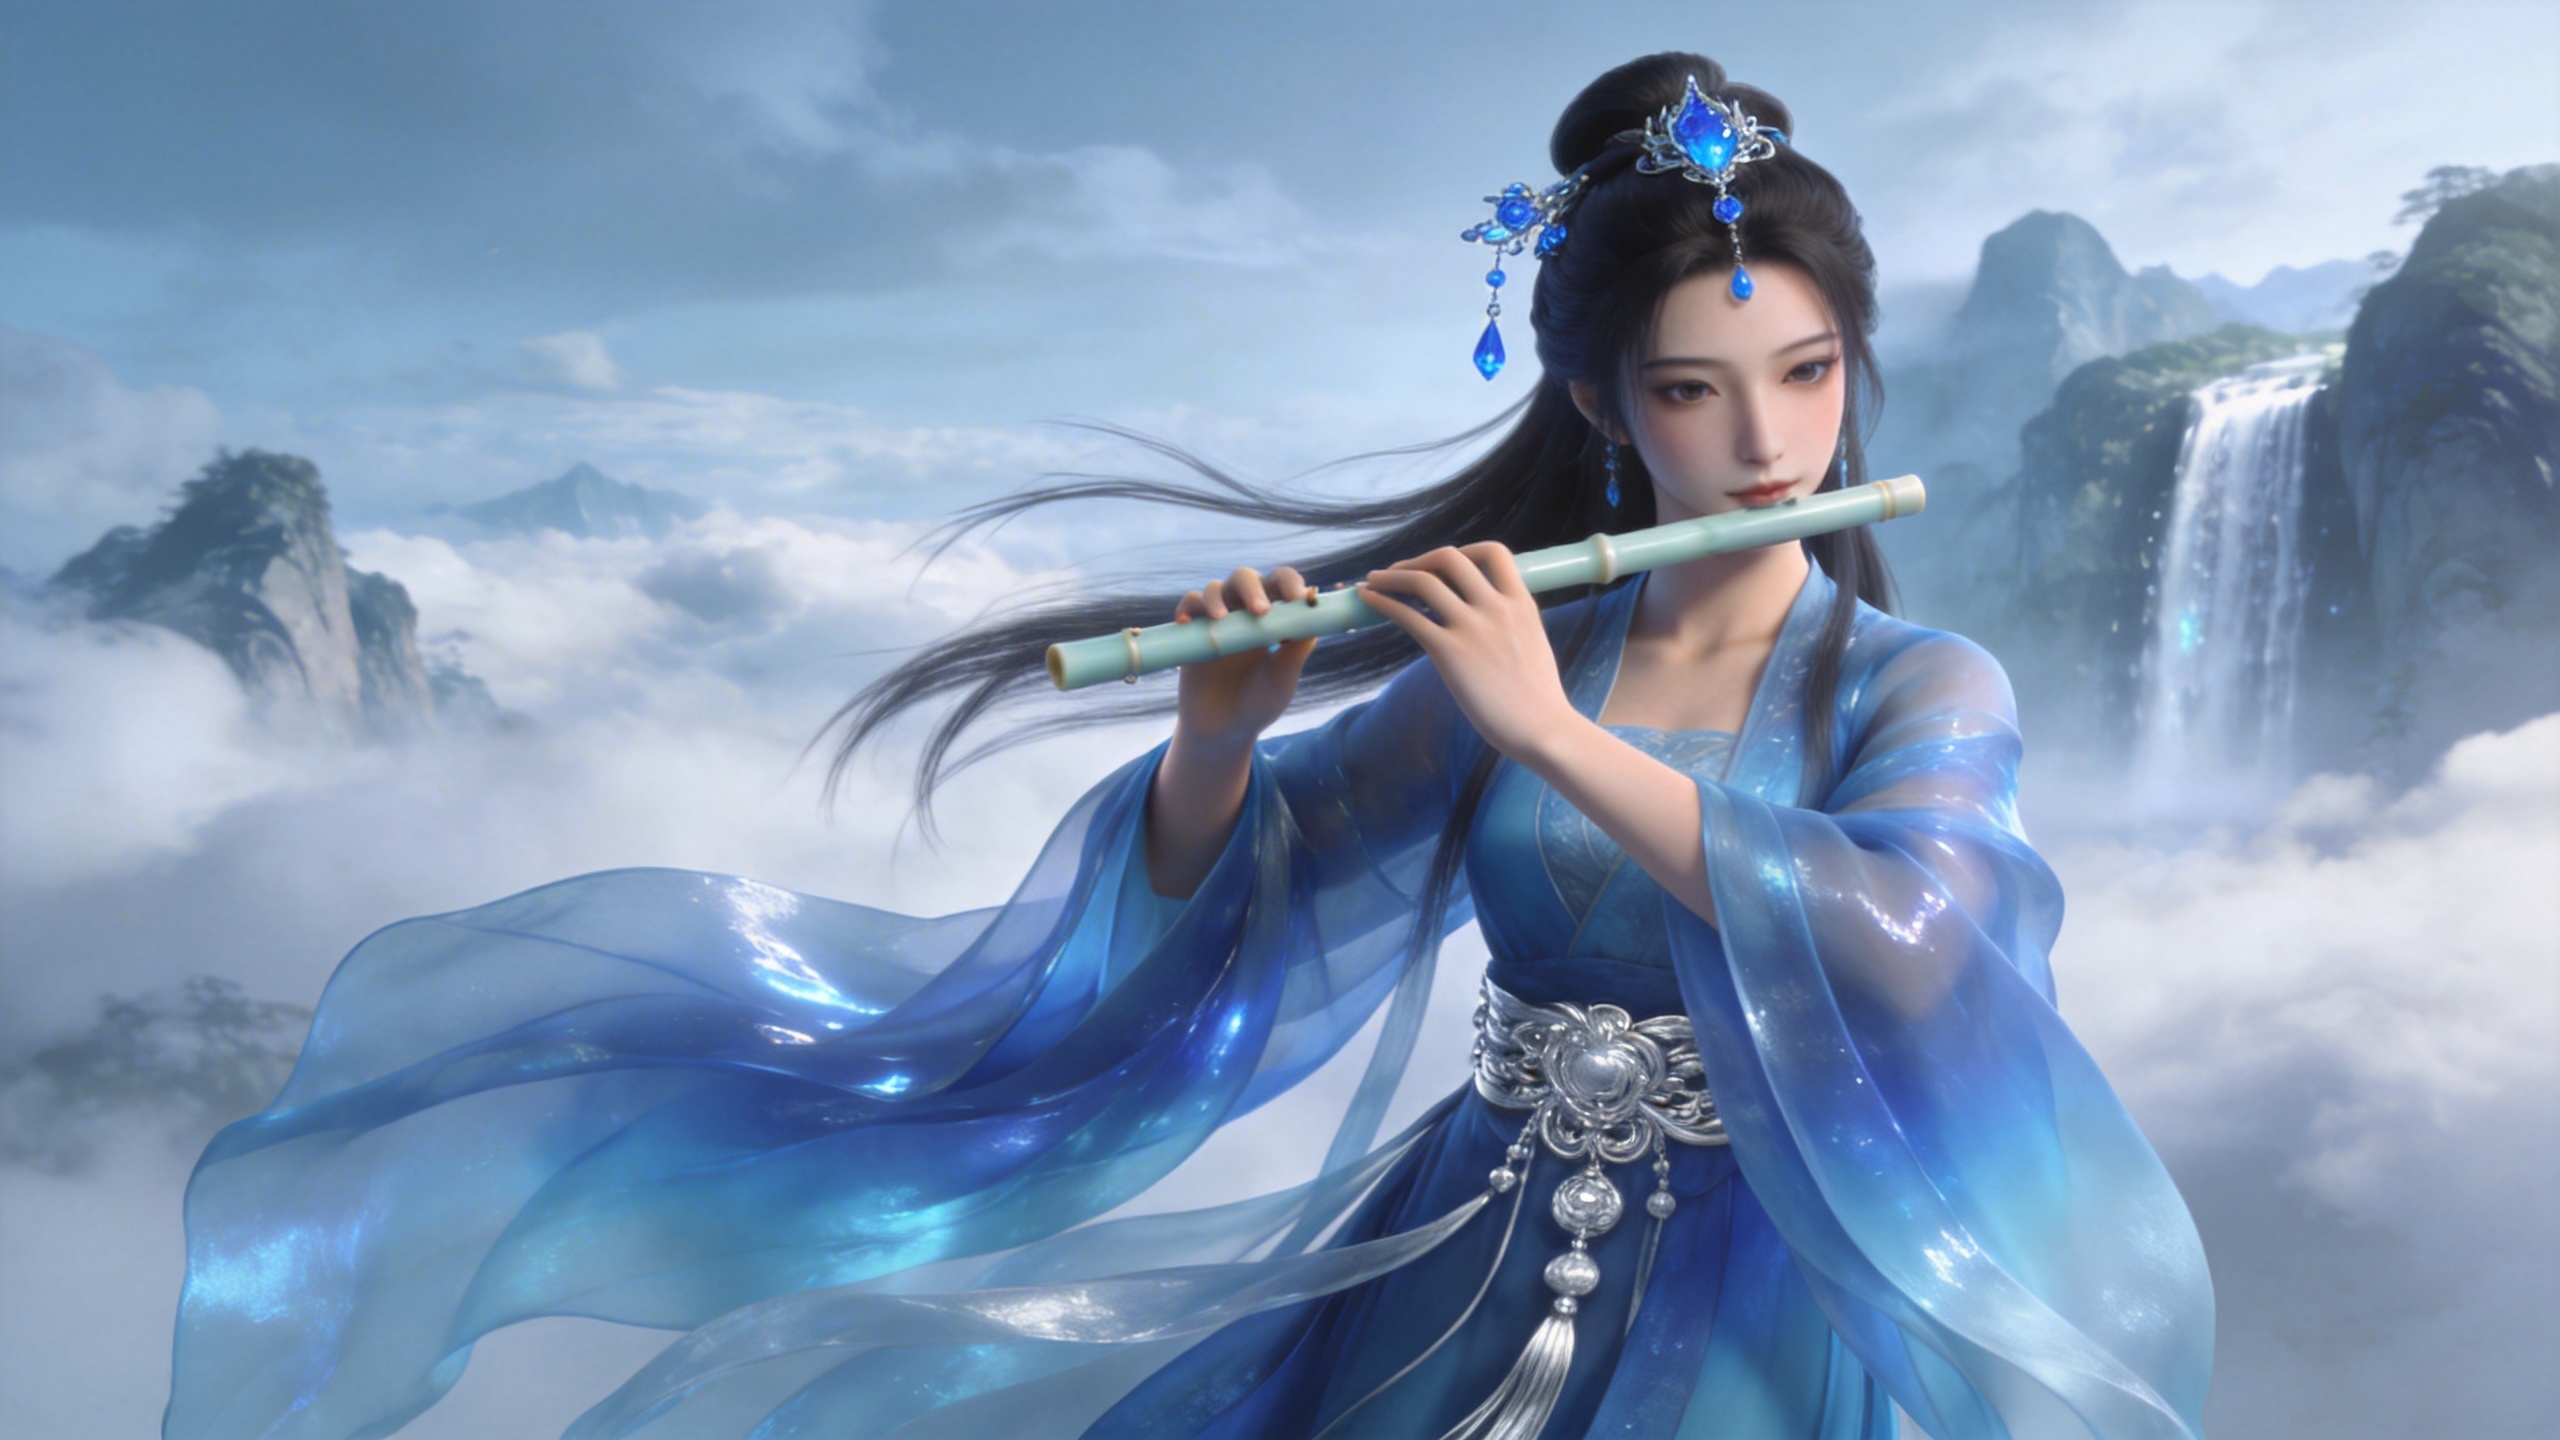
Refer to the golden particle effects in @Video1, so that when the character in @Image1 plays the flute, the same particle effects surround their body.
中文
參考 @Video1 裡的金色粒子效果,讓 @Image1 裡的角色吹笛子時,同樣的粒子效果環繞在身體周圍。
參考素材
@Image1
@Video1
提示詞
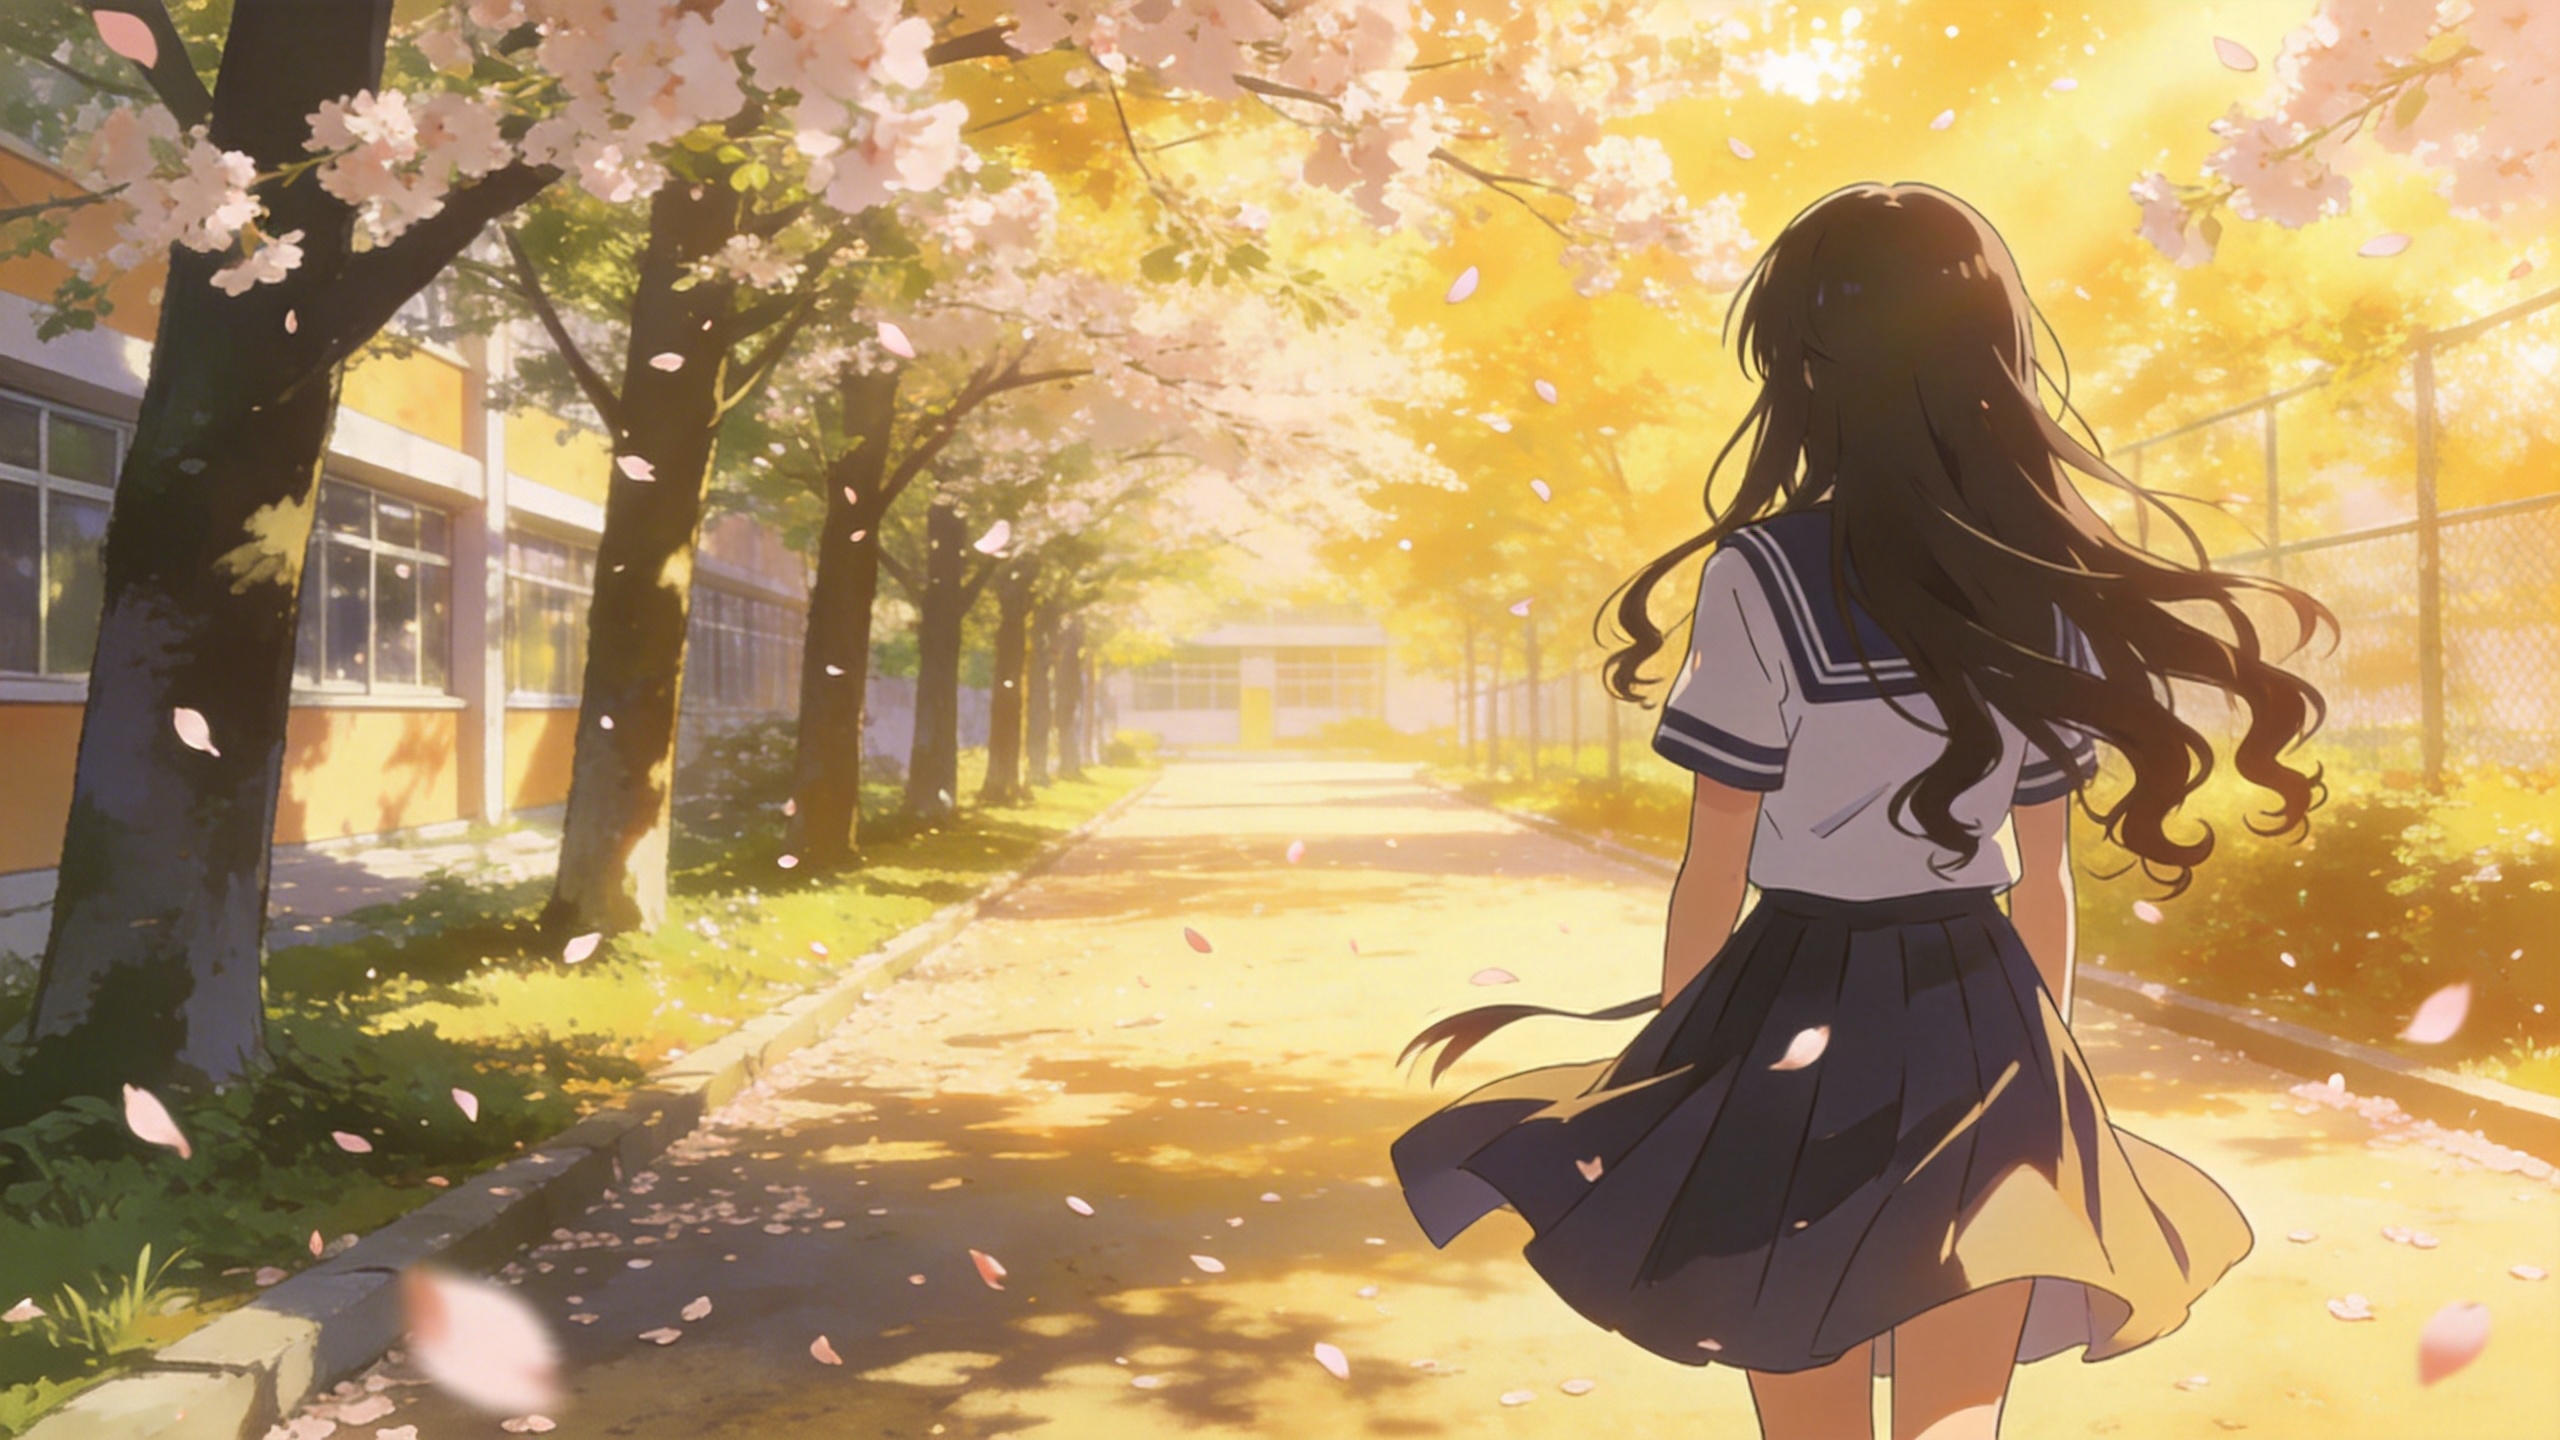
Refer to the special effects shown in @Video1 to generate identical wings for the girl in @Image1, ensuring the wing formation trajectory follows the exact same motion path and sequence depicted in the video.
中文
參考 @Video1 裡的特效,給 @Image1 裡的女孩生成同樣的翅膀,翅膀形成的軌跡要和影片裡的運動路徑、先後順序完全一致。
新增、去除或修改元素
新增、去除或替換。對於編輯,不要寫 "reference"。沒有提到的部分保持不變。
參考素材
@Video1
提示詞
Add snacks such as fried chicken and pizza to the countertop in @Video1.
中文
在 @Video1 的檯面上加上炸雞、披薩這類零食。
參考素材
@Video1
提示詞
Remove everything that isn't office supplies from the table in @Video1, keeping the rest of the video content unchanged.
中文
把 @Video1 桌子上不屬於辦公用品的東西都去掉,影片其餘內容保持不變。
參考素材
@Image1
@Video1
提示詞
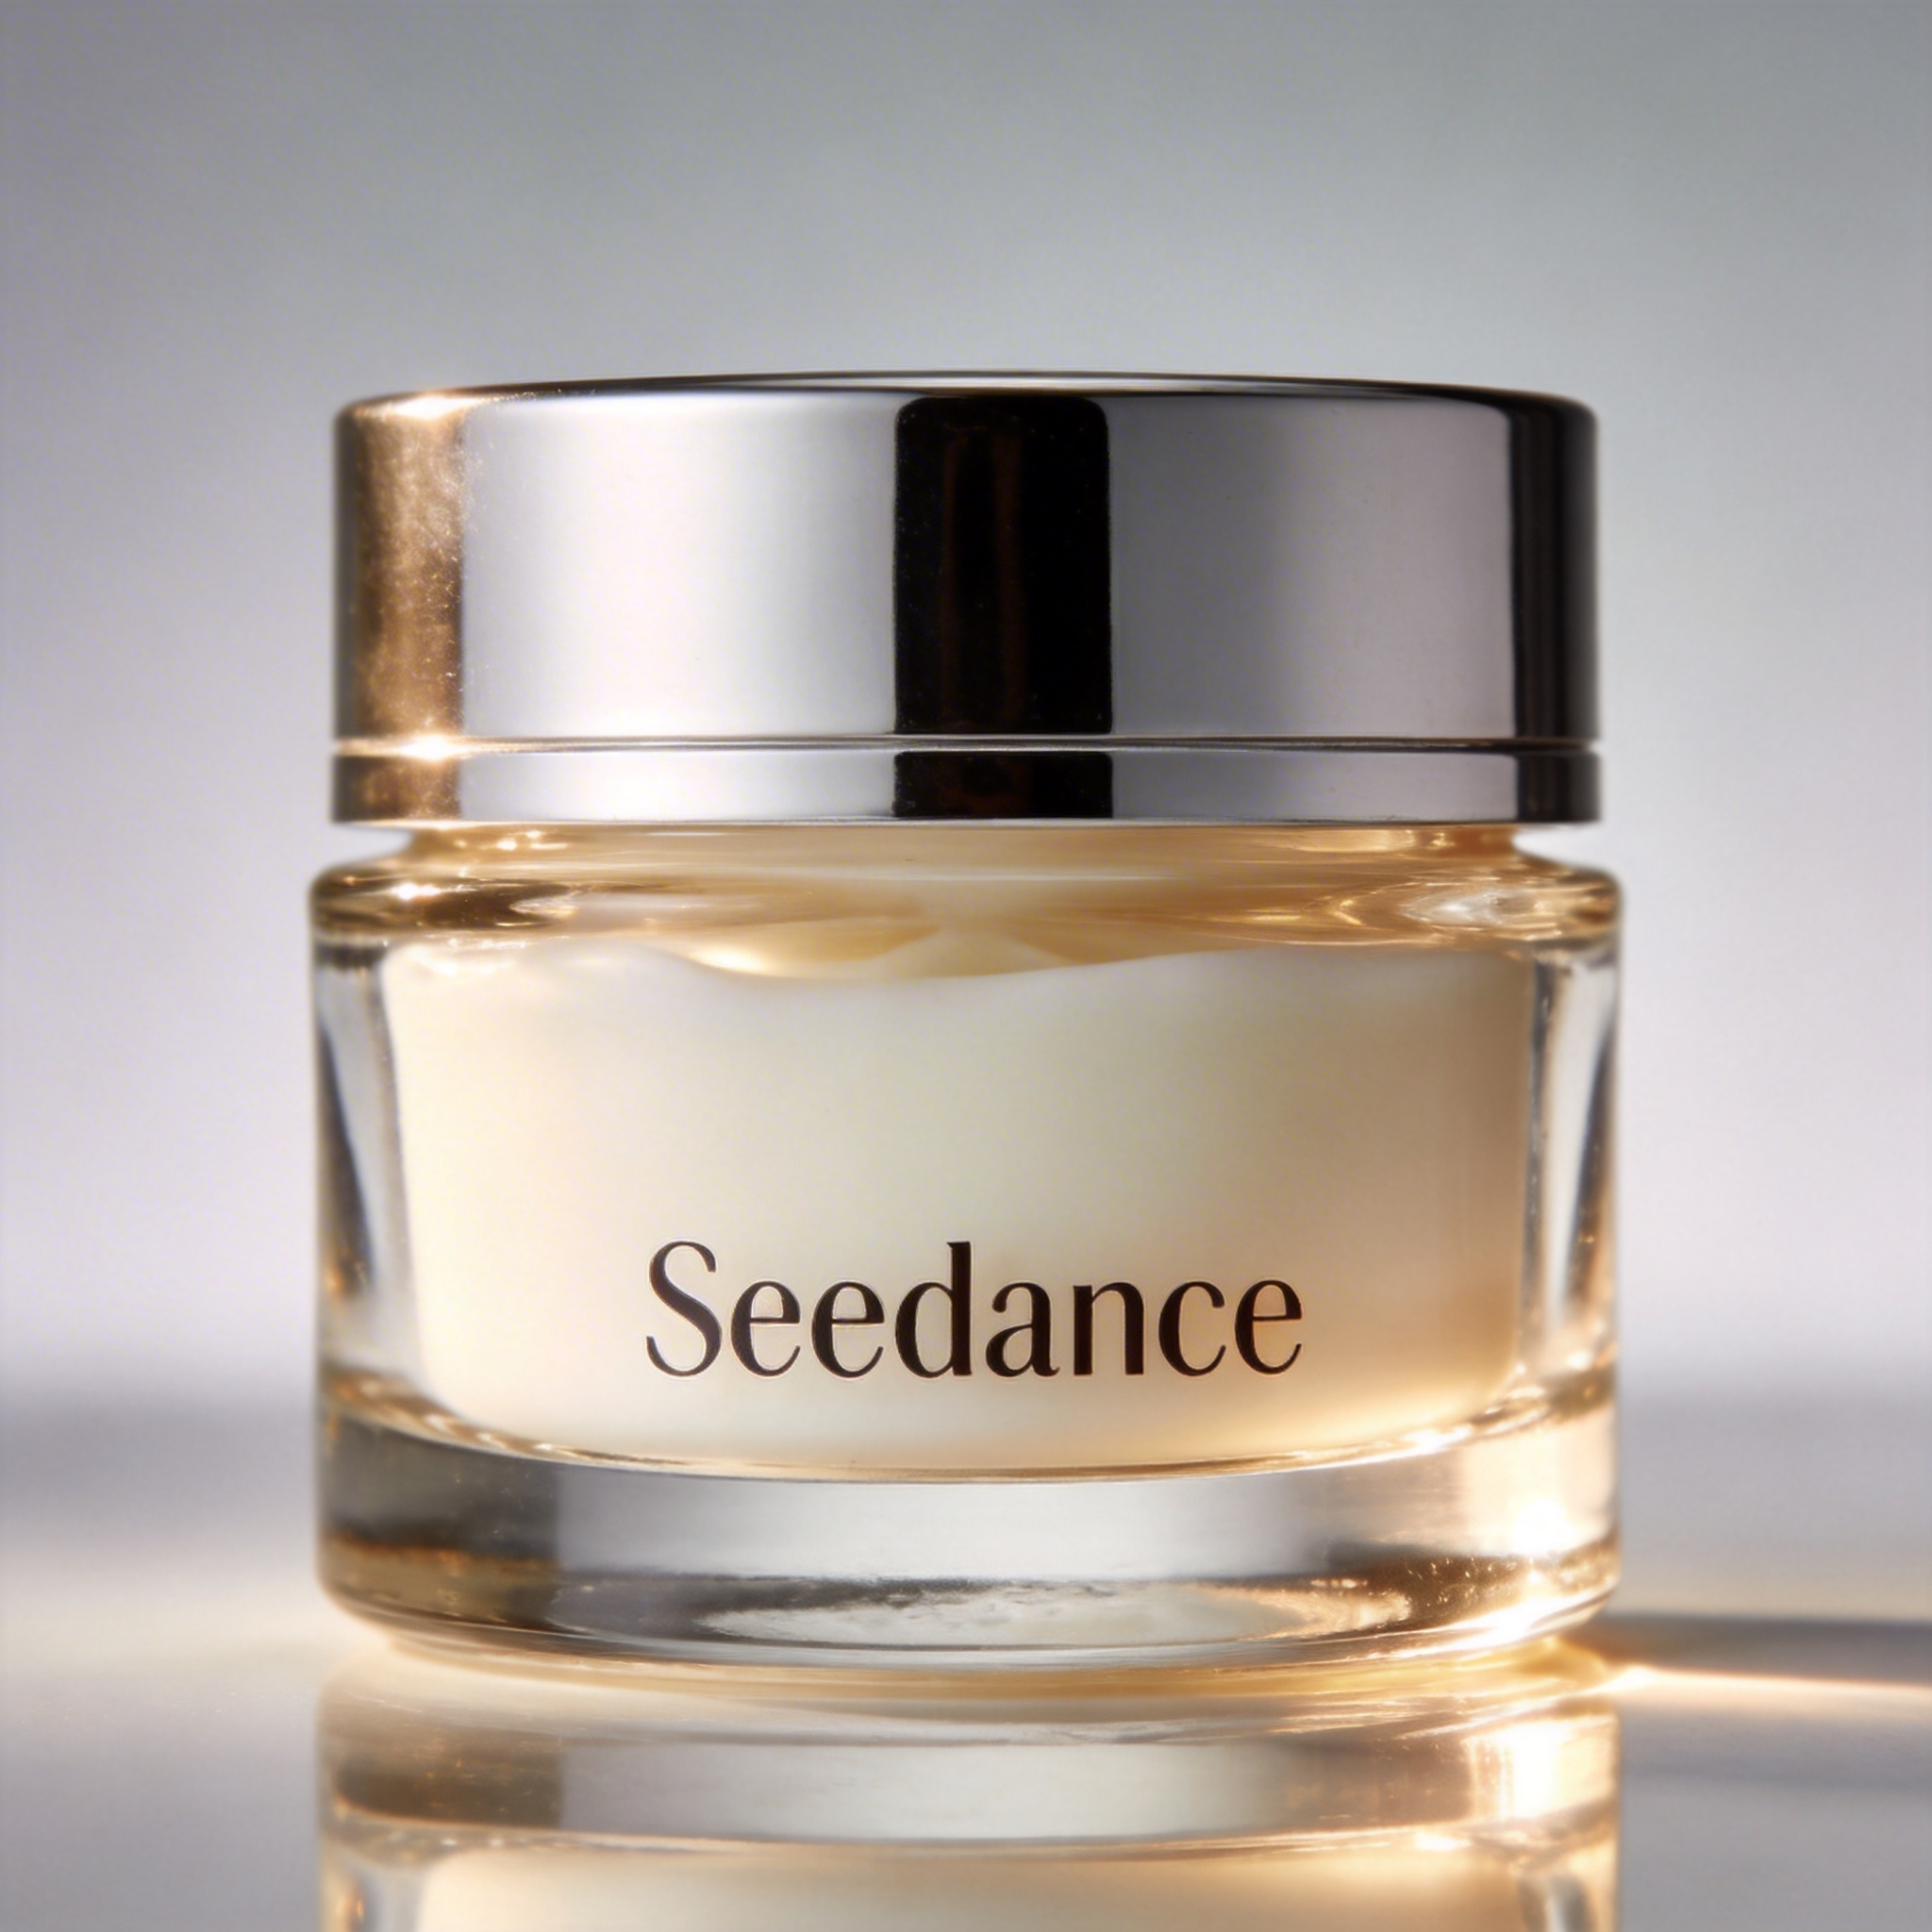
Replace the perfume featured in @Video1 with the face cream from @Image1, with all original motions and camera work preserved.
中文
把 @Video1 裡的香水換成 @Image1 裡的面霜,原來的動作和運鏡都保留。
延長影片
向前延長,生成的是這條影片之後的內容。向後延長,延長的是這條影片的開頭片段。
參考素材
@Video1
提示詞
Generate the content after @Video1: the two men who are late run towards them, the five people finally meet and have a friendly chat.
中文
生成 @Video1 之後的內容:兩個遲到的男人朝他們跑來,五個人終於見面,友好地聊天。
參考素材
@Video1
提示詞
Extend the opening segment of @Video1: Set up an over-the-shoulder shot of the man in a hoodie, and the man says: "It's not that bad. You're just stressed. Everyone goes through this, you just need to keep going."
中文
延長 @Video1 的開頭:用過肩鏡頭拍穿連帽衫的男人,他說:"It's not that bad. You're just stressed. Everyone goes through this, you just need to keep going."
軌道補全
@Video1,然後是銜接段,隨後是 @Video2。
參考素材
@Video1
@Video2
提示詞
@Video1. The moment a leaf falls to the ground, it sets off a special effect of golden particles. A gust of wind blows by, leading into @Video2.
中文
@Video1。一片葉子落地的瞬間,帶起金色粒子特效。一陣風吹過,接到 @Video2。
上限一覽
| Seedance 2.0 系列 | |
|---|---|
| 參考圖片 | 最多 9 張 |
| 參考影片 | 最多 3 條,每條 2–15 秒,合計 15 秒 |
| 參考音訊 | 最多 3 條,每條 2–15 秒,合計 15 秒 |
| 輸出時長 | 4–15 秒 |
| 輸出解析度 | 2.0:480p–4K;Fast 和 Mini:480p / 720p |
參考影片應當為 480p 或 720p、24–60 fps。