Panduan ini mengikuti standar resmi dan menambahkannya. Berlaku untuk keluarga Seedance 2.0 (2.0, 2.0 Fast, dan 2.0 Mini). Prompt yang baik membuat efek Seedance keluar.
Rumus dasar
Seri model Seedance 2.0 mendukung perujukan aset multimodal seperti video, gambar, dan audio pada saat yang sama. Model dapat mengunci dengan akurat ciri seperti penampilan karakter, efek aksi, gaya visual, dan timbre sulih suara, sehingga ambang menulis prompt jauh lebih rendah. Atas dasar itu, arahkan model dengan rumus dasar yang sederhana, memakai ciri aset multimodal untuk cepat menghasilkan video yang memenuhi persyaratan tertentu.
Pembuatan video berbasis referensi terbagi menjadi tiga jenis tugas: referensi omni (omni reference), menyunting video, dan memperpanjang video. Pilih rumus prompt dasar menurut jenis tugas. Ketiga jenis itu juga dapat dipakai bersama.
Referensi omni
Ambil sebagian elemen dari aset (seperti subjek, gaya, adegan, dan efek suara) untuk menghasilkan video yang sama sekali baru.
Skenario yang cocok: pemindahan aksi, pemakaian ulang subjek, referensi suasana, dan pekerjaan sejenis.
Pola yang disarankan:
- Referensi gambar: rujuk subjek di
@Image1untuk menghasilkan… - Referensi video: rujuk gerak di
@Video1untuk menghasilkan… - Referensi audio: rujuk timbre di
@Audio1untuk menghasilkan…
Di studio ini, referensi omni (omni reference) adalah Multi-Referensi. Ketik @ di kotak prompt dan pilih berkas. Berkas disisipkan sebagai @Image1, @Video1, atau @Audio1, bernomor menurut urutan unggah di dalam jenis itu. Setiap gambar mini menampilkan tokennya. Jika Anda menghapus satu berkas, token tersisa dari jenis itu dinomori ulang. Pola di atas tetap harus menyebut elemen mana yang Anda ambil. Token saja tidak memberi tahu model apakah Anda menginginkan wajah, gerak, gaya, atau timbre.
Menyunting video
Buat perubahan sebagian atau menyeluruh berdasarkan video asli. Bagian yang tidak disebut tetap tidak berubah secara bawaan.
Skenario yang cocok: penggantian lokal, penghapusan subjek, perubahan atribut, dan pekerjaan sejenis.
Pola yang disarankan:
- Menambah elemen: jelaskan dengan jelas
@Video1+ elemen baru + letaknya. - Mengubah elemen: sunting
@Video1secara ketat, dan ubah satu elemen di dalamnya menjadi elemen lain. - Menghapus elemen: sebutkan elemen yang perlu dihapus. Untuk elemen yang harus tetap, tekankan di dalam prompt agar hasilnya lebih baik.
Memperpanjang video
Lanjutkan video asli sepanjang dimensi waktu, dengan syarat gaya audio-visual, subjek, dan narasi tetap konsisten.
Skenario yang cocok: melanjutkan alur, memperpanjang aksi, menyelesaikan klip, dan pekerjaan sejenis.
Pola yang disarankan:
- Perpanjang video: perpanjang
@Video1ke depan atau ke belakang untuk menghasilkan… - Penyelesaian trek:
@Video1+ apa yang terjadi, diikuti@Video2+ apa yang terjadi berikutnya.
Untuk tugas sunting dan perpanjang, rujuk video secara langsung: "strictly edit @Video1", "extend @Video1 forward". Jangan menulis "reference @Video1" untuk tugas ini. "Reference" adalah pola referensi omni (omni reference), dan model dapat membaca suntingan atau perpanjangan sebagai klip yang sama sekali baru.
Gambar ke Video adalah mode terpisah. Frame pertama dan frame terakhir tidak dapat dicampur dengan berkas referensi dalam satu pembuatan. Frame pertama adalah pembuka, dan rasio aspek mengikuti gambar itu. Nyalakan Tambah frame akhir saat frame penutup juga harus dikunci, dan jelaskan hanya apa yang terjadi di antara dua frame. Nyalakan Kembalikan frame akhir sebelum membuat. Saat klip siap, Lanjutkan dari sini memakai frame akhir itu sebagai frame pertama klip berikutnya, sehingga sambungan terkunci pada sebuah gambar. Itulah cara studio ini, terkunci pada frame, untuk melanjutkan. Rumus perpanjangan resmi tetap berlaku saat sumbernya adalah video di Multi-Referensi.
Tugas gabungan
Tiga jenis tugas di atas juga dapat dipakai bersama.
Skenario yang cocok: merujuk satu aset dan menyunting aset lain.
Pola kalimat yang disarankan: rujuk [Dimensi_Referensi] dari @Video1, sunting @Video2 secara ketat, [Suntingan_Khusus].
[Dimensi_Referensi] adalah satu hal yang Anda ambil dari berkas pertama, seperti gerak kamera, sebuah efek, atau sebuah timbre. [Suntingan_Khusus] adalah satu-satunya perubahan yang Anda inginkan pada berkas kedua. Segala yang tidak Anda sebut dalam suntingan tetap ada.
Rumus lanjutan
Seedance 2.0 pada dasarnya adalah sutradara AI multimodal: ia membaca prompt teks, gambar, video, dan audio Anda sekaligus, lalu di dalam memecahnya menjadi dua dimensi, lapisan spasial (spatial layer, apa yang ada di dalam frame) dan lapisan temporal (temporal layer, bagaimana hal-hal berubah seiring waktu), untuk memahami dan menghasilkan gambar.
Prompt yang baik bukan sekadar uraian bergaya naskah iklan, melainkan instruksi bergaya rekayasa: siapa, di adegan apa, melakukan aksi apa, bagaimana kamera bergerak, dan dalam urutan kronologis apa peristiwa terjadi, masing-masing diserahkan ke lapisan spasial (spatial layer) dan lapisan temporal (temporal layer).
1. Tentukan subjek
Pada aset referensi yang nyata, satu gambar sering berisi beberapa subjek. Untuk merujuk objek tertentu di dalam aset secara tepat, Anda harus menentukan subjek dengan jelas. Subjek dapat berupa orang, properti, adegan, dan seterusnya.
Definisi dasar
Syarat ciri inti: pakai 2–3 ciri statis yang jelas dan stabil (seperti pakaian, gaya rambut, penampilan, atau kategori) untuk menggambarkan subjek dan memastikan subjek dapat dikenali secara unik.
Contoh:
- Definisikan wanita berbaju merah dan bertopi jerami di
@Image1sebagai Subject 1. - Definisikan wanita berbaju merah dan bertopi jerami di
@Image1sebagai Zhang Hong.
Satu subjek lintas beberapa materi
Saat objek di beberapa aset menunjuk subjek yang sama, ikat mereka secara konsisten. Tuliskan bahwa wajah di @Image1 dan foto seluruh badan di @Image2 adalah orang yang sama.
Skenario multi-subjek
Saat beberapa subjek muncul dalam video, definisikan secara terpisah dan bedakan dengan label. Label harus unik dan stabil, dan label yang sesuai harus dipakai secara konsisten pada uraian berikutnya agar rujukan tidak ambigu.
Contoh: definisikan pria tinggi di @Video1 sebagai polisi, dan definisikan pria pendek yang lain sebagai pencuri. Adegan berlangsung di pasar ramai pada siang hari, dengan matahari terang, banyak kios buah, dan lalu lintas pejalan kaki yang padat, sehingga tercipta suasana pasar jalan yang hidup. Pencuri berlari ke depan dalam kepanikan menembus pasar yang ramai, sementara polisi mengikuti dari dekat dengan kecepatan penuh. Keduanya cepat menyelinap di antara kios. Kamera genggam cepat mengikuti ke depan, dengan guncangan kamera realistis yang ringan, menciptakan suasana kejar-kejaran yang tegang.
Setiap kali sebuah subjek terlibat, subjek itu harus disebut secara eksplisit, agar tidak terlewat. Dua pemakaian didukung:
- Untuk skenario sederhana dengan subjek yang belum didefinisikan, setiap kali subjek disebut, pakai @ untuk menekankan ikatan antara subjek dan aset. Contoh: Zhang San
@Image1. - Untuk skenario yang subjeknya sudah didefinisikan sebelumnya, setiap kali subjek disebut, pakai label yang sama. Setelah pria tinggi di
@Video1didefinisikan sebagai polisi dan pria pendek sebagai pencuri, kalimat berikutnya mengatakan polisi dan pencuri, bukan "the tall one" dan "the other man".
Saat memakai id pustaka aset, Anda tetap membutuhkan @Image1 atau @Video1 untuk merujuk subjek. Model tidak dapat langsung mengaitkan id aset dengan isi referensi, jadi jangan memakai id aset sebagai pengganti token berkas.
Jaga uraian sesingkat mungkin, hindari pengulangan, dan hindari benturan makna, seperti ciri yang saling bertentangan untuk subjek yang sama. Ungkapkan hubungan ruang terlebih dahulu lewat gambar referensi, sehingga uraian teks yang rumit berkurang.
Untuk satu orang, foto close-up wajah ditambah foto seluruh tubuh sudah cukup. Gambar karakter multi-view tidak disarankan di sini, karena lembar turnaround adalah penyebab umum ID drift.
2. Urutan bidikan
Pemodelan internal model memisahkan ruang dan waktu. Karena itu bentuk prompt yang ideal untuk video kompleks adalah storyboard berbasis garis waktu: pecah video menjadi beberapa bidikan, dan uraikan setiap bidikan secara dinamis sesuai urutan peristiwa: siapa + di mana + melakukan apa + bagaimana kamera bergerak.
Pakai urutan bidikan. Tulis storyboard sederhana Shot 1 / Shot 2 / Shot 3 untuk setiap segmen video, lalu gabungkan menjadi satu prompt utuh.
Contoh negatif: "A man runs nervously down the street, and the scene feels very cinematic."
Contoh positif:
- Shot 1: bidikan samping sebuah gang jalan; pria itu perlahan mulai berlari, dengan kesan napas yang cepat.
- Shot 2: pria itu menabrak kios buah; kamera berguncang cepat dan memberi close-up wajah pria yang ketakutan.
- Shot 3: pria itu memanjat tembok rendah lalu menghilang; kamera perlahan menarik mundur dan membeku pada jalan yang kosong.
Pakai pengenal seperti Shot 1, Shot 2, dan Shot 3 untuk menyusun isi sesuai urutan peristiwa, yang utama lebih dulu, yang sekunder kemudian. Jangan memaksakan batas ketat pada durasi setiap segmen. Utamakan agar model secara alami menghasilkan tempo berdasarkan alur. Dukungan model untuk pewaktuan yang presisi, seperti 0–3 detik, tidak stabil, dan memaksa batas durasi dapat menghasilkan hasil pembuatan yang tidak normal.
Susun setiap bidikan dalam urutan ini:
- Gerak kamera atau cara transisi bidikan, seperti "slowly push in from a wide shot", "fixed camera position", "cut to…".
- Aksi dan ekspresi subjek. Uraikan aksi kunci dan perubahan ekspresi karakter atau objek inti.
- Posisi atau perubahan ruang. Jelaskan adegan, posisi, atau hubungan ruang tempat subjek berada.
- Informasi audio. Uraikan efek suara, suara, dan musik latar yang sesuai dengan bidikan.
3. Syarat uraian aksi
Penghalusan gerak tubuh + pengkuantifikasi derajat. Aksi harus spesifik pada bagian tubuh seperti tangan, kaki, kepala, bahu, dan punggung, sekaligus dilengkapi uraian jangkauan, kecepatan, dan gaya. Contoh: mengangkat tangan perlahan, memutar kepala dengan cepat, mendorong keras dari tanah, sedikit menundukkan kepala.
Utamakan gerak kecil yang lambat, lembut, dan berkesinambungan. Utamakan gerak halus yang lambat, lembut, dan koheren, dan cobalah menghindari aksi berledakan tinggi serta berdinamika besar seperti sprint, lompatan besar, dan gulingan yang keras. Contoh: berjalan perlahan, mengangkat tangan dengan lembut, sedikit menundukkan kepala, duduk secara alami mengikuti gerak.
Lengkapi transisi antaraksi. Sebutkan inersia dan kesinambungan antara aksi sebelumnya dan sesudahnya agar gerak di layar koheren dan alami. Contoh: memakai inersia berbalik untuk mengangkat tangan secara alami, beralih secara alami dari jeda ke mengangkat tangan.
Ungkapan lahiriah emosi yang konkret. Pakai detail fisik yang spesifik untuk menyatakan emosi, menggantikan kata abstrak seperti "very sad" dan "extremely angry."
| Emosi abstrak | Diwujudkan sebagai aksi dan detail |
|---|---|
| Kesedihan | menundukkan kepala, bahu sedikit bergetar, mata memerah, jari tanpa sadar mencengkeram ujung pakaian, air mata menggenang di mata tetapi tidak jatuh |
| Kegembiraan | sudut mulut naik tanpa terkendali, alis dan mata mengendur, langkah menjadi ringan, tanpa sadar bersenandung, tidak mampu menahan diri untuk berputar di tempat |
| Gugup / cemas | sering melihat jam, jari terus mengetuk permukaan meja, napas cepat, mata mengalihkan pandang, tanpa sadar menggigit kuku |
| Kemarahan | kedua tinju terkepal, garis rahang tegang, dada naik turun dengan keras, mata setajam pisau, kata-kata diperas dari sela gigi yang terkatup |
| Lega | mengembuskan napas panjang, bahu yang tegang sepenuhnya mengendur, senyum samar yang lama hilang muncul di wajah, menengadah ke kejauhan |
4. Prompt gerak kamera
Model memahami istilah gerak kamera dengan kuat, jadi Anda dapat langsung memakai istilah gerak kamera standar, seperti "medium shot, close-up, wide shot, slow push-in, smooth lateral tracking, fixed shot."
Usahakan hanya menyebut 1 jenis gerak kamera dalam satu bidikan. Jangan menuntut push, pull, pan, dan move pada saat yang sama, karena itu menambah ketidakstabilan gambar.
5. Kualitas gambar, gaya, dan kata pembatas
Kualitas gambar, gaya, dan kata pembatas adalah kunci untuk mengendalikan hasil pembuatan video. Semuanya dapat menetapkan batas kreatif bagi model, menyatukan kualitas gambar dan nada artistik, serta menghindari cacat visual dan penyimpangan acak, sehingga menjadi pengaturan yang perlu untuk menjamin keluaran akhir yang stabil dan sesuai.
- Kualitas gambar. Tentukan ketajaman gambar, tekstur yang rinci, dan kualitas cahaya untuk menaikkan kualitas dasar gambar video akhir. Contoh: HD, detail kaya, tekstur sinematik, warna alami, cahaya lembut.
- Gaya. Atur gaya seni keseluruhan dan nada visual untuk menyatukan suasana artistik gambar. Contoh: nada siberpunk dingin biru-ungu, film retro, gaya Jepang yang segar.
- Kata pembatas. Kata pembatas sangat penting. Kata ini dapat secara efektif menghindari cacat visual, deformasi, kerusakan, dan elemen yang tidak masuk akal, serta membatasi batas pembuatan dan kestabilan.
Templat kata pembatas yang umum:
- Hindari menghasilkan takarir: "keep it subtitle-free", "avoid generating any text or subtitles".
- Hindari menghasilkan logo: "do not generate a logo".
- Hindari menghasilkan tanda air: "do not generate a watermark".
6. Kasus
Dua contoh ini menunjukkan cara memakai rumus lanjutan di atas. Kalimat yang diucapkan tetap di dalam {}, yaitu tanda dialog dari standar karakter khusus.
Contoh 1: Drama pendek emosional di asrama (berfokus pada dialog)
Persiapan aset:
@Image1: foto setengah badan pemeran wanita utama@Image2: gambar referensi adegan asrama@Video1: referensi gerak kamera untuk dialog dalam ruangan (dolly in/out bidikan sedang atau pan ringan)@Audio1: suara ambien dalam ruangan atau musik ringan
Use the girl in @Image1 as the main character, use @Image2 as the dormitory scene style reference, and refer to the camera movement in @Video1.

Shot 1: At dusk, girl @Image1 walks briskly to the dormitory entrance @Image2. The camera follows steadily in a medium shot. Warm yellow sunlight spills into the hallway from the window. She pauses at the doorway, takes a deep breath, and looks slightly nervous.

Shot 2: Girl @Image1 pushes the door open and enters the dormitory. The camera cuts to an indoor medium shot. Her roommates look up at her while organizing their books. One of them smiles and asks {How did the exam go? Did you pass?}. The camera slowly cuts between half-body close-ups of several people.

Shot 3: Girl @Image1 first lowers her head with a dejected expression. The camera gives her a close-up. Then she raises her head, unable to hold back a smile, laughs out loud, and says {I was kidding}. Her roommates start chasing and play-fighting with her. The camera slowly pulls back and freezes on a wide shot of the dormitory filled with laughter.

The entire video should have a high-definition cinematic documentary style, with warm tones and soft lighting. The character's face remains stable without deformation; movements are natural and smooth, with no stutter or flicker. The ambient sound blends naturally with @Audio1.
Contoh 2: Konfrontasi di tebing bergaya kuno (berfokus pada aksi/suasana)
Persiapan aset:
@Image1: pemeran wanita utama berbaju merah@Image2: pembunuh berbaju hitam (lawan)@Image3: gambar adegan tebing dan hutan bambu@Video1: referensi gerak kamera untuk konfrontasi bela diri@Audio1: hentakan drum yang ketat atau efek suara pertarungan
Use the woman in red from @Image1 as the female lead, use the woman in black from @Image2 as the opponent, use the cliff and bamboo forest environment in @Image3 as the scene reference, refer to the overall camera movement and action rhythm in @Video1, and synchronize the background sound effects with @Audio1.

Shot 1: At dusk, the camera slowly pushes in from a side medium shot of woman in red @Image1. She stands at the edge of the cliff and lifts a wine flask to drink. Her sleeves and robe hem sway gently in the mountain wind. The camera circles halfway around her, moving from the front to her back. In the distance, a figure in black is faintly visible in the bamboo forest.

Shot 2: The camera zooms and fades into a long shot. From a drone perspective, it overlooks the entire cliff and bamboo forest. The two characters stand at opposite ends of the cliff. The mountain wind lifts their robe hems and dust, and the rhythm slightly accelerates with the drum beats.

Shot 3: The camera cuts back to a ground-level close shot. The two slowly draw their swords and face off. Woman in red @Image1 shifts from a careless expression to a cold gaze. Woman in black @Image2 looks determined, and the sword tip trembles slightly. The camera steadily follows the two as they circle each other, finally freezing on a close-up of the instant before the two swords meet.

The overall visual style should feel like a cinematic wuxia world in misty rain, with cool tones, low saturation, a film-grain texture, and rich light-and-shadow layers. The characters' faces and body proportions remain stable without deformation. Movements are continuous and natural, not stiff, with no clipping or stutter.
Kiat lain
Pembuatan teks
Model seri Seedance 2.0 mendukung pembuatan teks yang umum. Model dapat secara otomatis mencocokkan gaya dan warna yang sesuai berdasarkan konteks, dan juga mendukung penentuan warna, gaya, cara muncul, waktu muncul, dan posisi muncul teks di dalam prompt. Saat menulis, utamakan karakter yang umum dan hindari karakter langka serta simbol khusus, agar tampilan terbaik. Saat ini skenario seperti slogan iklan, takarir, dan gelembung ucapan didukung. Kasusnya ada di bagian terakhir.
Templat prompt slogan: [Isi_Teks] + [Waktu] + [Penempatan] + [Gaya_Masuk/Kemunculan], [Atribut_Visual (Warna, Gaya_Huruf)].
Seedance 2.0 dapat mencocokkan gaya teks yang sesuai berdasarkan konteks. Jika Anda punya syarat ketat untuk tampilan teks, pakai contoh logo di bawah referensi banyak gambar.
Templat prompt takarir: tampilkan takarir di bawah-tengah bersama teksnya. Takarir harus tersinkron sempurna dengan irama dan tempo audio.
Perpanjangan video versus penyambungan bersegmen
- Pengambilan panjang yang berkesinambungan (perpanjangan video): cocok untuk adegan dialog di dalam satu adegan, seperti percakapan panjang, perkembangan emosi, dan gerak sepanjang satu jalur, untuk mendapat efek satu pengambilan yang imersif dan koheren.
- Titik balik adegan / aksi (penyambungan bersegmen): cocok untuk belokan alur atau adegan aksi yang kompleks dan cepat, seperti kejar-kejaran, pertarungan, dan montase. Klip mandiri dapat dibuat lalu disunting menjadi satu agar irama dan dampak visual terjaga.
Dalam produksi nyata, kedua cara biasanya digabung. Misalnya, pakai perpanjangan lebih dulu untuk menghasilkan percakapan yang koheren, lalu sambungkan bidikan kosong atau klip transisi, menyeimbangkan imersi dengan variasi irama.
Strategi konfigurasi aset
Aset biasanya dibagi menjadi empat peran fungsional:
- Penjangkaran karakter: mengunci penampilan karakter.
- Penetapan nada adegan: mengunci lingkungan dan gaya.
- Referensi gerak kamera: mengunci bahasa bidikan dan irama aksi.
- Suasana berirama: pakai audio untuk mengendalikan emosi dan timbre.
Konfigurasi yang disarankan, total 4–5 aset: 1–2 gambar karakter (close-up wajah / seluruh tubuh) + 1 gambar adegan + 1 video gerak kamera + 1 klip audio.
Tidak disarankan memakai batas aset secara penuh. Terlalu banyak aset menyulitkan model menilai prioritas ciri, yang mudah menyebabkan benturan gaya, identifikasi subjek yang kabur, dan hasil yang menyimpang dari harapan.
Di keluarga Seedance 2.0, audio tidak dapat dipasangkan dengan teks saja. Tambahkan sedikitnya satu gambar atau video bersama audio.
Hal yang perlu diperhatikan
Standar bahasa
Bahasa dialog harus konsisten, dan pencampuran bahasa Tionghoa serta bahasa Inggris sebaiknya dihindari, kecuali untuk nama diri.
Standar karakter khusus
Pemakaian simbol yang wajar di dalam prompt membantu model memahami jenis informasi yang berbeda secara akurat.
| Jenis informasi | Simbol | Contoh |
|---|---|---|
| Musik | () | (fast-paced rock music is playing in the background) |
| Efek suara | Tabel resmi membiarkan simbol ini terbuka. Uraikan suara dengan kata, pada baris audio bidikan. | |
| Dialog | {} | {Hello, world}. Jika dialog memakai bahasa yang kurang umum, bukan Tionghoa dan bukan Inggris, bahasanya harus ditandai, misalnya: says in Japanese {こんにちは} |
| Takarir | 【】 | 【Chapter One: Departure】 |
FAQ
Referensi wajah tidak akurat
Gejala khas. Penampilan karakter yang dihasilkan tidak konsisten dengan gambar referensi, atau terjadi pertukaran wajah di tengah video (ID drift), sehingga karakter di video menyerupai selebritas dan diblokir saat peninjauan.
Akar penyebab. Gambar referensi wajah tidak cukup efektif.
- Gambar referensi campuran. Memberi model satu gambar gabungan yang mencakup referensi wajah, referensi pose seluruh tubuh atau setengah tubuh, referensi pakaian, referensi detail, dan elemen referensi lain.
- Rasio wajah terlalu kecil. Pada gambar referensi campuran, area wajah menempati bagian yang terlalu kecil dari seluruh gambar. Saat mengekstrak ciri wajah, model memberi bobot yang tidak cukup dan mudah terganggu latar atau elemen lain.
Solusi. Perkuat kemandirian dan bobot referensi wajah.
- Siapkan gambar close-up wajah. Selain foto seluruh tubuh yang asli, siapkan gambar close-up wajah tambahan yang hanya berisi kepala karakter. Sebuah headshot, yang hanya mempertahankan wajah. Tanpa ekspresi adalah yang terbaik. Minimalkan elemen pengganggu seperti bahu, leher, dan latar.
- Tentukan subjek dengan jelas di dalam prompt: ciri wajah merujuk headshot, riasan dan penataan merujuk foto seluruh tubuh.
- Letakkan aset penting lebih dulu. Semakin sebuah aset membutuhkan rujukan yang presisi, semakin awal aset itu harus diletakkan di dalam prompt.
Untuk referensi karakter, headshot + foto seluruh tubuh sudah cukup. Memakai gambar karakter multi-view tidak disarankan. Aset multi-view berisi sudut yang berbeda dari karakter yang sama, dan model mudah mengenalinya sebagai beberapa subjek yang berbeda, yang justru memperburuk masalah ID drift.
Sebelum: karakter di video berganti wajah di tengah dan menyerupai selebritas. Sesudah: wajah tetap konsisten dengan gambar referensi sepanjang waktu.
Perbaikan
Prepare a close-up face image containing only the character's head, in addition to the full-body photo. No expression is best. Minimize shoulders, neck, and background. In the prompt: facial features reference the headshot, makeup and styling reference the full-body photo. Place the asset that needs precise reference earlier. A headshot plus a full-body photo is sufficient. Multi-view character images are not recommended: the model may identify them as multiple different subjects, which worsens ID drift.
Takarir yang tidak diharapkan muncul di video
Gejala khas. Prompt tidak meminta takarir, tetapi video yang dihasilkan berisi takarir.
Solusi. Tidak mungkin secara langsung menghindari pembuatan takarir 100%. Yang dapat dilakukan hanya menurunkan peluang dan menaikkan tingkat keberhasilan.
- Tambahkan instruksi pembatas yang eksplisit ke prompt: "Keep it subtitle-free" dan "Avoid generating any text or subtitles".
- Jika gambar atau video referensi berisi teks yang tidak esensial, hapus teks itu lebih dulu, dengan penyuntingan gambar atau video, lalu pakai aset tanpa teks sebagai masukan.
- Jika pemakaian Anda mengizinkan, utamakan pembuatan video berukuran lanskap. Peluang menghasilkan takarir pada lanskap jauh lebih rendah daripada potret. Anda dapat memotongnya menjadi potret di editor nanti.
Logo atau tanda air muncul di video
Gejala khas. Prompt tidak menyebut isi yang terkait tanda air, tetapi video yang dihasilkan berisi logo atau tanda air dari platform video lain.
Solusi. Tambahkan instruksi pembatas yang eksplisit ke prompt: "Do not generate watermarks" dan "Do not generate Logos".
Gaya bergeser
Gejala khas. Anda berharap menghasilkan gaya anime 2D atau 3D, tetapi gaya gambar referensi masukan relatif realistis, dan prompt tidak menekankan gaya video. Akibatnya video yang dihasilkan dapat bergeser ke gaya realistis live-action.
Solusi. Tambahkan kata pembatas gaya yang eksplisit ke prompt, seperti "2D Japanese anime style" atau "3D Chinese-style comic". Jika kontrol gaya yang lebih presisi diperlukan, ubah gambar referensi ke gaya sasaran lebih dulu sebelum membuat video.
Sebelum: gaya xianxia bergeser ke gaya live-action. Sesudah: mempertahankan gaya xianxia animasi CG Tionghoa 3D.
Prompt
Add an explicit style constraint, such as "2D Japanese anime style" or "3D Chinese-style comic". The after example maintains the 3D Chinese animation CG xianxia style. If more precise style control is required, first convert the reference image into the target style, then generate the video.
Jump cut pada titik transisi perpanjangan video
Gejala khas. Setelah perpanjangan video dipakai untuk menghasilkan video baru, saat video baru disambung dengan video asli, mungkin ada lompatan frame atau masalah putar balik pada sambungan.
Solusi. Saran saat ini adalah memperbaiki ini pada penyuntingan akhir dengan menyelaraskan keyframe. Optimalisasi mendasar akan tercapai lewat iterasi model di masa depan.
- Impor video yang akan disambung ke CapCut atau perangkat lunak penyuntingan video profesional lain.
- Pada sambungan pertama, potong 6 frame dari ujung segmen video sebelumnya.
- Pada saat yang sama, potong 1 frame dari awal segmen video berikutnya.
- Ulangi operasi di atas untuk semua titik sambungan.
- Ekspor dan periksa kelancaran video yang disambung.
Setelah penyelarasan frame video, lompatan ringan mungkin masih ada. Disarankan mengakhiri klip yang lebih awal pada saat potongan transisi, dan memulai video berikutnya dari adegan baru setelah potongan itu.
Sebelum: lompatan layar seketika atau putar balik isi terjadi pada titik transisi. Sesudah: transisi lebih mulus.
Perbaikan
Repair the join in post-editing by aligning keyframes. At the first join, trim 6 frames from the end of the previous video segment, and trim 1 frame from the beginning of the following video segment. Repeat for all stitching points.
Karakter terduplikasi
Gejala khas. Pada skenario dengan banyak karakter di dalam frame dan gambar karakter three-view diberikan sebagai aset referensi, dua karakter yang identik mudah muncul pada frame video yang dihasilkan yang sama.
Akar penyebab.
- Subjek karakter tidak didefinisikan dengan jelas di dalam prompt, sehingga model tidak dapat membedakan peran karakter yang berbeda secara akurat.
- Saat gambar karakter three-view atau multi-view dipakai sebagai aset referensi, pengenalan karakter oleh model mudah kacau, sehingga model menghasilkan karakter duplikat dengan penampilan yang sama.
Solusi. Tidak mungkin secara langsung menghindari masalah kembar 100%. Cara berikut hanya dapat menurunkan peluangnya dan menaikkan tingkat keberhasilan.
- Nyatakan kaitan karakter dan subjek dengan jelas. Definisikan setiap peran dengan jelas di dalam prompt dan sebutkan padanan antara peran dan gambar referensi. Tandai gambar referensi yang sesuai setelah setiap nama karakter dan jaga formatnya tetap konsisten. Contoh: Zhang San (sesuai dengan image 1) melempar buku tabungan hijau ke arah Li Si (sesuai dengan image 2), yang sedang berdiri.
- Tambahkan instruksi pembatas global. Tambahkan pembatas tetap di akhir prompt: sepanjang video, karakter dengan penampilan, pakaian, dan aksesori yang sepenuhnya identik dilarang. Jangan menghasilkan avatar duplikat atau efek kembar. Pertahankan hanya satu karakter yang sesuai pada frame yang sama, dan jangan mereproduksi salinan karakter yang berulang.
- Optimalkan aset referensi. Untuk gambar referensi karakter, utamakan foto mandiri satu orang. Aset three-view atau multi-view tidak disarankan.
- Sederhanakan dan optimalkan prompt. Jangan langsung memakai naskah lengkap sebagai prompt. Teks yang terlalu berlebih mudah menyebabkan kebingungan pada pemahaman model. Hapus uraian yang tidak relevan dan pastikan instruksi jelas serta terfokus.
Sebelum: kembar muncul di video. Sesudah: satu orang per peran.
Perbaikan
Clearly define each character role and the corresponding reference image, and keep the format consistent. Example: Zhang San (corresponding to image 1) throws the green passbook toward Li Si (corresponding to image 2), who is standing. At the end of the prompt: Throughout the video, characters with completely identical appearance, clothing, and accessories are prohibited. Do not generate duplicate avatars or a twin effect. Keep only a single corresponding character in the same frame, and do not reproduce repeated copies of characters. Prioritize independent single-person photos. Three-view or multi-view assets are not recommended. Do not paste the complete script as the prompt.
Penurunan kualitas gambar selama perpanjangan video
Gejala khas. Saat video yang dihasilkan model dipakai sebagai aset masukan untuk perpanjangan dan kelanjutan, terjadi penurunan kualitas gambar. Beberapa kelanjutan menumpuk penurunan itu, dan blok warna berbercak sangat mungkin muncul di wilayah wajah karakter.
Solusi. Cara berikut dapat meredakan penurunan kualitas gambar. Optimalisasi mendasar akan dilakukan kemudian lewat iterasi model.
- Ubah video asli menjadi video model putih, lalu pakai sebagai aset masukan untuk kelanjutan. Prompt referensi: ubah video menjadi model 3D putih (white 3D model). Semua karakter harus disatukan sebagai model 3D putih murni, tanpa warna, tanpa tekstur, dan tanpa bayangan; pakai latar putih murni, struktur yang stabil, dan gerak yang mulus.
- Utamakan gambar berdefinisi tinggi sebagai aset referensi.
- Kendalikan jumlah kelanjutan video secara wajar dan hindari kelanjutan bertumpuk yang berulang.
Sebelum: melanjutkan langsung berdasarkan keluaran model. Sesudah: mengubah keluaran model menjadi video model putih sebelum melakukan kelanjutan.
Prompt
Convert the video into a white 3D model. All characters should be unified as pure white 3D models, with no color, no texture, and no shadows; use a pure white background, stable structure, and smooth motion. Then continue from that white-model video. Prioritize high-definition images as reference assets, and avoid repeated stacked continuations.
Efek khusus tidak sesuai harapan
Gejala khas. Saat efek khusus tertentu diuraikan lewat teks prompt, efeknya mungkin tidak sesuai harapan. Misalnya jika prompt menentukan bahwa angka "2999" muncul dengan animasi hitung mundur, efek gulir angka yang benar-benar dihasilkan dapat meloncat secara acak dan gagal mengikuti logika hitung mundur yang standar.
Solusi. Pakai video referensi untuk menentukan efek khusus. Masukkan video efek khusus sasaran ke model sebagai aset referensi, agar model dapat memahami bentuk efek dan logika gerak secara akurat, dan hasil yang dihasilkan lebih sesuai harapan. Misalnya: cara angka "2999" muncul harus merujuk @Video1.
Sebelum: efek gulir angka terasa jelas sebagai lompatan yang kacau. Sesudah: setelah video efek gulir angka yang benar ditambahkan, hasil efek sesuai harapan.
Referensi
@Video1
Prompt
The way the number "2999" appears should reference @Video1.
Terlalu banyak karakter referensi
Gejala khas. Saat jumlah orang referensi melebihi 4, kestabilan keluaran model menurun, dan video yang dihasilkan dapat memiliki masalah seperti jumlah orang yang salah (misalnya terlalu sedikit atau terlalu banyak karakter) atau karakter terduplikasi.
Solusi. Hal ini dapat diredakan dengan cara berikut. Di masa depan, optimalisasi mendasar akan dilakukan berdasarkan iterasi model.
- Hasilkan gambar langkah demi langkah. Kelompokkan orang agar jumlah orang pada setiap gambar yang dihasilkan tidak melebihi 4. Misalnya, 6 orang dapat dibagi menjadi 2 kelompok yang masing-masing berisi 3 orang, dan gambar dapat dihasilkan secara terpisah.
- Hasilkan video dari gambar. Pakai beberapa gambar berkelompok yang dihasilkan pada langkah pertama sebagai aset referensi, lalu hasilkan video akhir.
Sebelum: memasukkan 8 karakter referensi, dan video keluaran memiliki 9 orang. Sesudah: menghasilkan 2 gambar dari 8 karakter, lalu memakai gambar-ke-video.
Perbaikan
When the number of reference people exceeds 4, group them so that each generated image contains no more than 4 people. For example, 6 people can be divided into 2 groups of 3. Generate those images first, then generate the video from the grouped images.
Derau di akhir video
Gejala khas. Saat video berisi narasi, bunyi klik yang tiba-tiba dan derau putus mudah muncul di akhir video.
Solusi. Buat ulang video, atau pakai editor seperti CapCut untuk menerapkan fade-out audio pada trek audio akhir melalui volume envelope, menghilangkan derau putus.
Langkah khusus, memakai CapCut:
- Impor video yang dihasilkan ke CapCut.
- Pilih trek video pada garis waktu dan klik Audio di bilah alat.
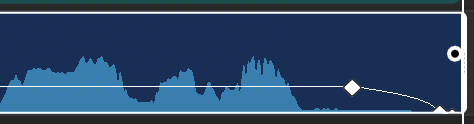
- Pilih fungsi Volume envelope. Pada beberapa versi fungsi ini berada di menu Basic / Adjust. Pilih keyframe. Sebuah garis yang mewakili volume dan keyframe akan muncul pada trek audio.
- Di dekat akhir video, seret keyframe volume terakhir ke bawah hingga volume 0 untuk membentuk lereng menurun. Kurva pada kartu adalah lereng itu.
- Pratinjau dan pastikan audio akhir memudar secara alami, tanpa putus mendadak atau derau.
Sebelum: ada derau di akhir. Sesudah: tidak ada derau di akhir.
Referensi
@Image1
Perbaikan
Regenerate the video, or fade the ending audio to silence with a volume envelope. Near the end, drag the final volume keyframe down to 0 so the curve in @Image1 forms a downward slope.
Pelafalan bahasa Tionghoa tidak akurat
Gejala khas. Model cenderung salah melafalkan karakter polifonik, karakter yang tidak umum, dan karakter yang bentuknya mirip.
Solusi. Anda dapat mengganti teks yang mudah salah baca dengan homofon yang umum dipakai dan berlafal sama, untuk menghindari penyimpangan pelafalan dan memulihkan efek audio yang diharapkan. Solusi ini hanya metode optimasi dan tidak dapat sepenuhnya menghindari semua masalah pelafalan.
Contoh: Anda dapat menulis ulang "螭龙山" di dalam prompt menjadi homofon "吃龙山".
Sebelum: pelafalan "螭" di dalam "螭龙山" salah. Sesudah: setelah diubah menjadi "吃龙山", pelafalannya benar.
Prompt
Replace text that is easy to misread with a commonly used homophone of the same pronunciation. Rewrite "螭龙山" as "吃龙山". This is an optimization and cannot completely avoid all pronunciation issues.
Referensi suara tidak akurat
Gejala khas. Saat audio referensi dipakai untuk menentukan suara, suara audio pada video akhir yang dihasilkan berbeda secara signifikan dari suara referensi.
Solusi.
- Tambahkan uraian rinci tentang ciri suara di dalam prompt. Baris kerja pada contoh ini adalah: pakai suara pria paruh baya yang rendah, tebal, hangat, dan berbutir halus dari
@Audio1. - Jaga gaya kalimat video agar dekat dengan nada dan gaya ungkap audio referensi, yang membantu meningkatkan pemulihan suara dan kestabilan.
Di Multi-Referensi, berkas itu adalah @Audio1. Di keluarga Seedance 2.0, pasangkan audio dengan sedikitnya satu gambar atau video.
Sebelum: suara tidak cocok dengan audio masukan. Sesudah: setelah uraian ciri suara ditambahkan ke prompt, ketepatan kecocokan suara meningkat secara signifikan.
Referensi
@Audio1
Prompt
Use the low, thick, warm, and finely grainy middle-aged male voice of @Audio1. Keep the style of the lines close to the tone and expression of that reference audio.
Contoh prompt
Bagian ini menampilkan contoh prompt resmi untuk pembuatan teks, referensi gambar, referensi video, dan penyuntingan video. Prompt pada setiap kartu mempertahankan kalimat resmi. Kalimat yang diucapkan dan kata di layar tidak diubah. @Image1, @Video1, dan @Audio1 adalah token studio ini untuk Image 1, Video 1, dan Audio 1. Di tempat prompt resmi menyebut Image 1, Image 2, dan Image 3, itu adalah label pada satu lembar referensi, dan lembar itu adalah berkas tunggal @Image1.
Slogan
Templat prompt: [Isi_Teks] + [Waktu] + [Penempatan] + [Gaya_Masuk/Kemunculan], [Atribut_Visual (Warna, Gaya_Huruf)].
Seedance 2.0 dapat mencocokkan gaya teks yang sesuai berdasarkan konteks. Jika Anda punya syarat ketat untuk tampilan teks, pakai contoh logo di bawah referensi banyak gambar.
Referensi
@Image1
Prompt
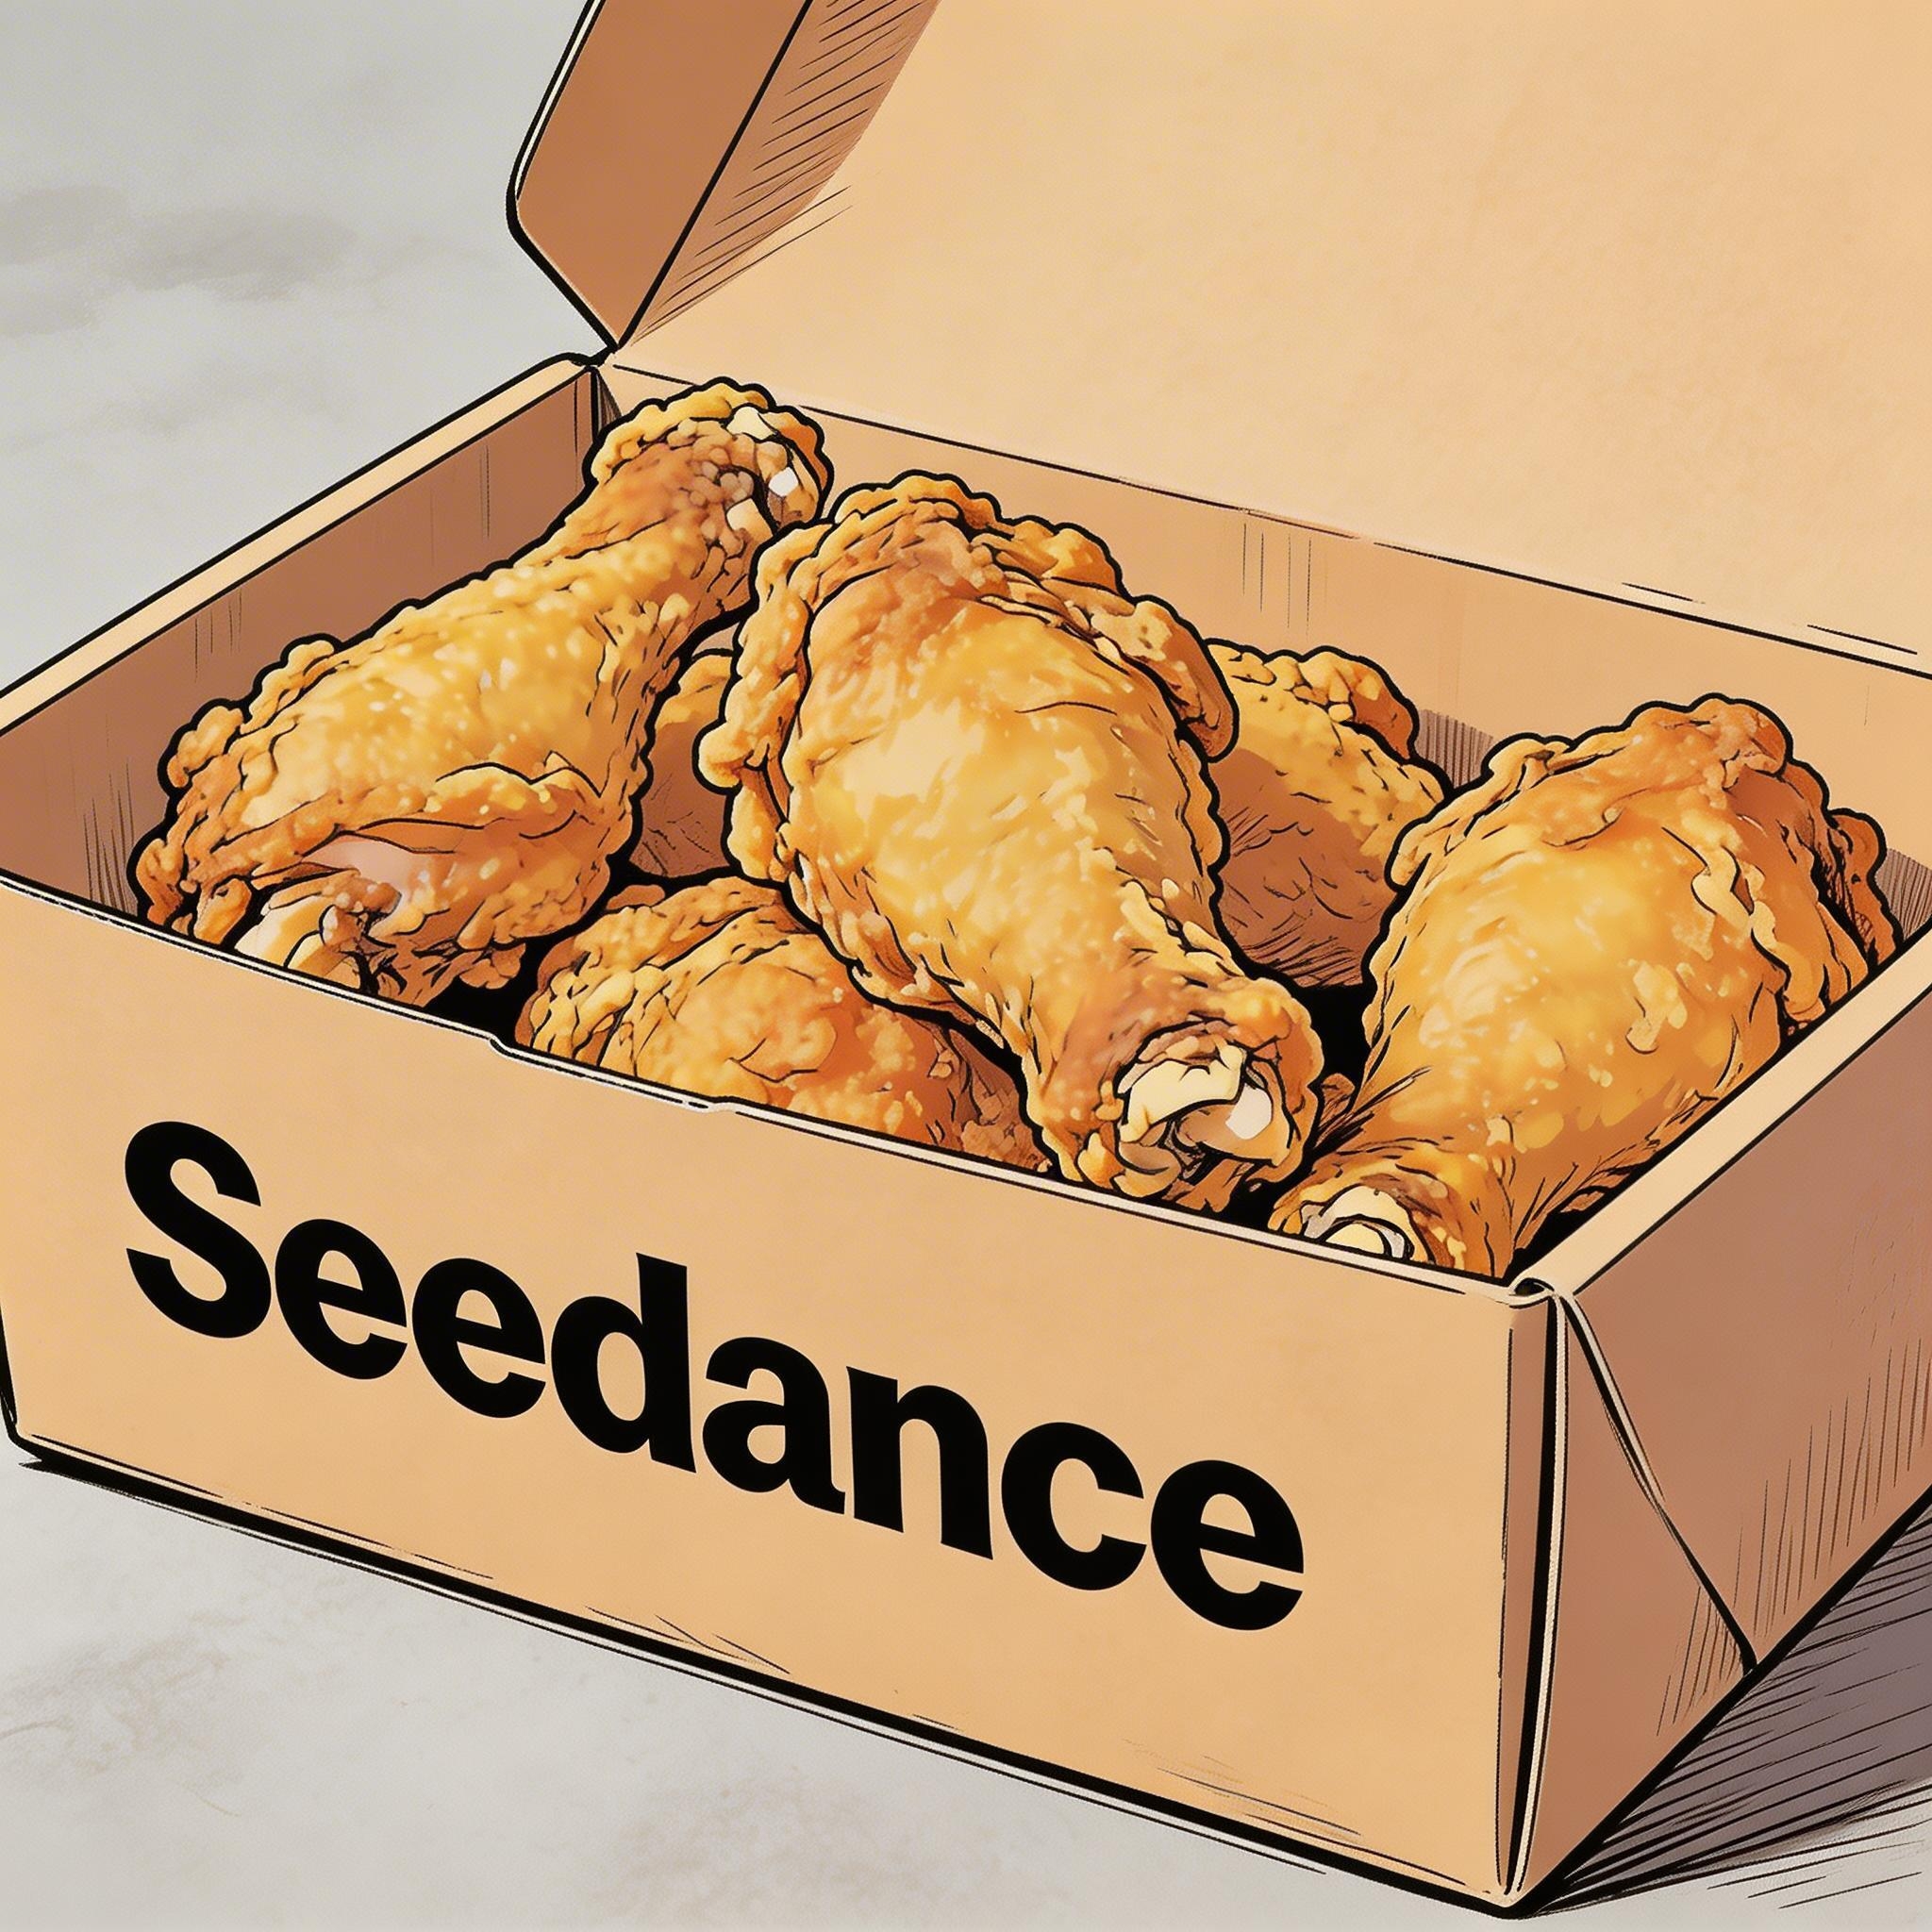
Hand-drawn comic style: Three people are sitting around a table enjoying the fried chicken shown in @Image1, with a friendly and joyful atmosphere. The frame then gradually blurs, and the text "Bite", "Laugh", and "Seedance" in order appears in the center of the screen.
Takarir
Templat prompt: tampilkan takarir di bawah-tengah bersama teksnya. Takarir harus tersinkron sempurna dengan irama dan tempo audio.
Contoh pertama adalah sulih suara. Contoh kedua adalah sulih suara ulang.
Referensi
@Image1
Prompt
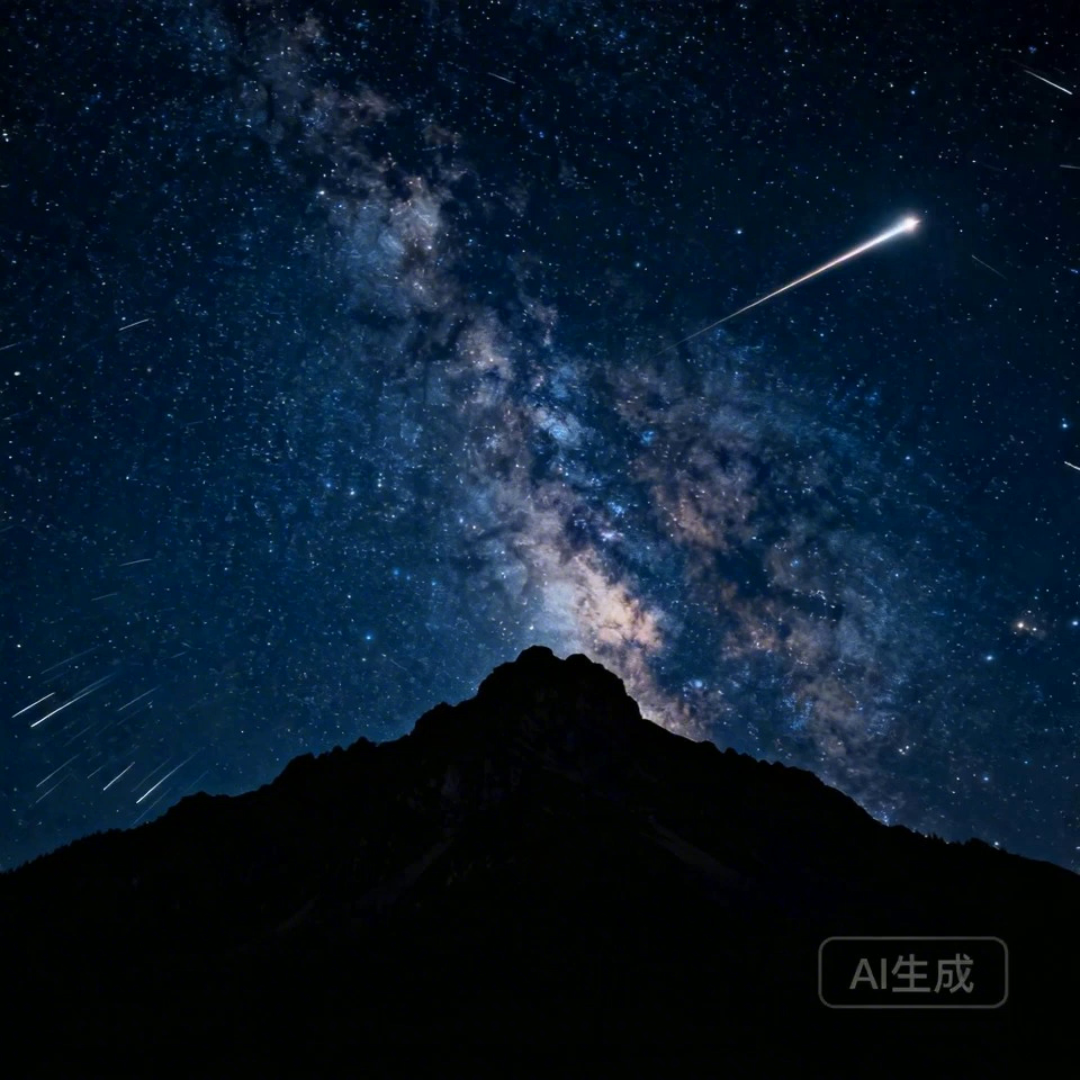
I2V: A time-lapse of a mountain landscape transitioning from a vast, starry night to a vibrant dawn. Reference @Image1. Voiceover: A deep, serene male voice says: "In the vast silence of the cosmos, our world is but a fleeting moment. Yet, within it, life defiantly thrives." Text integration: Render the narration as subtitles at the bottom-center. Subtitles must be perfectly synchronized with audio timing.
Referensi
@Image1
Prompt
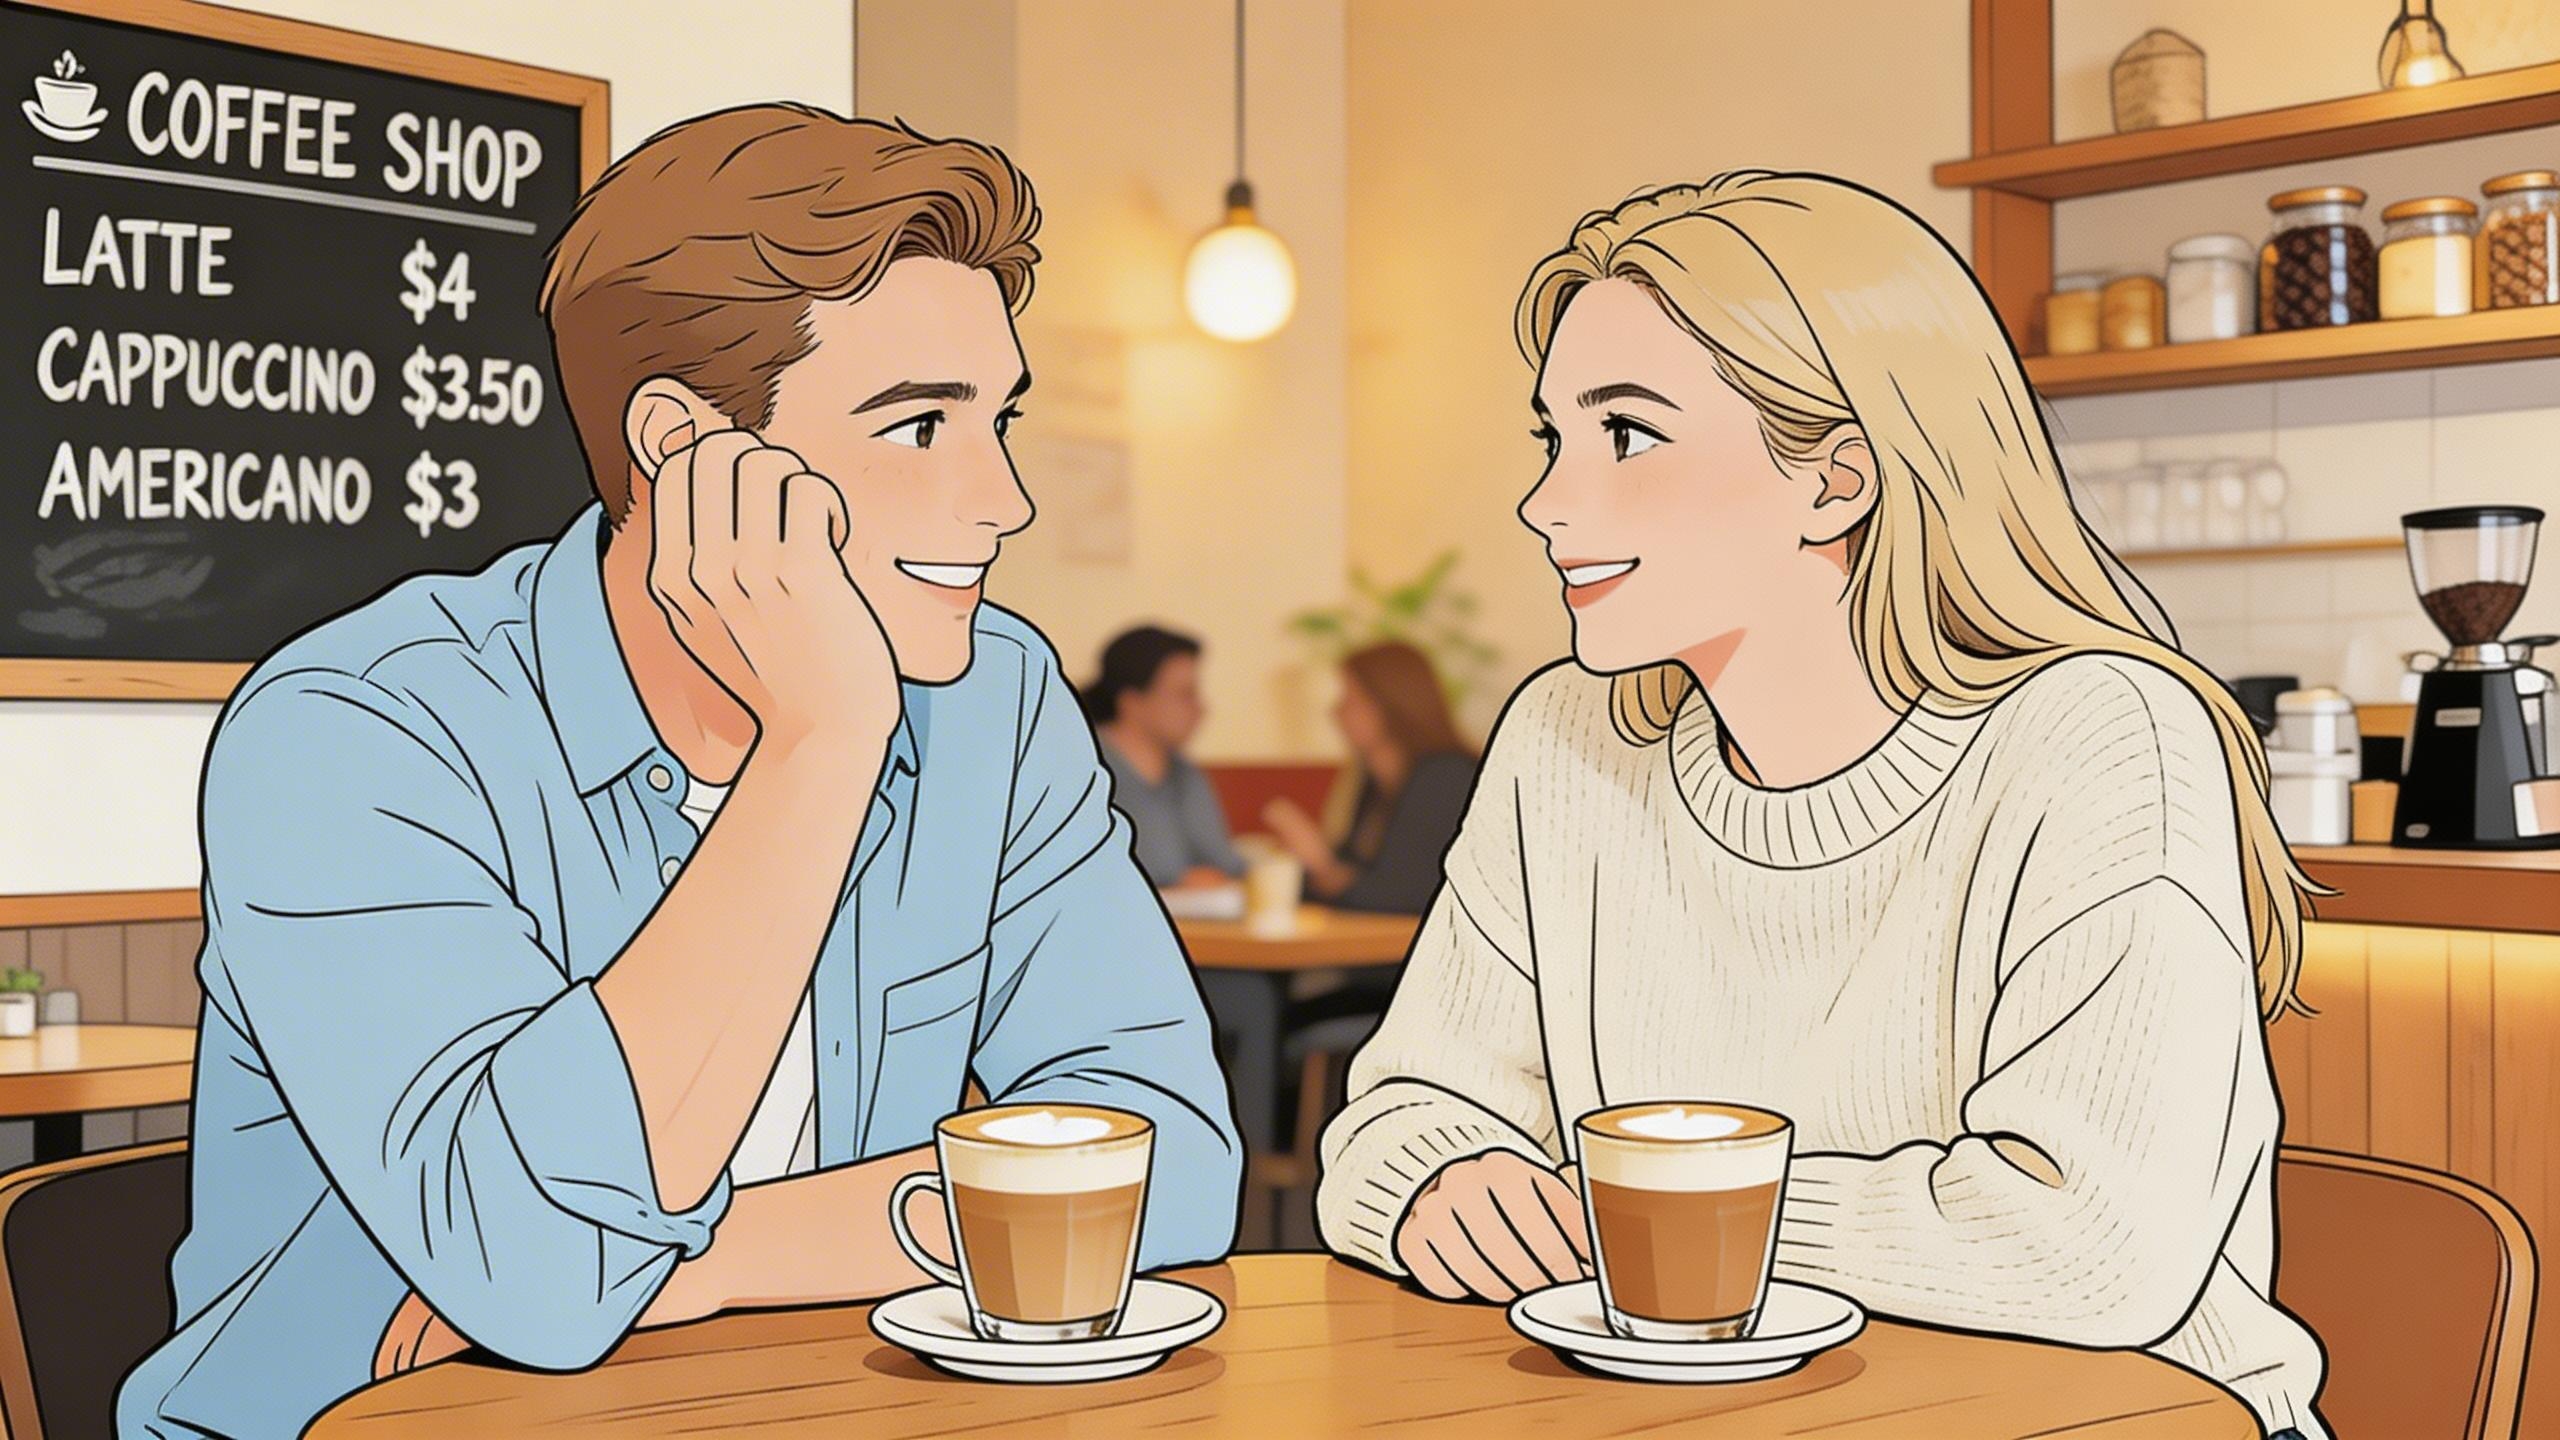
R2V: A shot of these two people in @Image1 chatting in a modern office. The woman speaks first with a playful tone: "You always arrive right on time, don't you just love that perfect timing?" followed by the man's smiling reply: "I have my own rhythm." Text integration: Render the dialogue as subtitles at the bottom-center of the screen. Subtitles should appear sequentially as each character speaks.
Gelembung ucapan
Gelembung ucapan berisi kalimat yang diucapkan dan muncul di samping karakter yang sedang berbicara.
Referensi
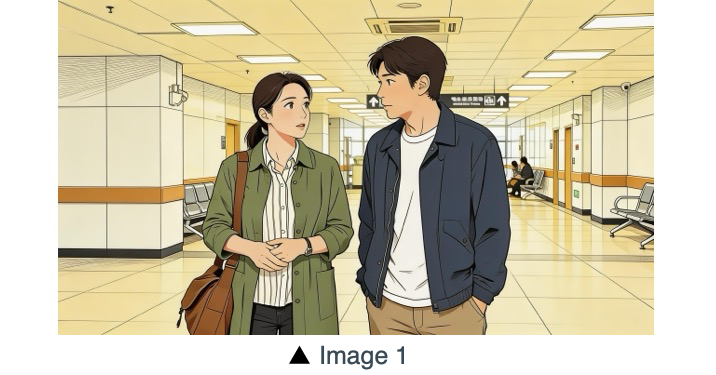
@Image1
Prompt
The two characters from @Image1, both dressed in sportswear, are running on the school playground. The girl looks at the boy, smiling confidently as she says: "We can definitely do it!". Cut to a close-up of the boy. He hesitates and replies: "Are you sure?". Cut back to a medium close-up of the girl. She speaks in a light, upbeat tone: "Yes!" Her demeanor is bright and resolute. Speech bubbles containing the corresponding lines appear around the speaking character.
Referensi
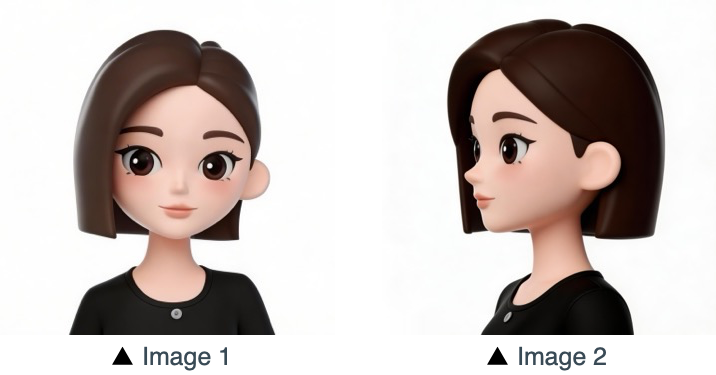
@Image1
Prompt
Refer to the character design of the girl in Image 1 and Image 2 on @Image1. The scene is set in an apple field: the girl picks one apple, takes a bite, smiles and says "This is the real deal!". A speech bubble pops up beside the girl, with this line written inside.
Referensi subjek multi-perspektif
Satu subjek, dirujuk dari beberapa sudut pada lembar: elektronik konsumen, rumah dan gaya hidup, serta seorang manusia.
Referensi
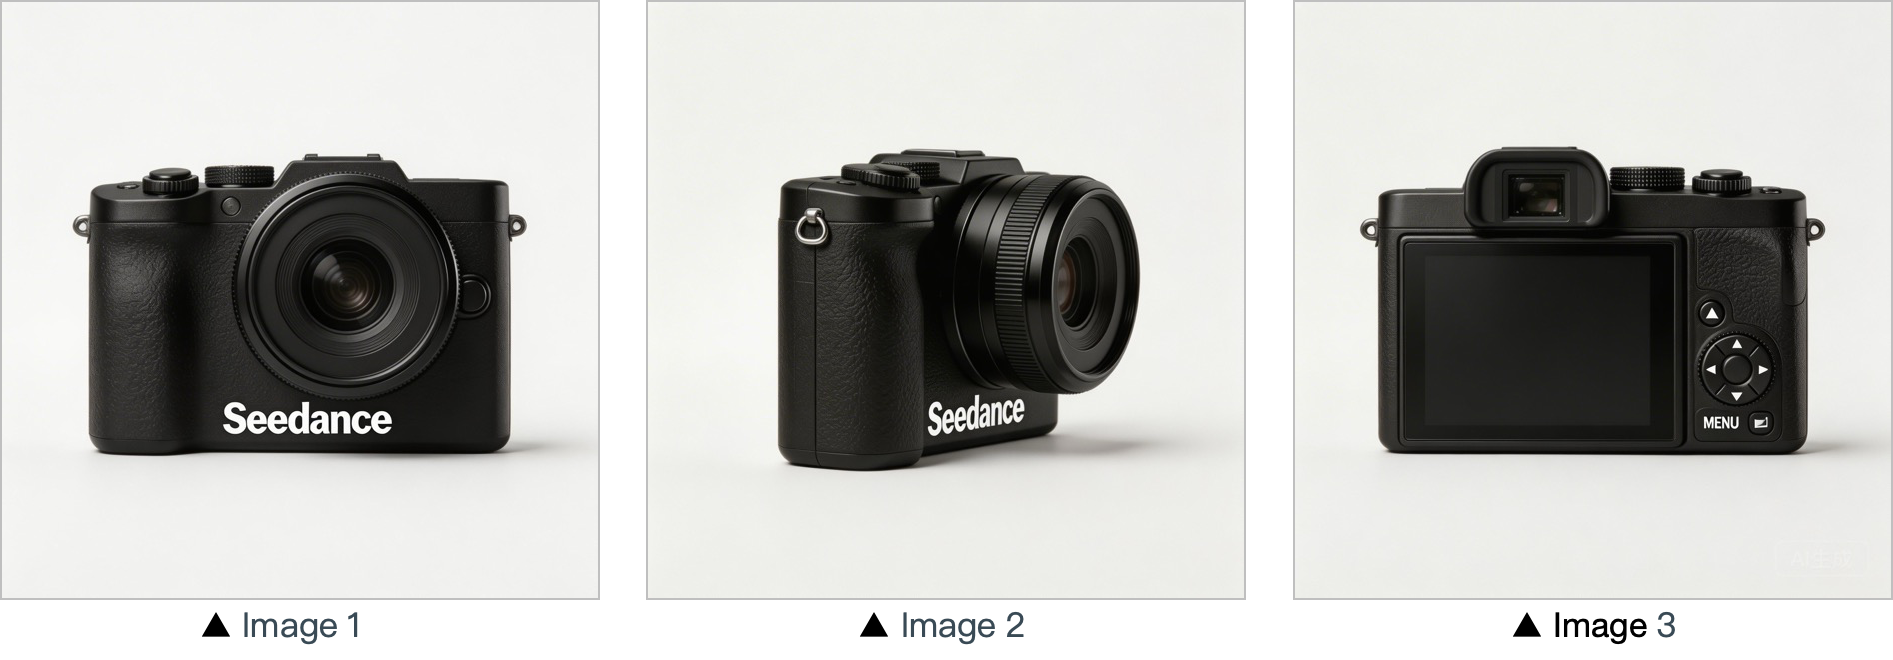
@Image1
Prompt
Use the cameras featured in Image 1, Image 2 and Image 3 on @Image1. Replace the original background with a white one, and place the cameras on a white table. The camera first focuses on the cameras in close-up, then slowly rotates 360° with the cameras as the main subject, clearly displaying the front, sides and back of each camera.
Referensi
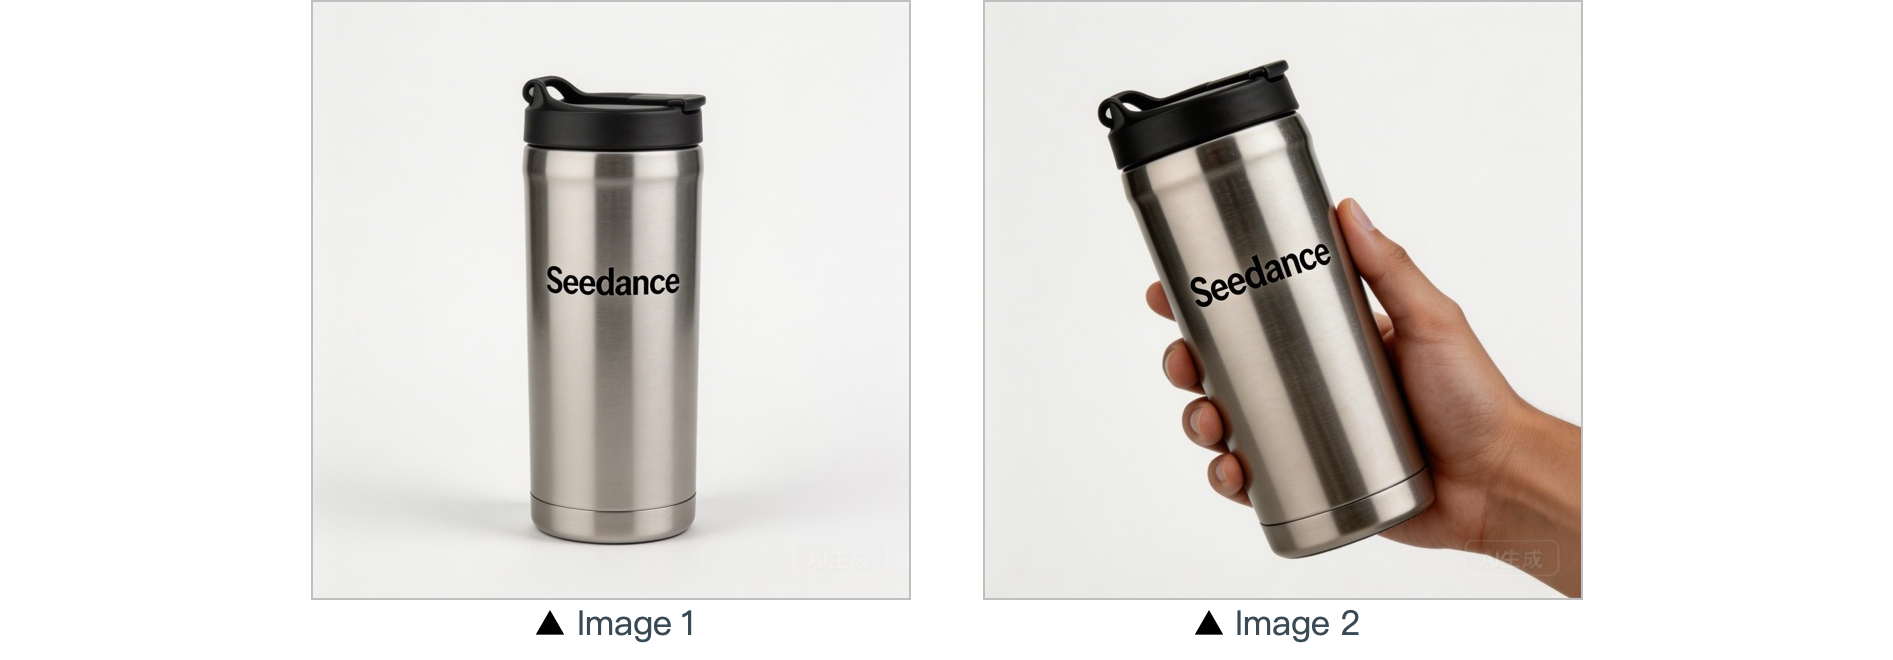
@Image1
Prompt
In a warm-toned home setting, present the thermos shown in @Image1 in a medium shot. Then smoothly push the camera into a close-up of the thermos. Next, a hand naturally enters the frame off-screen, gently grips the thermos body and picks it up. The camera follows the slight rotating motion of the hand to showcase the thermos.
Referensi
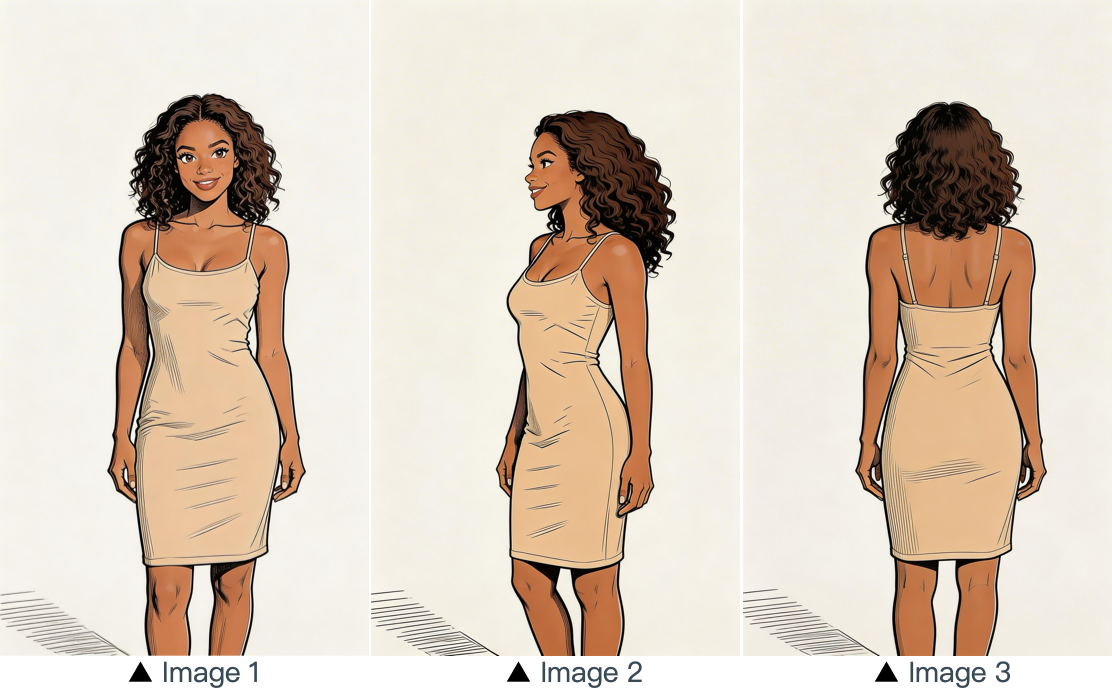
@Image1
Prompt
Refer to the image of the woman in Image 1, Image 2 and Image 3 on @Image1, and generate a scene of her eating a cake in a coffee shop.
Referensi banyak gambar
Setiap gambar pada lembar punya satu tugas: logo, beberapa subjek, satu pemeran dan satu tempat, urutan banyak panel, atau urutan frame.
Referensi
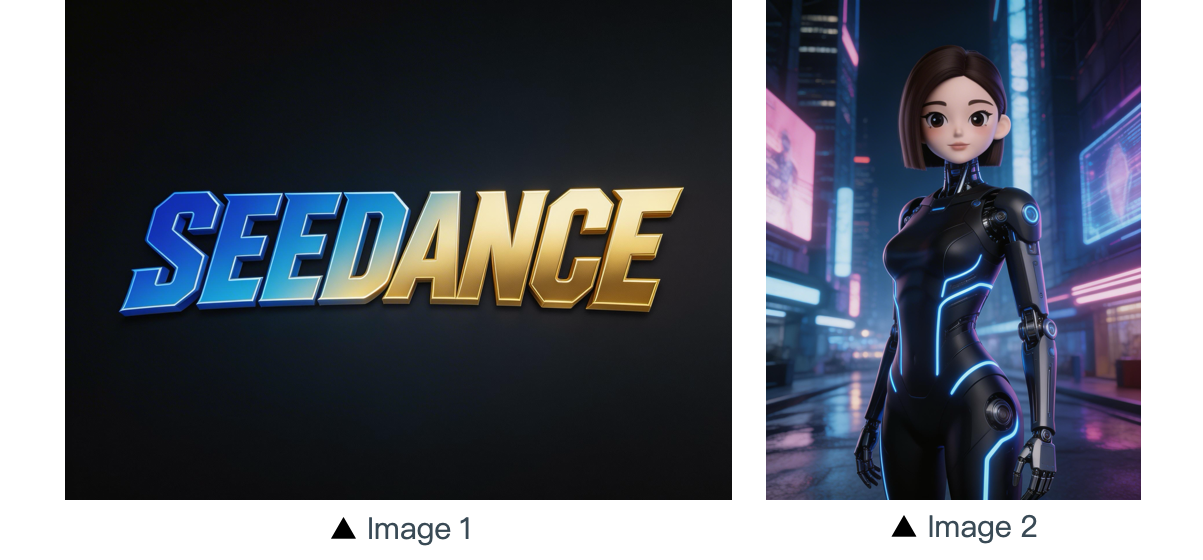
@Image1
Prompt
The scene is set on an aerial corridor in a neon-drenched futuristic metropolis, where flying vehicles and holographic ads intertwine. Featuring the girl from Image 2 on @Image1, the sequence opens with a medium shot of her releasing a silver floating lantern embedded with a holographic projection. The camera then pulls back to reveal floating lanterns flooding the sky, which gradually converge at the center of the frame to form the logo from Image 1 on @Image1. The entire piece adopts a 3D cyberpunk sci-fi animation style.
Referensi
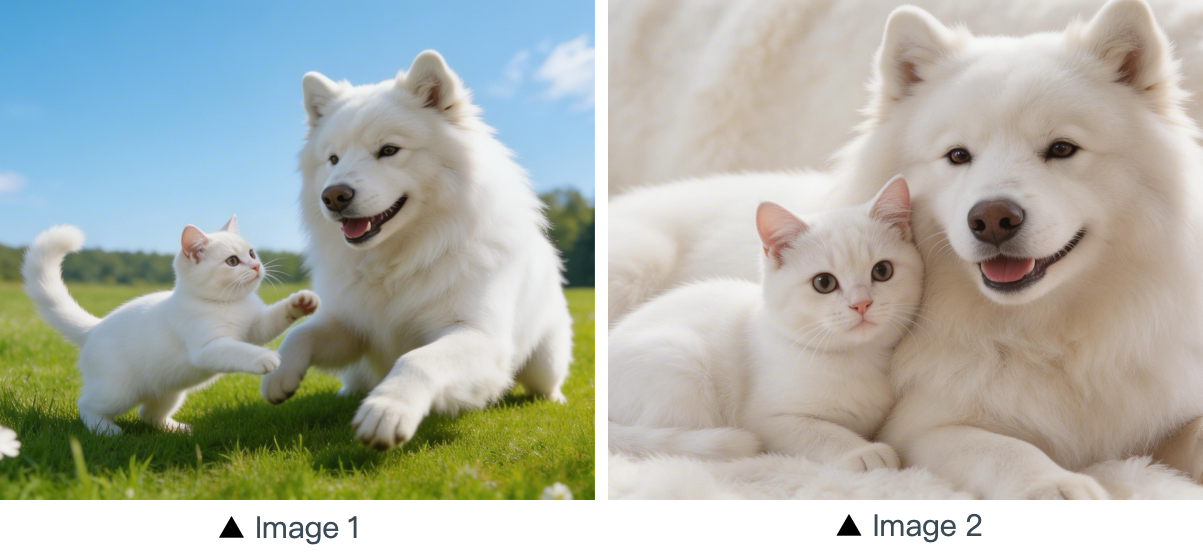
@Image1
Prompt
Using the cat and dog from Image 1 and Image 2 on @Image1 as prototypes, the scene unfolds in a cozy apartment. The dog is lying on the ground eating dog food when the cat approaches, extending a paw to nudge the dog. The dog pauses its meal upon noticing the cat, and the cat snuggles up next to the dog. The entire scene features a warm colored tone.
Referensi
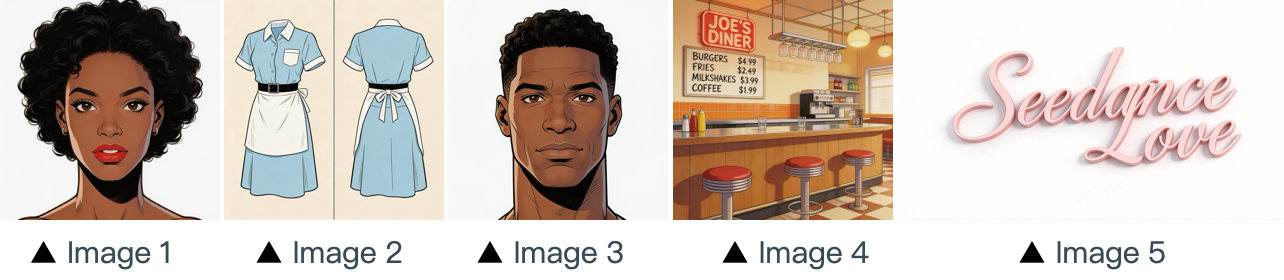
@Image1
Prompt
The scene is set in the restaurant from image 4 on @Image1, with people coming and going. The girl from image 1, wearing the clothes from image 2, is organizing the items on the counter. The boy, a customer, from image 3 approaches her to ask for her contact information. The logo from image 5 remains in the bottom right corner throughout.
Referensi
@Image1
Prompt
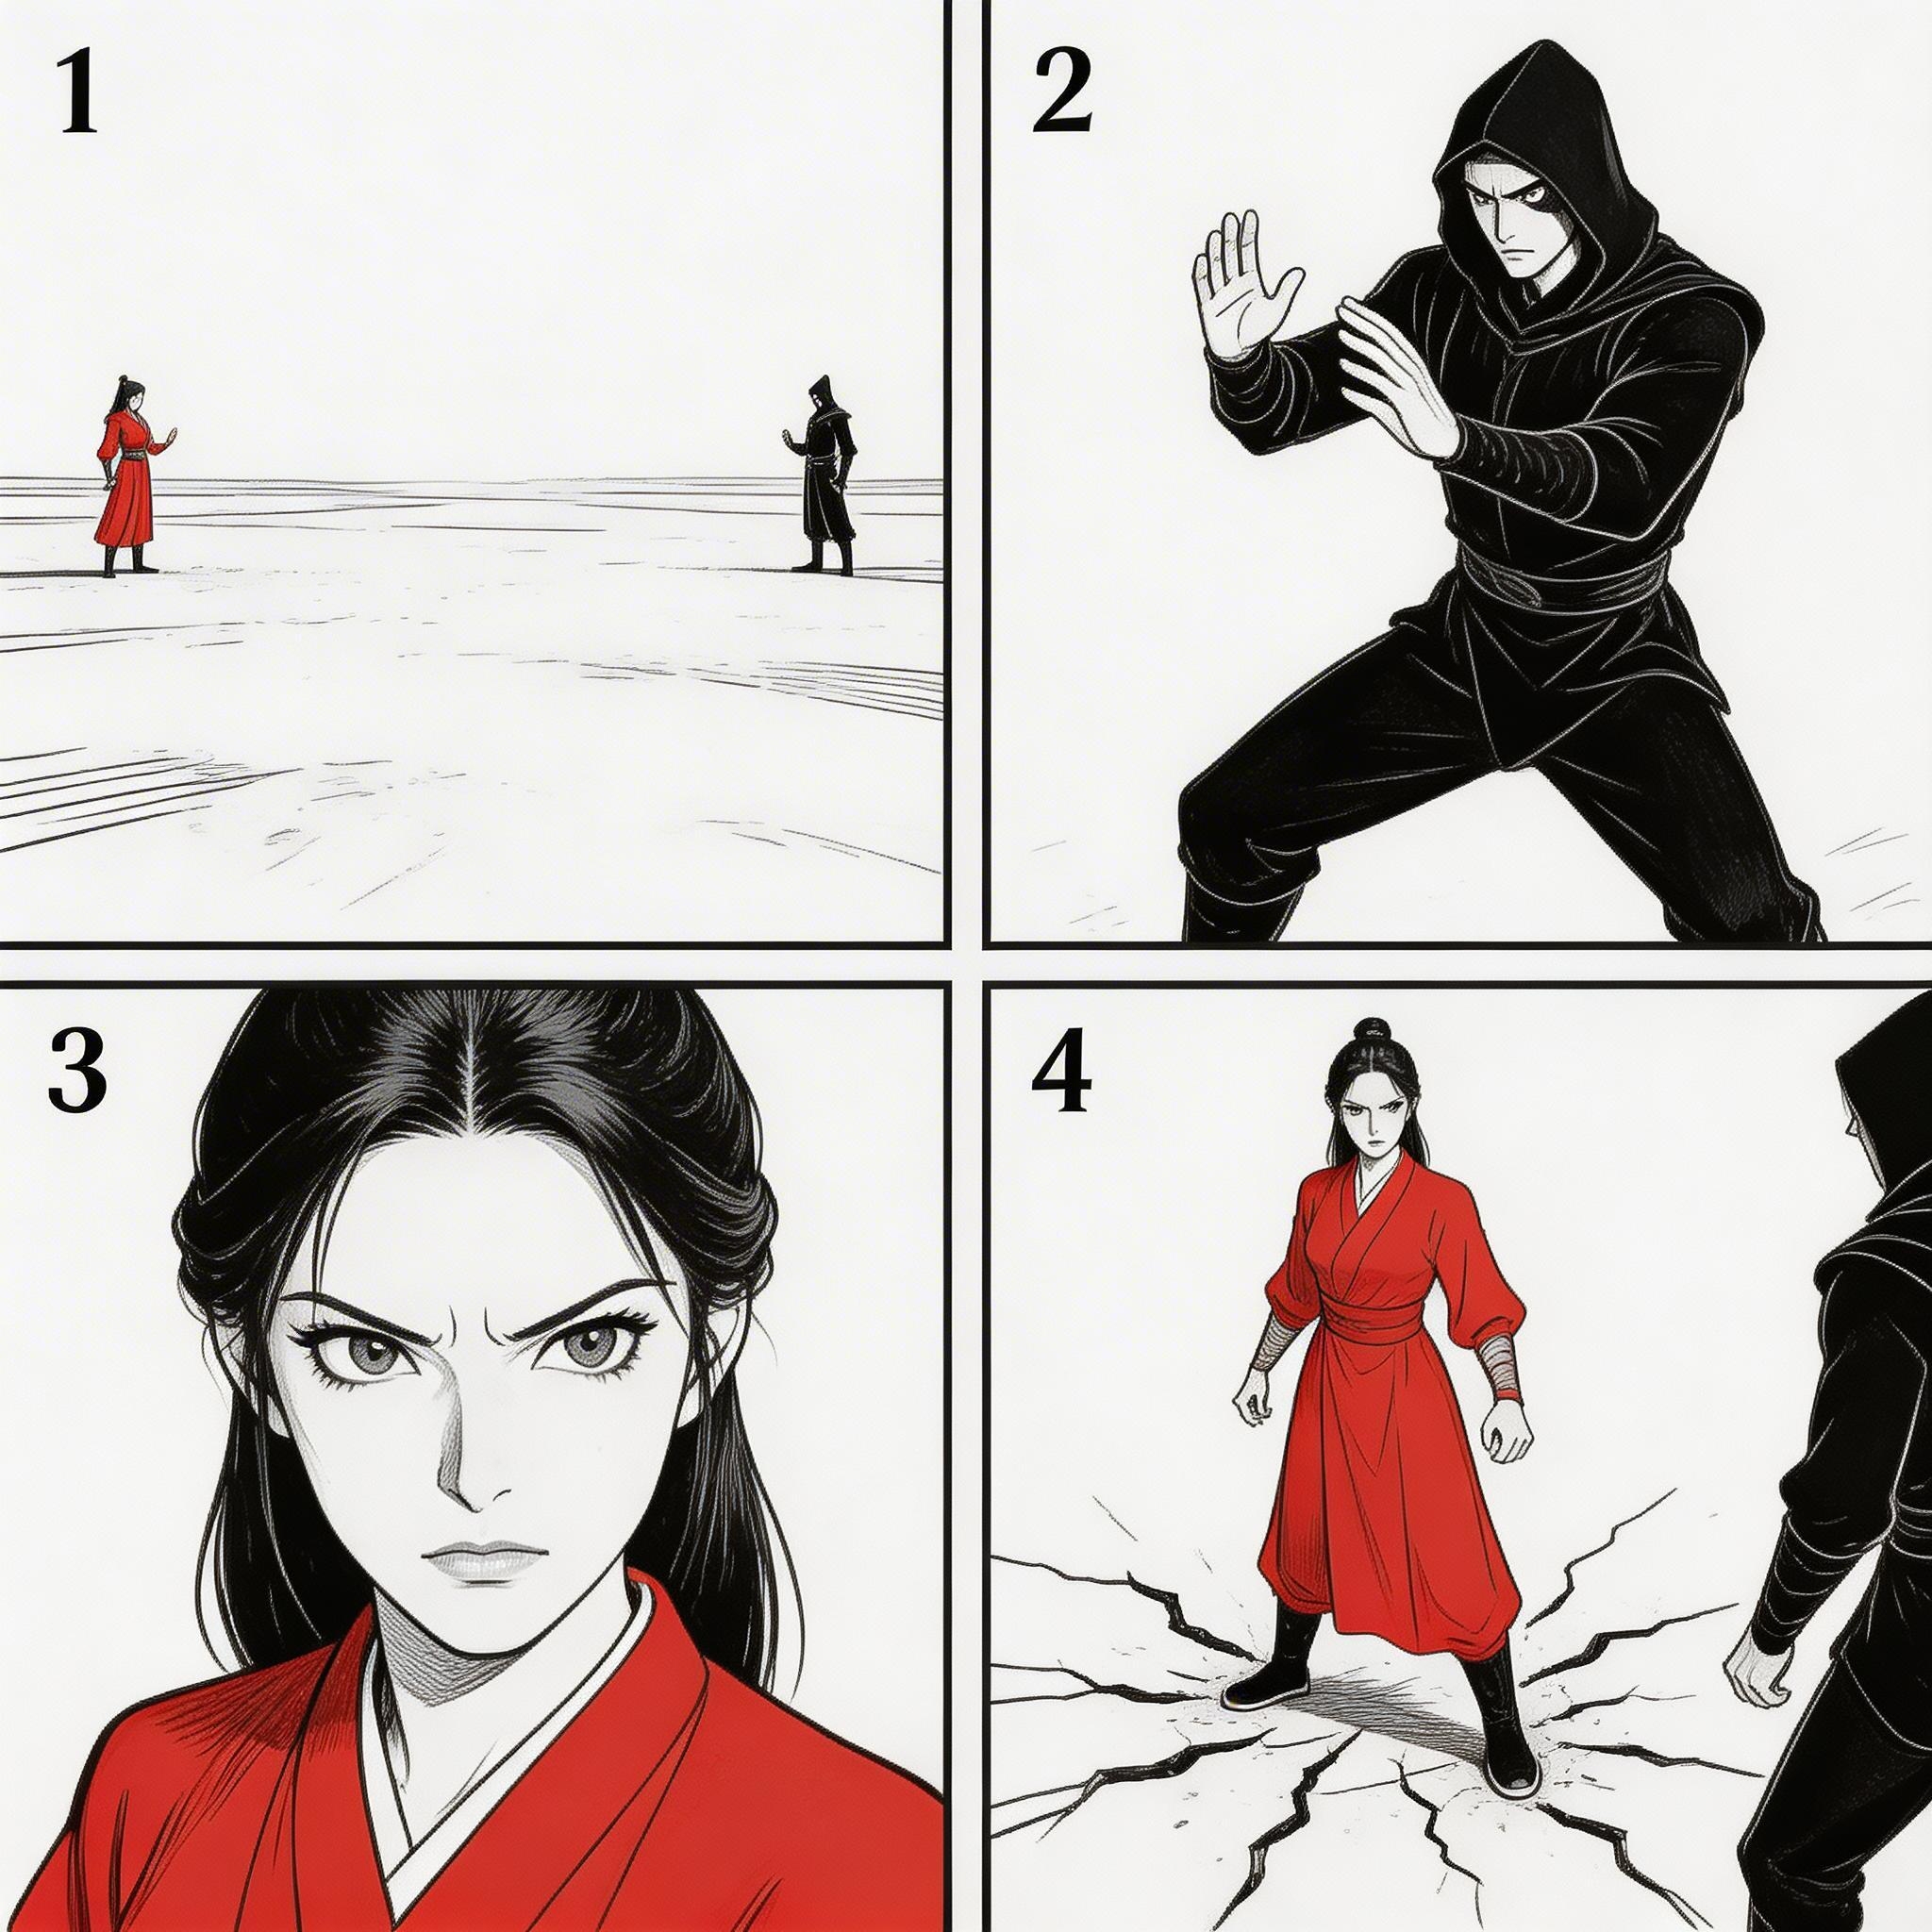
Refer to the sequence in @Image1 to create an intense high-energy fight sequence. All frame compositions from @Image1 shall be presented in strict predefined order, after which the two characters engage in fierce, fast-paced combat.
Referensi
@Image1
Prompt
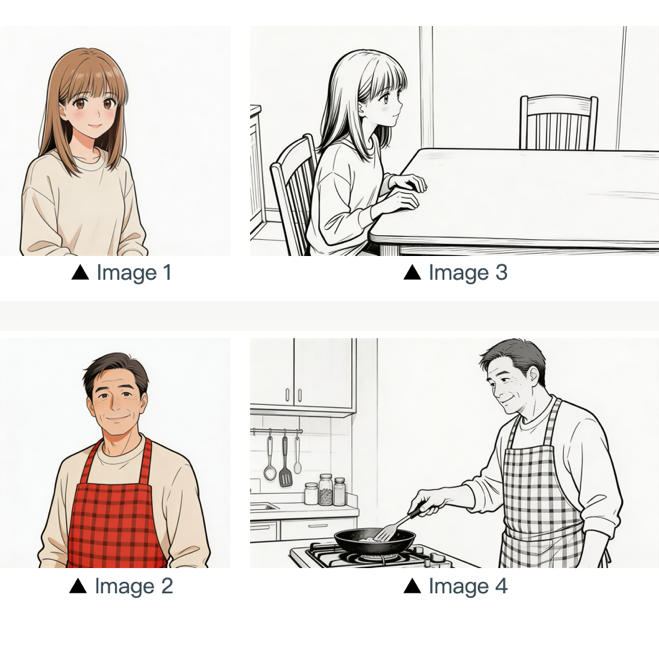
Refer to the composition in Image 3 on @Image1. A girl (her character design refers to Image 1) is waiting for her father to finish cooking, and she says: "아빠, 배고파요! 밥 다 됐어요?" Then the camera pans right and cuts to the frame and composition shown in Image 4. The father (his character design refers to Image 2) replies to her: "거의 다 됐어, 조금만 기다려!" Next, the camera cuts back to a close-up shot of the daughter's slightly disappointed facial expression, and she says: "아직 멀었어요? 맛있는 냄새 나는데..." Then the shot switches to a close-up of the father's face, and he says: "이제 진짜 금방이야. '빨리빨리' 하지 말고 손부터 씻고 와!"
Referensi gerak
Rujuk gerak karakter dan bahasa bidikan di video, lalu terapkan pada karakter di gambar. Contoh pemasaran merujuk bentuk lari kuda di video.
Referensi
@Image1
@Video1
Prompt
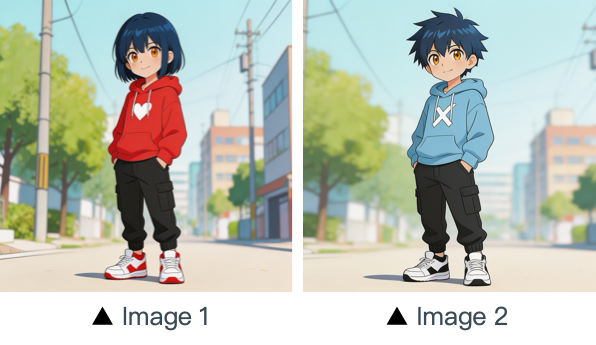
Refer to the character movements and shot language in @Video1 to create a fight scene with the character from Image 2 on @Image1 on the left and the character from Image 1 on @Image1 on the right. Include intense background music.
Referensi
@Video1
Prompt
Referencing the running shape of the horse in @Video1, generate a scene: a golden steed runs on the grassland, then freezes its magnificent running posture and turns into a horse-shaped gold pendant.
Referensi gerak kamera
Rujuk gerak kamera di video, dan namai subjek baru di gambar.
Referensi
@Image1
@Video1
Prompt
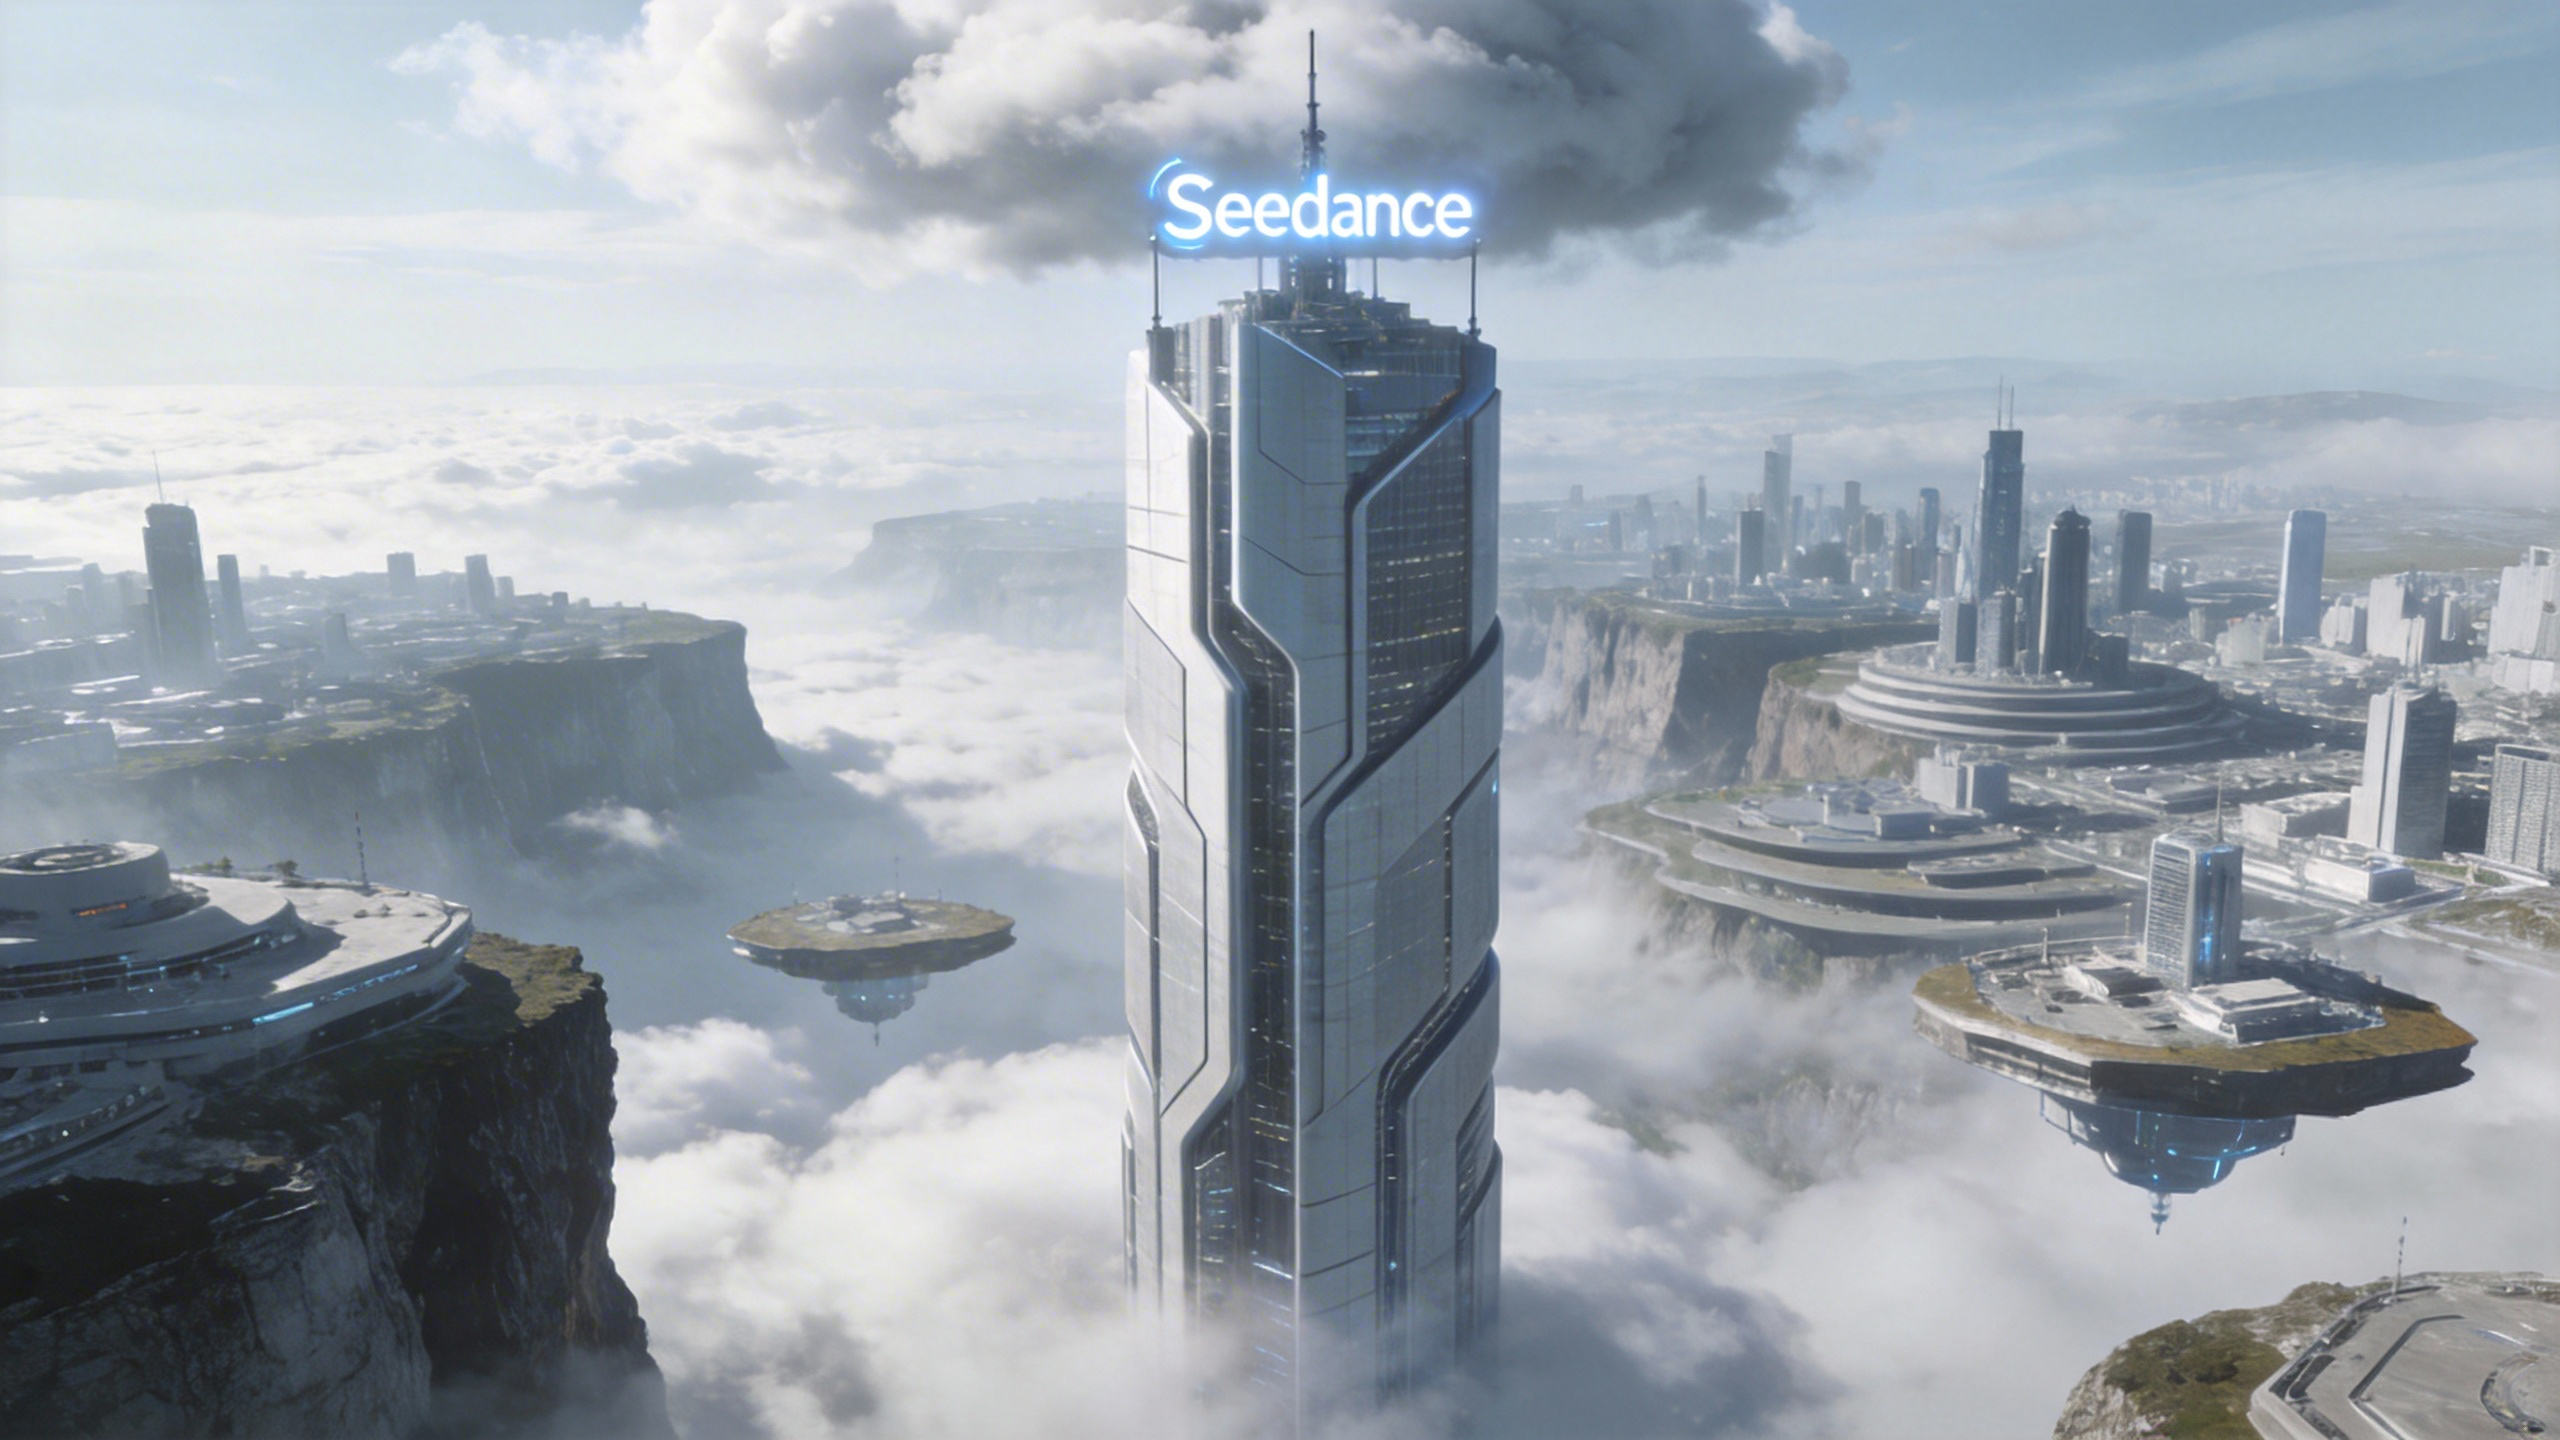
Referring to the camera movement in @Video1, create a concept video for a science and technology park, with the tall building in @Image1 as the visual center, also using a first-person diving perspective, to reflect the sense of technology in the park from @Image1.
Referensi efek khusus
Rujuk efek khusus di video, dan terapkan efek, jalur, serta urutan yang sama itu pada karakter di gambar.
Referensi
@Image1
@Video1
Prompt
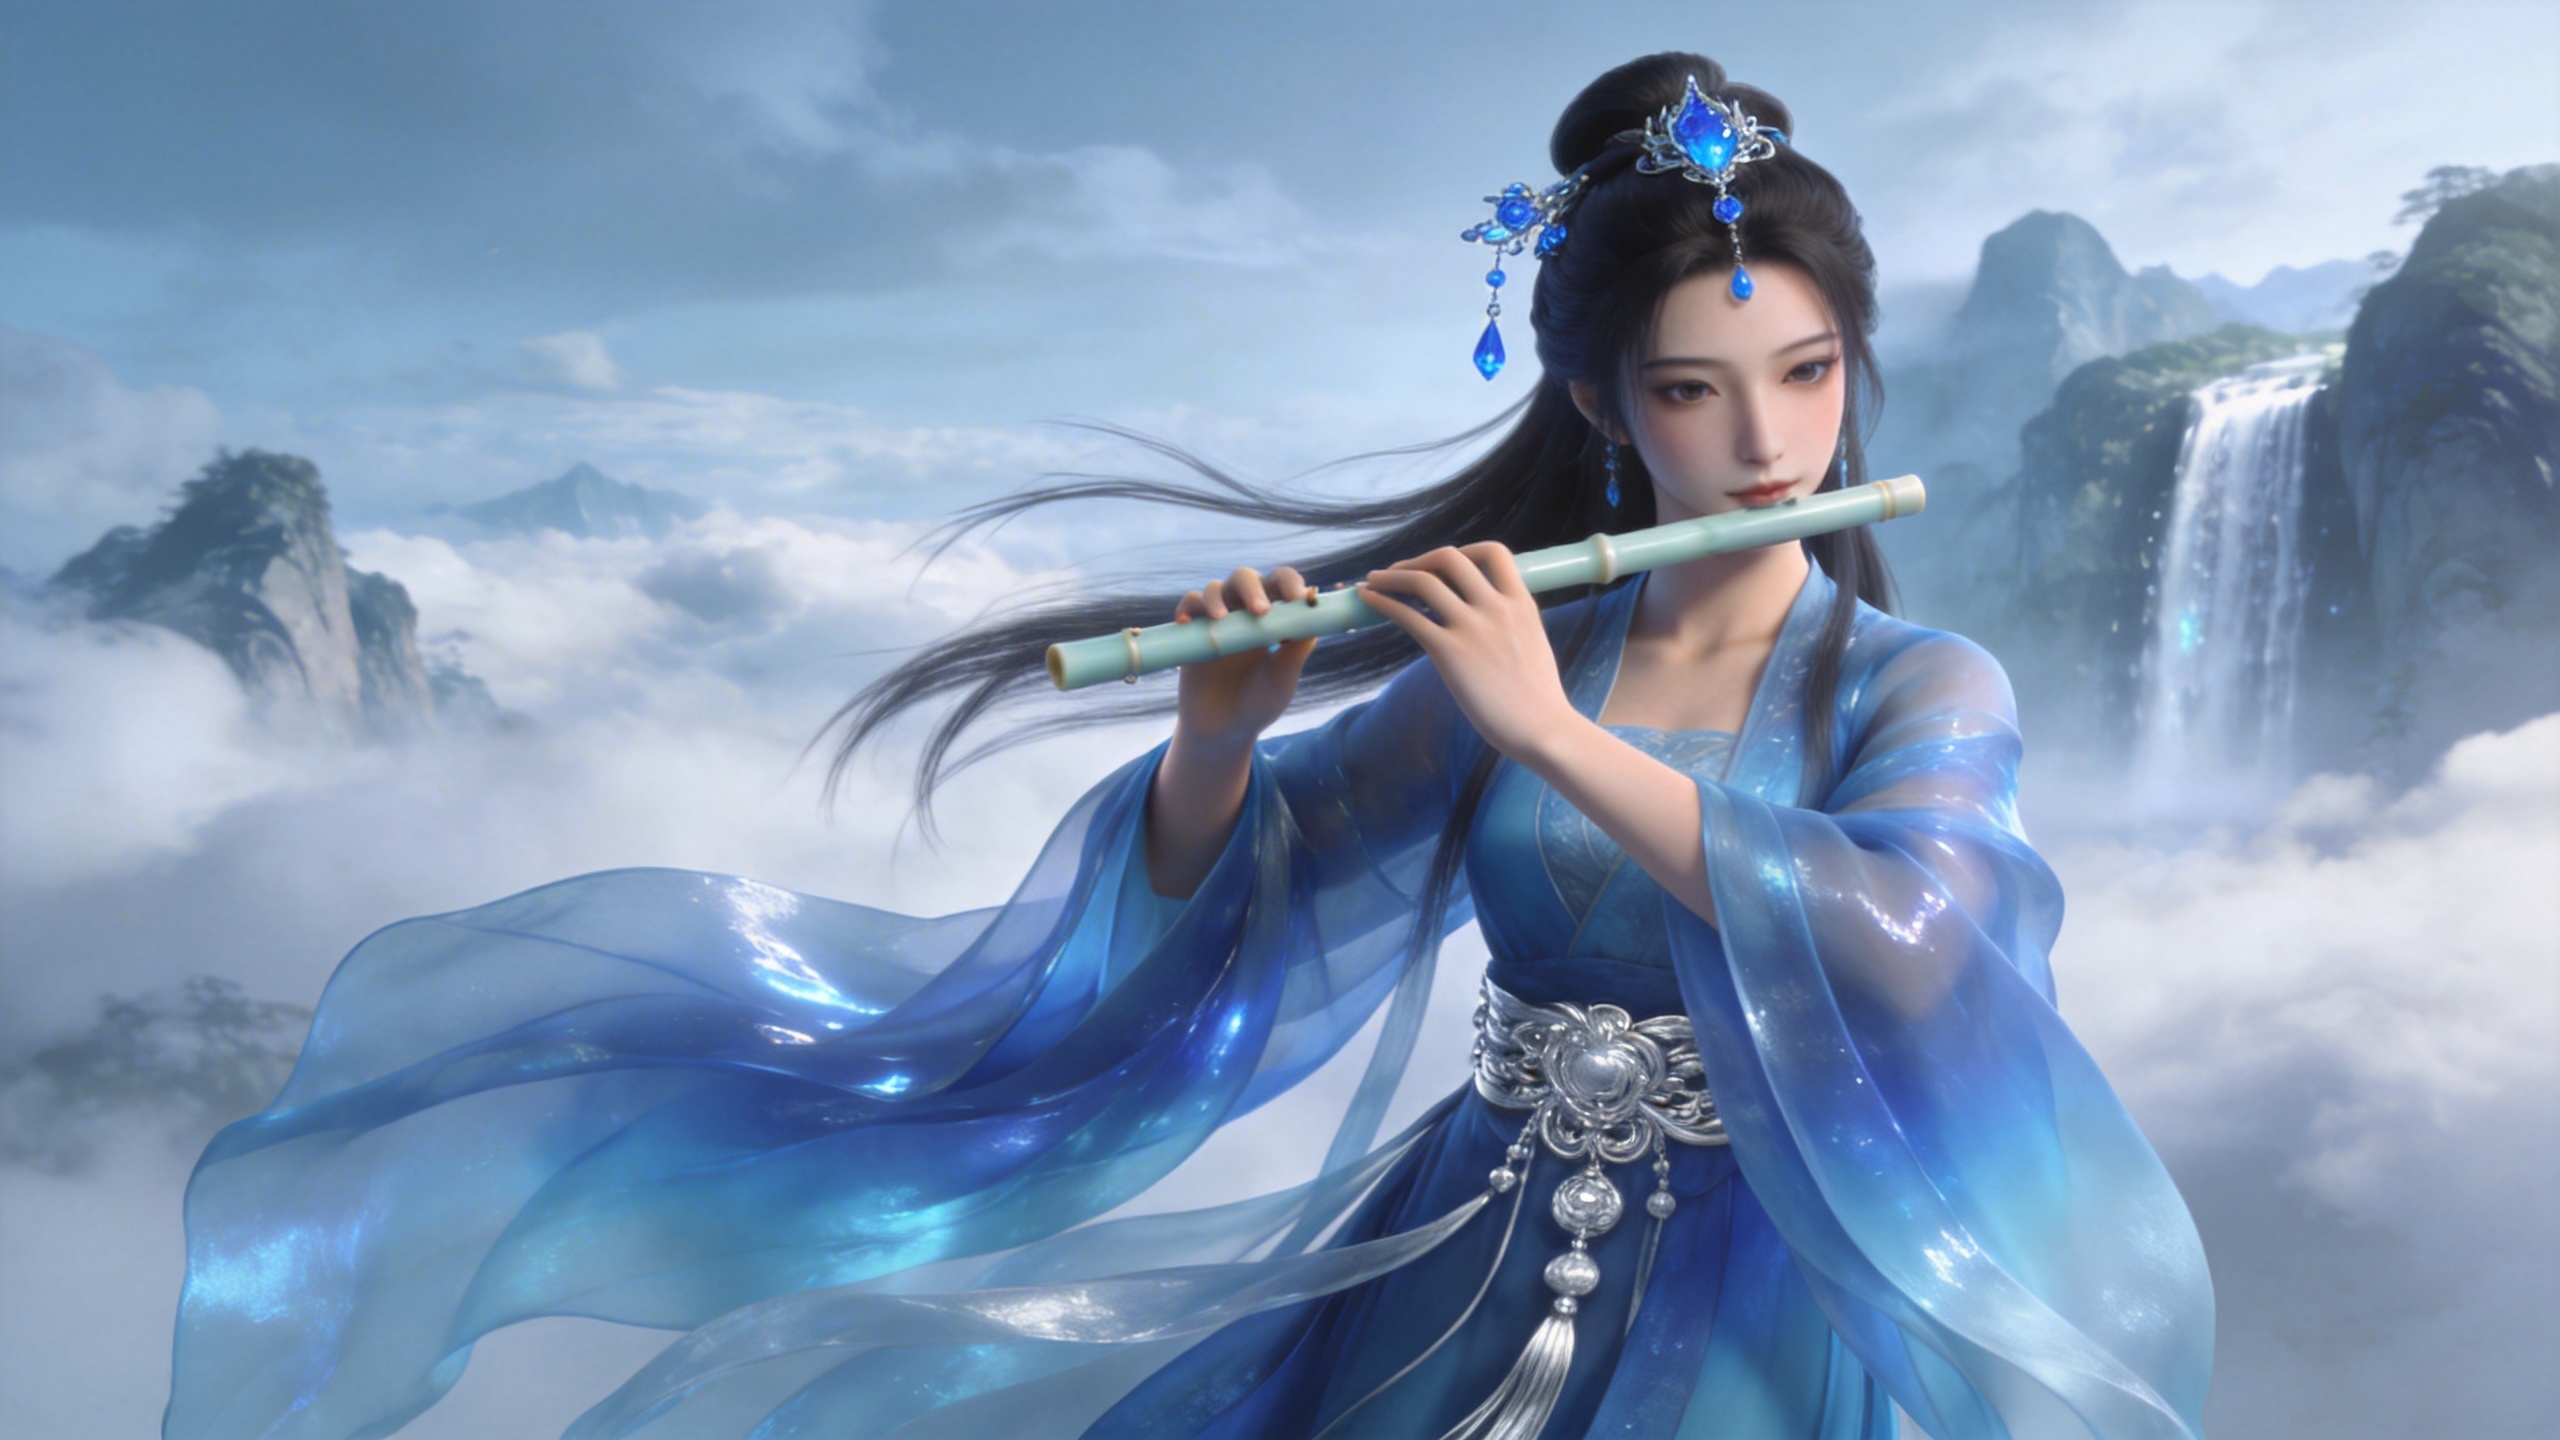
Refer to the golden particle effects in @Video1, so that when the character in @Image1 plays the flute, the same particle effects surround their body.
Referensi
@Image1
@Video1
Prompt
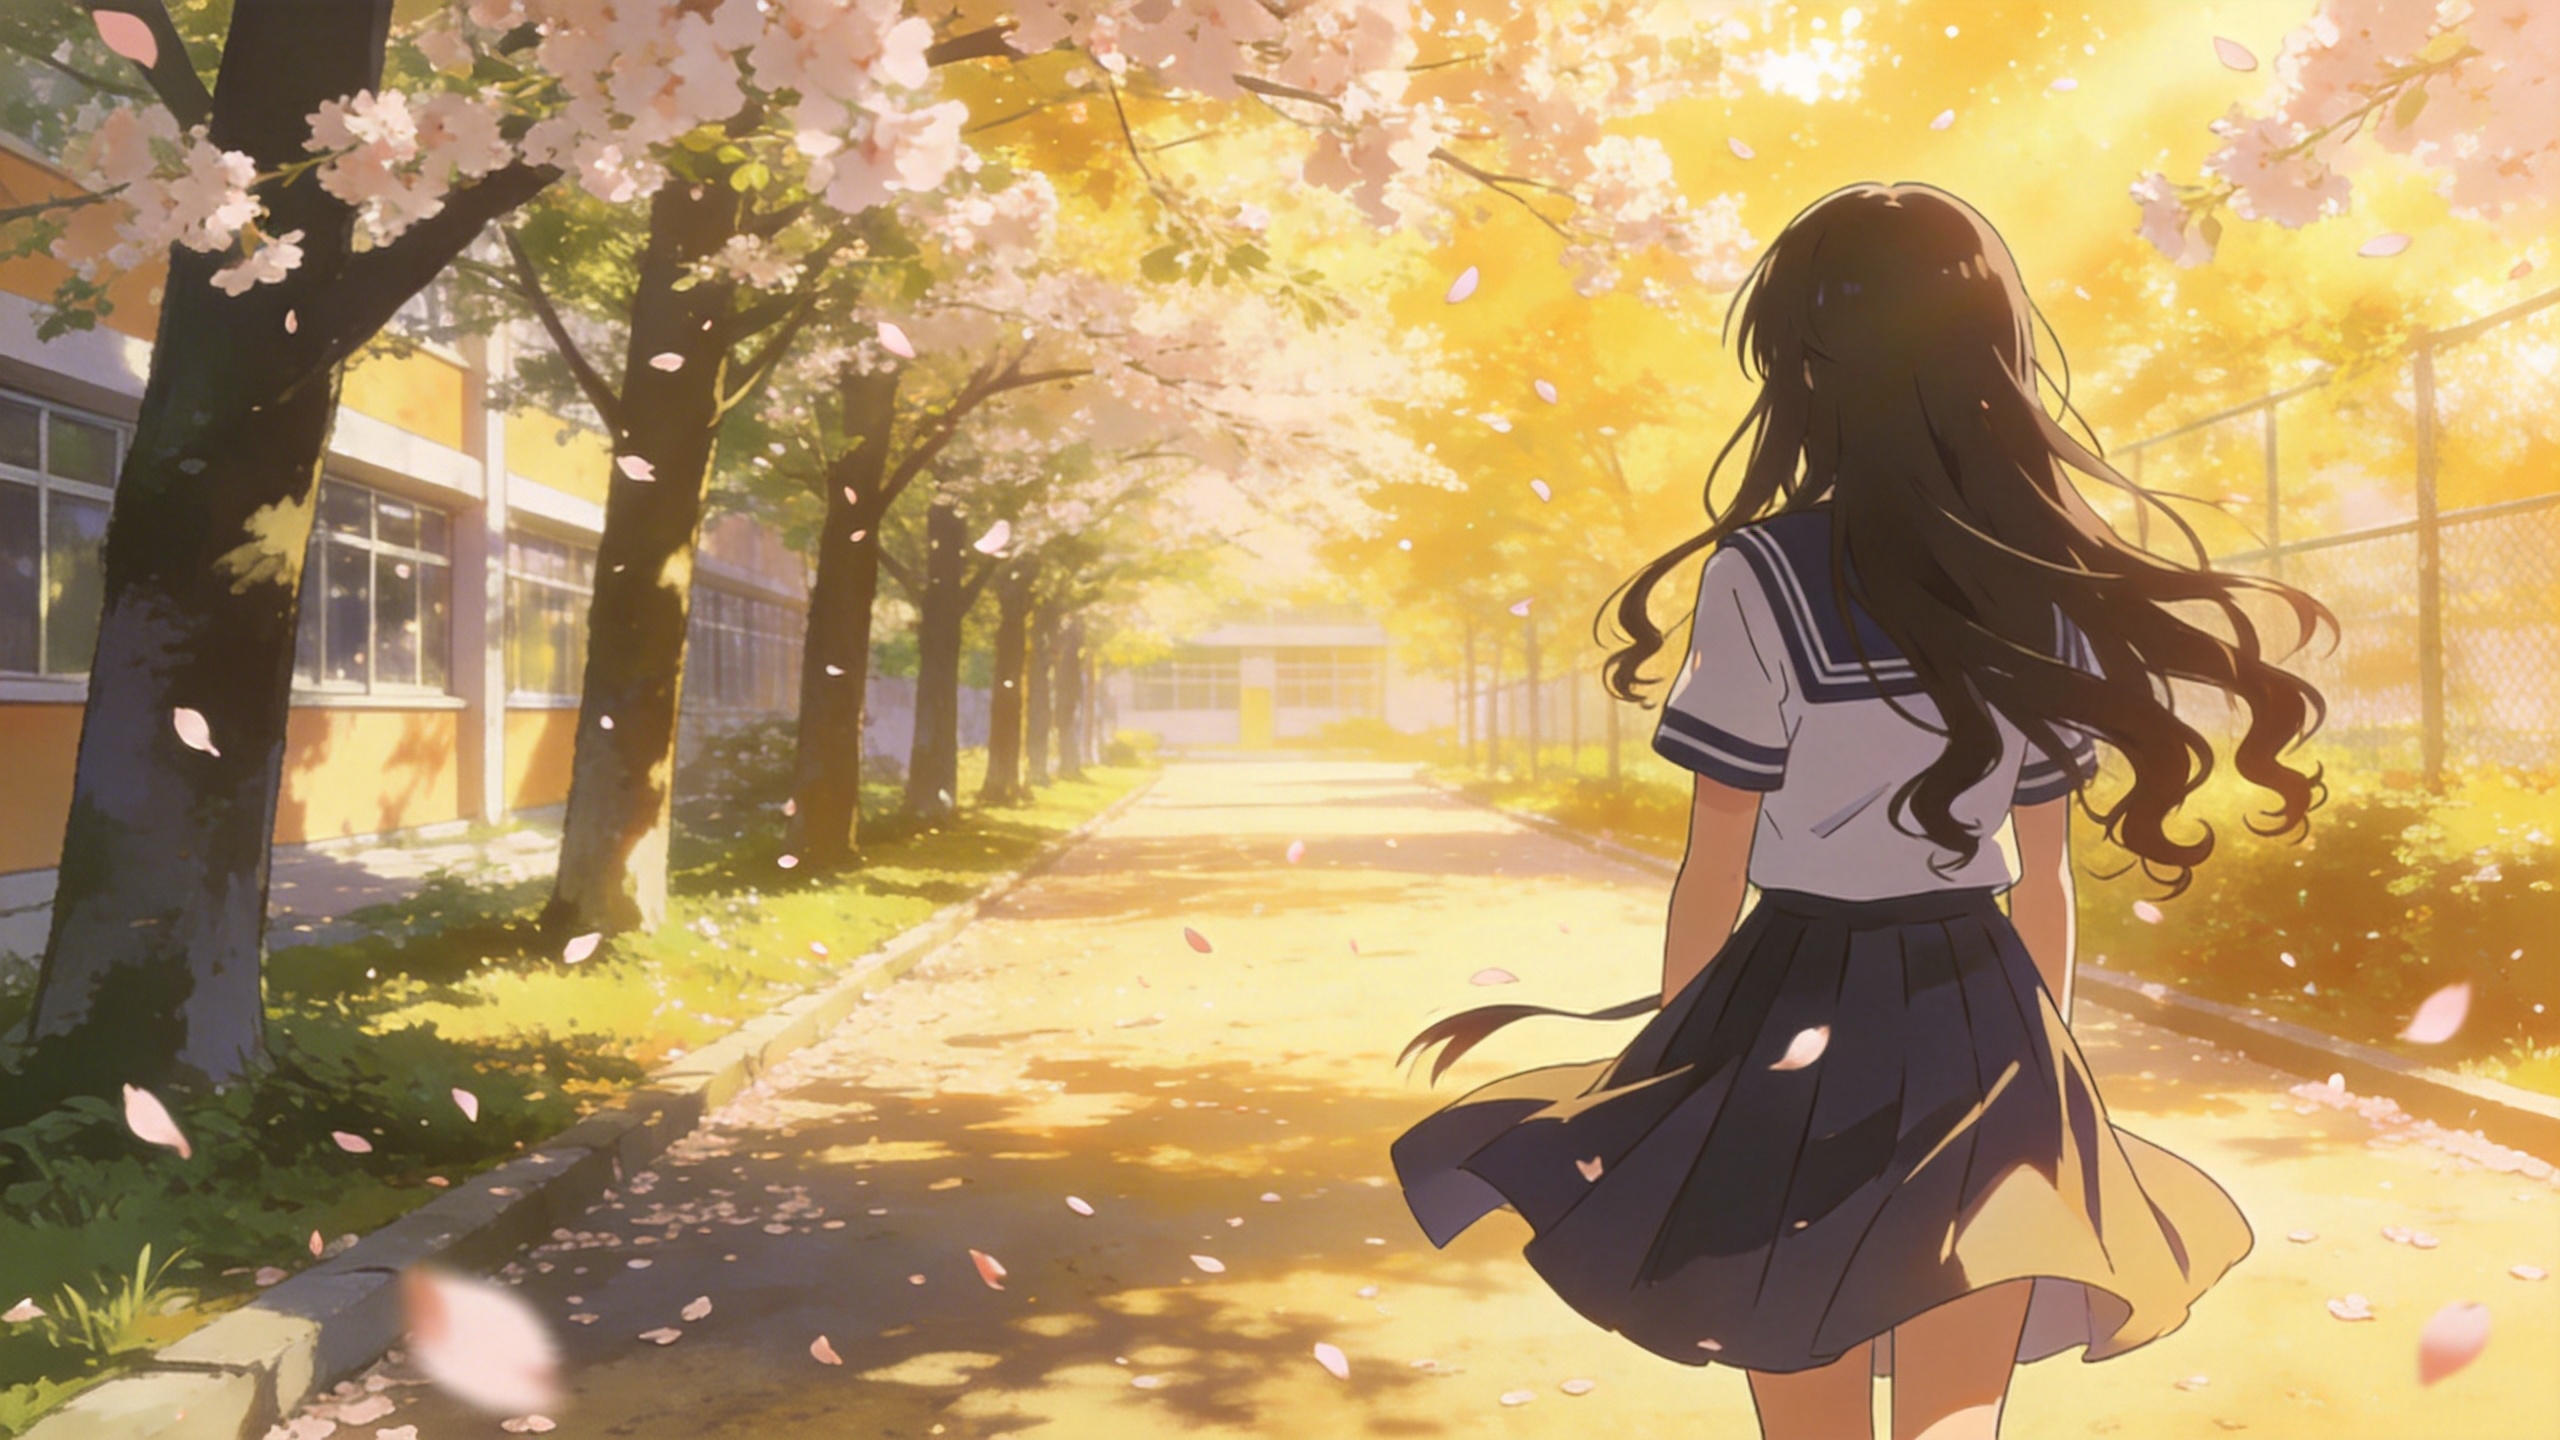
Refer to the special effects shown in @Video1 to generate identical wings for the girl in @Image1, ensuring the wing formation trajectory follows the exact same motion path and sequence depicted in the video.
Menambah, menghapus, atau mengubah elemen
Tambahkan, hapus, atau ganti. Untuk suntingan, jangan menulis "reference". Bagian yang tidak disebut tetap tidak berubah.
Referensi
@Video1
Prompt
Add snacks such as fried chicken and pizza to the countertop in @Video1.
Referensi
@Video1
Prompt
Remove everything that isn't office supplies from the table in @Video1, keeping the rest of the video content unchanged.
Referensi
@Image1
@Video1
Prompt
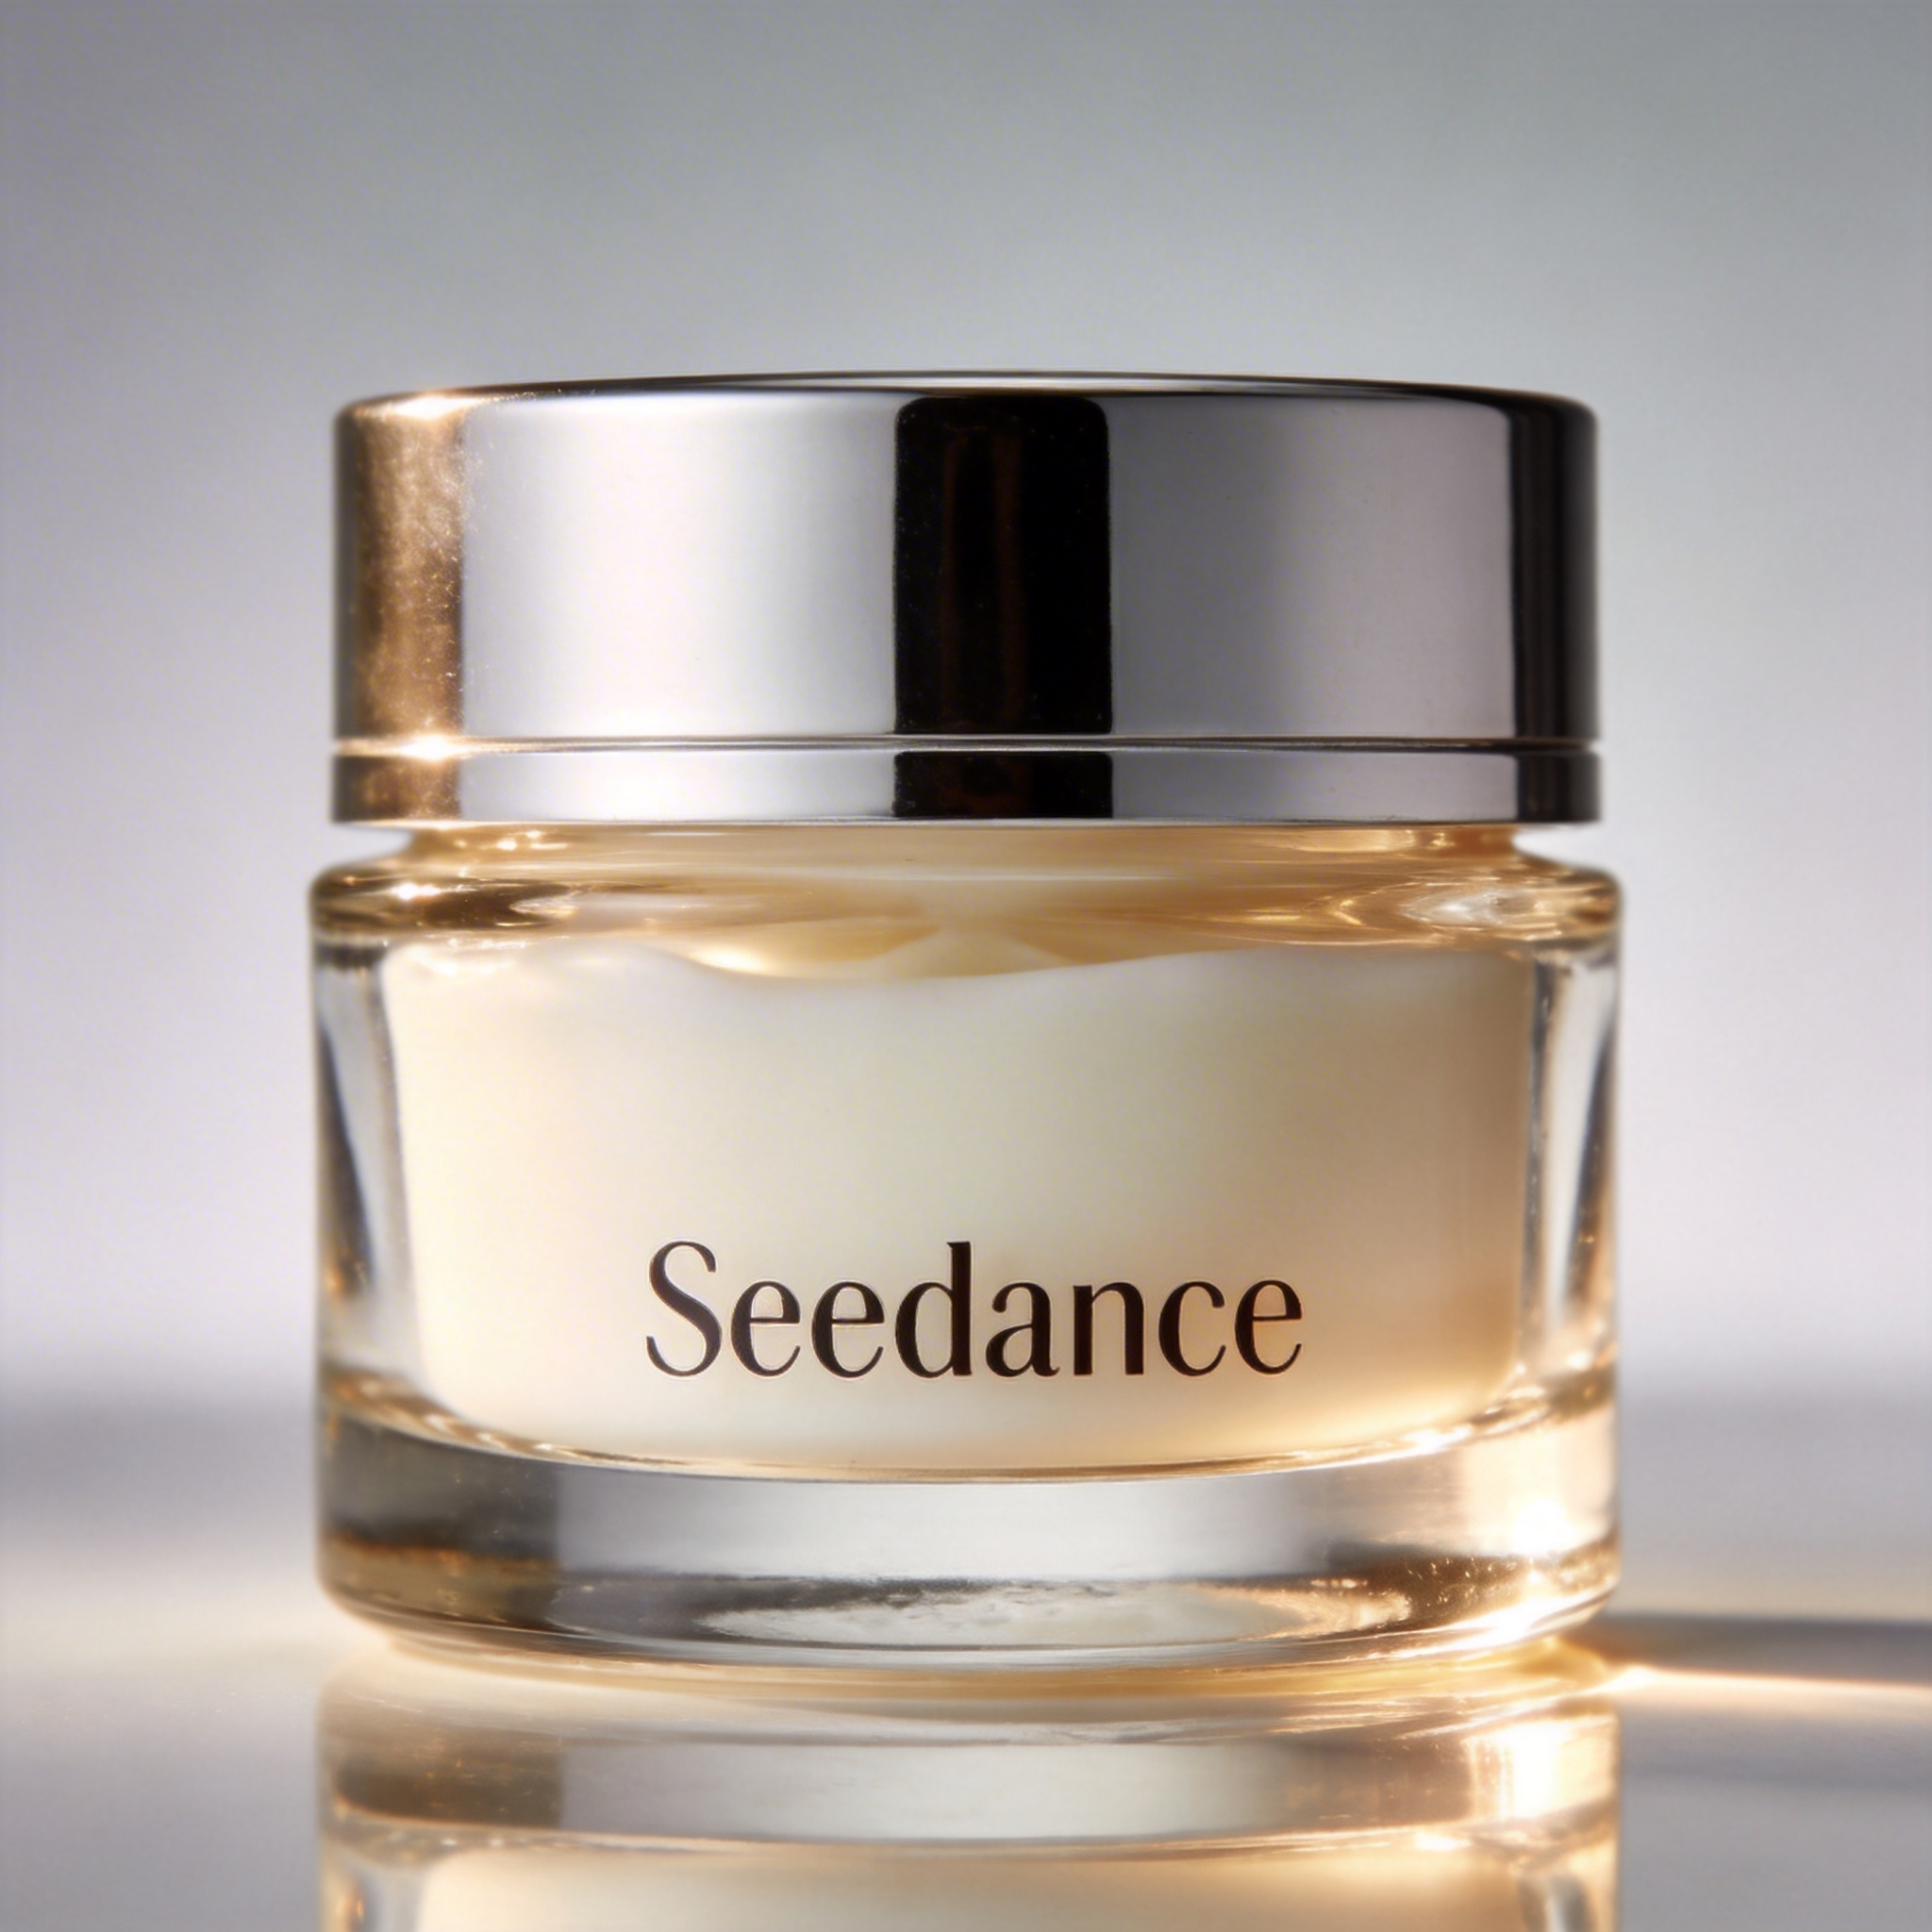
Replace the perfume featured in @Video1 with the face cream from @Image1, with all original motions and camera work preserved.
Memperpanjang video
Perpanjang ke depan menghasilkan isi setelah video. Perpanjang ke belakang memperpanjang segmen pembuka video.
Referensi
@Video1
Prompt
Generate the content after @Video1: the two men who are late run towards them, the five people finally meet and have a friendly chat.
Referensi
@Video1
Prompt
Extend the opening segment of @Video1: Set up an over-the-shoulder shot of the man in a hoodie, and the man says: "It's not that bad. You're just stressed. Everyone goes through this, you just need to keep going."
Menyelesaikan trek
@Video1, lalu jembatan, diikuti @Video2.
Referensi
@Video1
@Video2
Prompt
@Video1. The moment a leaf falls to the ground, it sets off a special effect of golden particles. A gust of wind blows by, leading into @Video2.
Batas dalam sekilas
| Keluarga Seedance 2.0 | |
|---|---|
| Gambar referensi | Hingga 9 |
| Video referensi | Hingga 3, masing-masing 2–15 d, total 15 d |
| Audio referensi | Hingga 3, masing-masing 2–15 d, total 15 d |
| Durasi keluaran | 4–15 d |
| Resolusi keluaran | 2.0: 480p–4K; Fast dan Mini: 480p / 720p |
Video referensi sebaiknya 480p atau 720p pada 24–60 fps.