คู่มือนี้ยึดมาตรฐานอย่างเป็นทางการ แล้วเสริมเนื้อหาเพิ่ม ใช้ได้กับตระกูล Seedance 2.0 (2.0, 2.0 Fast และ 2.0 Mini) พรอมต์ที่ดีจึงทำให้ผลของ Seedance ออกมา
สูตรพื้นฐาน
รุ่นโมเดลชุด Seedance 2.0 รองรับการอ้างอิงแอสเซตหลายสื่อ เช่น วิดีโอ ภาพ และเสียง ในเวลาเดียวกัน โมเดลล็อกคุณลักษณะได้แม่นยำ เช่น รูปลักษณ์ตัวละคร เอฟเฟกต์การกระทำ สไตล์ภาพ และโทนเสียงบรรยาย จึงลดเกณฑ์การเขียนพรอมต์ลงมาก บนฐานนี้ จงนำโมเดลด้วยสูตรพื้นฐานที่เรียบง่าย โดยใช้คุณลักษณะของแอสเซตหลายสื่อเพื่อสร้างวิดีโอที่ตรงตามข้อกำหนดเฉพาะได้เร็ว
การสร้างวิดีโอแบบอ้างอิงแบ่งเป็นงานสามชนิด: การอ้างอิงแบบ omni (omni reference), การแก้ไขวิดีโอ และการขยายวิดีโอ เลือกสูตรพรอมต์พื้นฐานตามชนิดของงาน ทั้งสามชนิดใช้ร่วมกันได้
การอ้างอิงแบบ omni
ดึงองค์ประกอบบางส่วนจากแอสเซต (เช่น ตัวแบบ สไตล์ ฉาก และเอฟเฟกต์เสียง) เพื่อสร้างวิดีโอใหม่ทั้งหมด
สถานการณ์ที่ใช้ได้: การถ่ายโอนการกระทำ, การใช้ตัวแบบซ้ำ, การอ้างอิงบรรยากาศ และงานที่คล้ายกัน
รูปแบบที่แนะนำ:
- อ้างอิงภาพ: อ้างอิงตัวแบบใน
@Image1เพื่อสร้าง… - อ้างอิงวิดีโอ: อ้างอิงการเคลื่อนไหวใน
@Video1เพื่อสร้าง… - อ้างอิงเสียง: อ้างอิงโทนเสียงใน
@Audio1เพื่อสร้าง…
ในสตูดิโอนี้ การอ้างอิงแบบ omni (omni reference) คือ อ้างอิงหลายรายการ พิมพ์ @ ในช่องพรอมต์แล้วเลือกไฟล์ ระบบแทรกเป็น @Image1, @Video1 หรือ @Audio1 โดยเลขตามลำดับการอัปโหลดภายในชนิดนั้น ภาพขนาดย่อแต่ละภาพแสดงโทเคนของตัวเอง ถ้าเอาไฟล์ออก โทเคนที่เหลือของชนิดนั้นจะถูกเรียงเลขใหม่ รูปแบบด้านบนยังต้องบอกว่ากำลังหยิบองค์ประกอบใด โทเคนอย่างเดียวไม่บอกโมเดลว่าต้องการใบหน้า การเคลื่อนไหว สไตล์ หรือโทนเสียง
การแก้ไขวิดีโอ
ทำการเปลี่ยนแปลงบางส่วนหรือทั้งภาพโดยอิงวิดีโอต้นฉบับ ส่วนที่ไม่ได้กล่าวถึงจะคงเดิมเป็นค่าเริ่มต้น
สถานการณ์ที่ใช้ได้: การแทนที่เฉพาะจุด, การเอาตัวแบบออก, การแก้คุณลักษณะ และงานที่คล้ายกัน
รูปแบบที่แนะนำ:
- เพิ่มองค์ประกอบ: อธิบายให้ชัดว่า
@Video1+ องค์ประกอบใหม่ + ตำแหน่งที่อยู่ - แก้องค์ประกอบ: แก้ไข
@Video1อย่างเข้มงวด และเปลี่ยนองค์ประกอบหนึ่งในนั้นเป็นอีกอย่าง - ลบองค์ประกอบ: ระบุองค์ประกอบที่ต้องลบ สำหรับองค์ประกอบที่ควรคงเดิม ให้เน้นในพรอมต์เพื่อผลลัพธ์ที่ดีกว่า
การขยายวิดีโอ
สานวิดีโอต้นฉบับไปตามมิติเวลา โดยกำหนดให้สไตล์ภาพและเสียง ตัวแบบ และเรื่องเล่าคงความสอดคล้อง
สถานการณ์ที่ใช้ได้: การสานเนื้อเรื่อง, การขยายการกระทำ, การทำให้คลิปจบ และงานที่คล้ายกัน
รูปแบบที่แนะนำ:
- ขยายวิดีโอ: ขยาย
@Video1ไปข้างหน้าหรือย้อนกลับเพื่อสร้าง… - เติมแทร็กให้ครบ:
@Video1+ สิ่งที่เกิดขึ้น ตามด้วย@Video2+ สิ่งที่เกิดขึ้นถัดไป
สำหรับงานแก้ไขและขยาย ให้อ้างวิดีโอโดยตรง: "strictly edit @Video1", "extend @Video1 forward" อย่าเขียน "reference @Video1" สำหรับงานเหล่านี้ "Reference" คือรูปแบบการอ้างอิงแบบ omni (omni reference) และโมเดลอาจอ่านการแก้ไขหรือการขยายเป็นคลิปใหม่ทั้งหมด
ภาพเป็นวิดีโอ เป็นโหมดแยก เฟรมแรกและเฟรมสุดท้ายผสมกับไฟล์อ้างอิงในการสร้างครั้งเดียวไม่ได้ เฟรมแรกคือตอนเปิด และอัตราส่วนภาพตามภาพนั้น เปิด เพิ่มเฟรมสุดท้าย เมื่อเฟรมปิดท้ายต้องถูกตรึงด้วย และอธิบายเฉพาะสิ่งที่เกิดขึ้นระหว่างสองเฟรม เปิด ส่งคืนเฟรมสุดท้าย ก่อนสร้าง เมื่อคลิปพร้อม สร้างต่อจากตรงนี้ ใช้เฟรมสุดท้ายนั้นเป็นเฟรมแรกของคลิปถัดไป จึงล็อกจุดต่อไว้กับภาพ นี่คือวิธีของสตูดิโอนี้ที่ล็อกกับเฟรมเพื่อสานต่อ สูตรขยายอย่างเป็นทางการยังใช้ได้เมื่อแหล่งเป็นวิดีโอใน อ้างอิงหลายรายการ
งานรวม
งานสามชนิดด้านบนใช้ร่วมกันได้
สถานการณ์ที่ใช้ได้: อ้างอิงแอสเซตหนึ่งและแก้ไขอีกแอสเซตหนึ่ง
รูปแบบประโยคที่แนะนำ: อ้างอิง [มิติของการอ้างอิง] ของ @Video1 แก้ไข @Video2 อย่างเข้มงวด [การแก้ไขที่เจาะจง]
[มิติของการอ้างอิง] คือสิ่งเดียวที่หยิบจากไฟล์แรก เช่น การเคลื่อนกล้อง เอฟเฟกต์ หรือโทนเสียง [การแก้ไขที่เจาะจง] คือการเปลี่ยนแปลงเดียวที่ต้องการในไฟล์ที่สอง สิ่งที่ไม่ได้ระบุชื่อในการแก้ไขจะคงอยู่
สูตรขั้นสูง
Seedance 2.0 โดยสาระคือผู้กำกับ AI หลายสื่อ: อ่านพรอมต์ข้อความ ภาพ วิดีโอ และเสียงพร้อมกัน แล้วแยกภายในเป็นสองมิติ คือชั้นเชิงพื้นที่ (spatial layer สิ่งที่อยู่ในเฟรม) และชั้นเชิงเวลา (temporal layer สิ่งต่าง ๆ เปลี่ยนไปตามเวลาอย่างไร) เพื่อเข้าใจและสร้างภาพ
พรอมต์ที่ดีไม่ใช่แค่คำบรรยายแนวงานเขียนโฆษณา แต่เป็นคำสั่งแนววิศวกรรม: ใคร ในฉากใด ทำการกระทำใด กล้องเคลื่อนอย่างไร และเหตุการณ์เกิดตามลำดับเวลาใด ถูกส่งไปยังชั้นเชิงพื้นที่ (spatial layer) และชั้นเชิงเวลา (temporal layer) ตามลำดับ
1. กำหนดตัวแบบ
ในแอสเซตอ้างอิงจริง ภาพหนึ่งมักมีหลายตัวแบบ เพื่ออ้างอิงวัตถุหนึ่งในแอสเซตอย่างแม่นยำ ต้องกำหนดตัวแบบให้ชัด ตัวแบบอาจเป็นคน พร็อพ ฉาก และอื่น ๆ
นิยามพื้นฐาน
ข้อกำหนดคุณลักษณะหลัก: ใช้คุณลักษณะนิ่งที่ชัดและเสถียร 2–3 ข้อ (เช่น เสื้อผ้า ทรงผม รูปลักษณ์ หรือหมวด) เพื่อบรรยายตัวแบบและให้ระบุได้ไม่ซ้ำ
ตัวอย่าง:
- กำหนดผู้หญิงชุดแดงและหมวกฟางใน
@Image1เป็น Subject 1 - กำหนดผู้หญิงชุดแดงและหมวกฟางใน
@Image1เป็น Zhang Hong
ตัวแบบเดียวข้ามหลายสื่อ
เมื่อวัตถุในหลายแอสเซตชี้ถึงตัวแบบเดียวกัน ให้ผูกไว้สอดคล้องกัน เขียนว่าใบหน้าใน @Image1 กับภาพเต็มตัวใน @Image2 เป็นคนเดียวกัน
สถานการณ์หลายตัวแบบ
เมื่อมีหลายตัวแบบในวิดีโอ ให้กำหนดแยกกันและแยกด้วยป้าย ป้ายต้องไม่ซ้ำและเสถียร และต้องใช้ป้ายที่ตรงกันอย่างสม่ำเสมอในคำบรรยายถัดไป เพื่อเลี่ยงความกำกวมของการอ้างอิง
ตัวอย่าง: กำหนดชายสูงใน @Video1 เป็นเจ้าหน้าที่ตำรวจ และกำหนดชายเตี้ยอีกคนเป็นขโมย ฉากเป็นตลาดกลางวันที่แออัด มีแสงแดดจ้า แผงผลไม้จำนวนมาก และการสัญจรของคนเดินเท้าหนาแน่น สร้างบรรยากาศตลาดริมถนนที่มีชีวิตชีวา ขโมยวิ่งไปข้างหน้าอย่างตื่นตระหนกผ่านตลาดที่แออัด ขณะที่เจ้าหน้าที่ตำรวจตามติดด้วยความเร็วเต็มที่ ทั้งสองแหวกผ่านแผงอย่างรวดเร็ว กล้องมือถือติดตามไปข้างหน้าอย่างเร็ว พร้อมการสั่นของกล้องแบบสมจริงเล็กน้อย สร้างบรรยากาศการไล่ล่าที่ตึงเครียด
ทุกครั้งที่ตัวแบบมีส่วนร่วม ต้องอ้างถึงอย่างชัดเจน เพื่อไม่ให้ตกหล่น รองรับสองแบบการใช้:
- สำหรับสถานการณ์ง่ายที่ยังไม่กำหนดตัวแบบ ทุกครั้งที่กล่าวถึงตัวแบบ ให้ใช้ @ เพื่อเน้นการผูกตัวแบบกับแอสเซต ตัวอย่าง: Zhang San
@Image1 - สำหรับสถานการณ์ที่กำหนดตัวแบบไว้ก่อนแล้ว ทุกครั้งที่กล่าวถึงตัวแบบ ให้ใช้ป้ายเดิม หลังจากกำหนดชายสูงใน
@Video1เป็นเจ้าหน้าที่ตำรวจและชายเตี้ยเป็นขโมย ประโยคถัดไปพูดว่าเจ้าหน้าที่ตำรวจและขโมย ไม่ใช่ "the tall one" และ "the other man"
เมื่อใช้รหัสจากคลังแอสเซต ยังต้องมี @Image1 หรือ @Video1 เพื่ออ้างตัวแบบ โมเดลเชื่อมรหัสแอสเซตกับเนื้อหาอ้างอิงโดยตรงไม่ได้ จึงห้ามใช้รหัสแอสเซตแทนโทเคนไฟล์
ให้คำบรรยายสั้นที่สุดเท่าที่ทำได้ เลี่ยงความซ้ำซ้อน และเลี่ยงความขัดแย้งทางความหมาย เช่น คุณลักษณะที่ขัดกันของตัวแบบเดียวกัน แสดงความสัมพันธ์เชิงพื้นที่ผ่านภาพอ้างอิงก่อน เพื่อลดคำบรรยายข้อความที่ซับซ้อน
สำหรับคน คนหนึ่ง ภาพโคลสอัปใบหน้าบวกภาพเต็มตัวก็พอ ภาพตัวละครแบบ multi-view ไม่แนะนำที่นี่ เพราะแผ่น turnaround เป็นสาเหตุที่พบบ่อยของ ID drift
2. ลำดับช็อต
การจำลองภายในของโมเดลแยกพื้นที่กับเวลา ดังนั้นรูปแบบพรอมต์ที่เหมาะสำหรับวิดีโอซับซ้อนคือสตอรีบอร์ดตามไทม์ไลน์: แบ่งวิดีโอเป็นหลายช็อต แล้วบรรยายแต่ละช็อตแบบพลวัตตามลำดับที่เหตุการณ์เกิด: ใคร + ที่ไหน + ทำอะไร + กล้องเคลื่อนอย่างไร
ใช้ลำดับช็อต เขียนสตอรีบอร์ดง่าย ๆ Shot 1 / Shot 2 / Shot 3 สำหรับแต่ละช่วงของวิดีโอ แล้วรวมเป็นพรอมต์ที่สมบูรณ์
ตัวอย่างเชิงลบ: "A man runs nervously down the street, and the scene feels very cinematic."
ตัวอย่างเชิงบวก:
- Shot 1: ช็อตด้านข้างของซอยถนน ชายเริ่มวิ่งช้า ๆ พร้อมความรู้สึกหายใจถี่
- Shot 2: ชายชนแผงผลไม้ล้ม กล้องสั่นเร็วและให้โคลสอัปใบหน้าที่ตกใจของชาย
- Shot 3: ชายปีนข้ามกำแพงต่ำแล้วหายไป กล้องถอยช้า ๆ แล้วค้างอยู่ที่ถนนว่าง
ใช้ตัวระบุเช่น Shot 1, Shot 2 และ Shot 3 เพื่อจัดเนื้อหาตามลำดับเหตุการณ์ สิ่งหลักก่อน สิ่งรองทีหลัง อย่ากำหนดขีดจำกัดเข้มงวดต่อความยาวของแต่ละช่วง ให้ความสำคัญให้โมเดลสร้างจังหวะตามเนื้อเรื่องอย่างเป็นธรรมชาติ การรองรับจังหวะเวลาที่แม่นยำของโมเดล เช่น 0–3 วินาที ไม่เสถียร และการบังคับจำกัดความยาวอาจทำให้ผลลัพธ์การสร้างผิดปกติ
จัดแต่ละช็อตตามลำดับนี้:
- การเคลื่อนกล้องหรือวิธีเปลี่ยนช็อต เช่น "slowly push in from a wide shot", "fixed camera position", "cut to…"
- การกระทำและสีหน้าของตัวแบบ บรรยายการกระทำสำคัญและการเปลี่ยนสีหน้าของตัวละครหรือวัตถุหลัก
- ตำแหน่งหรือการเปลี่ยนเชิงพื้นที่ อธิบายฉาก ตำแหน่ง หรือความสัมพันธ์เชิงพื้นที่ที่ตัวแบบอยู่
- ข้อมูลเสียง บรรยายเอฟเฟกต์เสียง เสียงพูด และดนตรีประกอบที่ตรงกับช็อต
3. ข้อกำหนดการบรรยายการกระทำ
การเกลาการเคลื่อนไหวของร่างกาย + การกำหนดระดับ การกระทำควรเจาะจงส่วนร่างกาย เช่น มือ ขา ศีรษะ ไหล่ และหลัง พร้อมเติมคำบรรยายช่วง ความเร็ว และแรง ตัวอย่าง: ยกมือช้า ๆ หันศีรษะเร็ว ดันตัวออกจากพื้นแรง ๆ ก้มศีรษะเล็กน้อย
ให้ความสำคัญกับการเคลื่อนไหวเล็กที่ช้า นุ่ม และต่อเนื่อง ให้ความสำคัญกับการเคลื่อนไหวละเอียดที่ช้า นุ่ม และเชื่อมกัน และพยายามเลี่ยงการกระทำที่ระเบิดสูงและไดนามิกมาก เช่น การวิ่งเร็ว การกระโดดใหญ่ และการกลิ้งรุนแรง ตัวอย่าง: เดินช้า ๆ ยกมือเบา ๆ ก้มศีรษะเล็กน้อย นั่งลงอย่างเป็นธรรมชาติตามการเคลื่อนไหว
เติมช่วงเปลี่ยนระหว่างการกระทำ ระบุแรงเฉื่อยและความต่อเนื่องระหว่างการกระทำก่อนหน้ากับถัดไป เพื่อให้การเคลื่อนบนจอเชื่อมกันและเป็นธรรมชาติ ตัวอย่าง: ใช้แรงเฉื่อยของการหันตัวเพื่อยกมืออย่างเป็นธรรมชาติ เปลี่ยนจากช่วงหยุดไปสู่การยกมืออย่างเป็นธรรมชาติ
การแสดงอารมณ์ภายนอกที่เป็นรูปธรรม ใช้รายละเอียดทางกายที่เฉพาะเพื่อแสดงอารมณ์ แทนคำนามธรรมเช่น "very sad" และ "extremely angry."
| อารมณ์นามธรรม | แสดงออกเป็นการกระทำและรายละเอียด |
|---|---|
| ความเศร้า | ก้มศีรษะ ไหล่สั่นเล็กน้อย ตาแดง นิ้วกำขอบเสื้อผ้าโดยไม่รู้ตัว น้ำตาเอ่อในตาแต่ไม่ไหล |
| ความยินดี | มุมปากยกขึ้นโดยควบคุมไม่ได้ คิ้วและตาคลาย ฝีเท้าเบา ฮัมเพลงโดยไม่รู้ตัว ห้ามใจไม่ให้หมุนอยู่กับที่ไม่ได้ |
| ความประหม่า / ความกังวล | มองนาฬิกาบ่อย นิ้วเคาะหน้าโต๊ะตลอด หายใจเร็ว สายตาหลบ กัดเล็บโดยไม่รู้ตัว |
| ความโกรธ | กำหมัดทั้งสองข้าง แนวขากรรไกรตึง หน้าอกกระเพื่อมแรง ตาคมดั่งมีด บีบคำออกจากซอกฟันที่กัดแน่น |
| ความโล่งใจ | ถอนหายใจยาว ไหล่ที่ตึงคลายหมด รอยยิ้มจางที่หายไปนานปรากฏบนใบหน้า เงยมองไปไกล |
4. พรอมต์การเคลื่อนกล้อง
โมเดลเข้าใจคำศัพท์การเคลื่อนกล้องได้ดี จึงใช้ศัพท์มาตรฐานได้ตรง ๆ เช่น "medium shot, close-up, wide shot, slow push-in, smooth lateral tracking, fixed shot."
พยายามระบุการเคลื่อนกล้องเพียง 1 ชนิดในช็อตเดียว อย่าเรียกร้อง push, pull, pan และ move พร้อมกัน เพราะจะเพิ่มความไม่เสถียรของภาพ
5. คุณภาพภาพ สไตล์ และคำจำกัด
คุณภาพภาพ สไตล์ และคำจำกัดคือกุญแจควบคุมผลลัพธ์การสร้างวิดีโอ สิ่งเหล่านี้กำหนดขอบเขตสร้างสรรค์ให้โมเดล รวมคุณภาพภาพและโทนศิลป์ และเลี่ยงตำหนิทางภาพกับความเบี่ยงแบบสุ่ม จึงเป็นการตั้งค่าที่จำเป็นเพื่อให้ผลลัพธ์สุดท้ายเสถียรและตรงตามข้อกำหนด
- คุณภาพภาพ กำหนดความคมของภาพ พื้นผิวที่ละเอียด และคุณภาพแสง เพื่อยกคุณภาพภาพพื้นฐานของวิดีโอสุดท้าย ตัวอย่าง: HD, รายละเอียดแน่น, พื้นผิวแบบภาพยนตร์, สีธรรมชาติ, แสงนุ่ม
- สไตล์ ตั้งสไตล์ศิลป์โดยรวมและโทนภาพ เพื่อรวมบรรยากาศศิลป์ของภาพ ตัวอย่าง: โทนไซเบอร์พังก์เย็นน้ำเงินม่วง, ฟิล์มย้อนยุค, สไตล์ญี่ปุ่นสดใส
- คำจำกัด คำจำกัดสำคัญมาก สามารถเลี่ยงตำหนิทางภาพ ความผิดรูป การพัง และองค์ประกอบที่ไม่สมเหตุสมผลได้อย่างมีประสิทธิผล และจำกัดขอบเขตการสร้างกับความเสถียร
แม่แบบคำจำกัดที่ใช้บ่อย:
- เลี่ยงการสร้างคำบรรยาย: "keep it subtitle-free", "avoid generating any text or subtitles"
- เลี่ยงการสร้างโลโก้: "do not generate a logo"
- เลี่ยงการสร้างลายน้ำ: "do not generate a watermark"
6. กรณี
สองตัวอย่างนี้แสดงวิธีใช้สูตรขั้นสูงด้านบน บทพูดคงอยู่ใน {} ซึ่งเป็นเครื่องหมายบทสนทนาจากมาตรฐานอักขระพิเศษ
ตัวอย่าง 1: ละครสั้นอารมณ์ในหอพัก (เน้นบทสนทนา)
การเตรียมแอสเซต:
@Image1: ภาพครึ่งตัวของนางเอก@Image2: ภาพอ้างอิงฉากหอพัก@Video1: อ้างอิงการเคลื่อนกล้องสำหรับบทสนทนาในอาคาร (dolly in/out ช็อตกลาง หรือ pan เล็กน้อย)@Audio1: เสียงแวดล้อมในอาคารหรือเพลงเบา
Use the girl in @Image1 as the main character, use @Image2 as the dormitory scene style reference, and refer to the camera movement in @Video1.

Shot 1: At dusk, girl @Image1 walks briskly to the dormitory entrance @Image2. The camera follows steadily in a medium shot. Warm yellow sunlight spills into the hallway from the window. She pauses at the doorway, takes a deep breath, and looks slightly nervous.

Shot 2: Girl @Image1 pushes the door open and enters the dormitory. The camera cuts to an indoor medium shot. Her roommates look up at her while organizing their books. One of them smiles and asks {How did the exam go? Did you pass?}. The camera slowly cuts between half-body close-ups of several people.

Shot 3: Girl @Image1 first lowers her head with a dejected expression. The camera gives her a close-up. Then she raises her head, unable to hold back a smile, laughs out loud, and says {I was kidding}. Her roommates start chasing and play-fighting with her. The camera slowly pulls back and freezes on a wide shot of the dormitory filled with laughter.

The entire video should have a high-definition cinematic documentary style, with warm tones and soft lighting. The character's face remains stable without deformation; movements are natural and smooth, with no stutter or flicker. The ambient sound blends naturally with @Audio1.
ตัวอย่าง 2: การเผชิญหน้าบนหน้าผาสไตล์โบราณ (เน้นการกระทำ/บรรยากาศ)
การเตรียมแอสเซต:
@Image1: นางเอกชุดแดง@Image2: มือสังหารชุดดำ (คู่ต่อสู้)@Image3: ภาพฉากหน้าผาและป่าไผ่@Video1: อ้างอิงการเคลื่อนกล้องสำหรับการเผชิญหน้าศิลปะการต่อสู้@Audio1: จังหวะกลองแน่นหรือเอฟเฟกต์เสียงการต่อสู้
Use the woman in red from @Image1 as the female lead, use the woman in black from @Image2 as the opponent, use the cliff and bamboo forest environment in @Image3 as the scene reference, refer to the overall camera movement and action rhythm in @Video1, and synchronize the background sound effects with @Audio1.

Shot 1: At dusk, the camera slowly pushes in from a side medium shot of woman in red @Image1. She stands at the edge of the cliff and lifts a wine flask to drink. Her sleeves and robe hem sway gently in the mountain wind. The camera circles halfway around her, moving from the front to her back. In the distance, a figure in black is faintly visible in the bamboo forest.

Shot 2: The camera zooms and fades into a long shot. From a drone perspective, it overlooks the entire cliff and bamboo forest. The two characters stand at opposite ends of the cliff. The mountain wind lifts their robe hems and dust, and the rhythm slightly accelerates with the drum beats.

Shot 3: The camera cuts back to a ground-level close shot. The two slowly draw their swords and face off. Woman in red @Image1 shifts from a careless expression to a cold gaze. Woman in black @Image2 looks determined, and the sword tip trembles slightly. The camera steadily follows the two as they circle each other, finally freezing on a close-up of the instant before the two swords meet.

The overall visual style should feel like a cinematic wuxia world in misty rain, with cool tones, low saturation, a film-grain texture, and rich light-and-shadow layers. The characters' faces and body proportions remain stable without deformation. Movements are continuous and natural, not stiff, with no clipping or stutter.
เคล็ดอื่น ๆ
การสร้างข้อความ
โมเดลชุด Seedance 2.0 รองรับการสร้างข้อความทั่วไป โมเดลจับคู่สไตล์และสีที่เหมาะสมอัตโนมัติตามบริบท และรองรับการระบุสี สไตล์ วิธีปรากฏ จังหวะปรากฏ และตำแหน่งปรากฏของข้อความในพรอมต์ เมื่อเขียน ให้ความสำคัญกับอักขระที่ใช้ทั่วไป และเลี่ยงอักขระหายากกับสัญลักษณ์พิเศษ เพื่อให้การแสดงผลดีที่สุด ปัจจุบันรองรับสถานการณ์เช่น สโลแกนโฆษณา คำบรรยาย และบับเบิลคำพูด กรณีอยู่ในส่วนสุดท้าย
แม่แบบพรอมต์สโลแกน: [เนื้อหาข้อความ] + [จังหวะเวลา] + [การวางตำแหน่ง] + [สไตล์การเข้า/การปรากฏ], [คุณลักษณะภาพ (สี, สไตล์ตัวอักษร)]
Seedance 2.0 จับคู่สไตล์ข้อความที่เหมาะสมตามบริบทได้ ถ้ามีข้อกำหนดเข้มงวดต่อการแสดงข้อความ ให้ใช้ตัวอย่างโลโก้ภายใต้การอ้างอิงหลายภาพ
แม่แบบพรอมต์คำบรรยาย: แสดงคำบรรยายที่กึ่งกลางด้านล่างพร้อมข้อความ คำบรรยายต้องซิงก์กับจังหวะและความเร็วของเสียงอย่างสมบูรณ์
การขยายวิดีโอกับการต่อแบบแบ่งช่วง
- เทคยาวต่อเนื่อง (การขยายวิดีโอ): เหมาะกับฉากบทสนทนาภายในฉากเดียว เช่น บทสนทนายาว การไต่ระดับอารมณ์ และการเคลื่อนที่ตามเส้นทางเดียว เพื่อให้ได้ผลลัพธ์ช็อตเดียวที่ดื่มด่ำและต่อเนื่อง
- จุดเปลี่ยนฉาก / การกระทำ (การต่อแบบแบ่งช่วง): เหมาะกับจุดหักมุมหรือฉากแอ็กชันที่ซับซ้อนและเร็ว เช่น การไล่ล่า การต่อสู้ และมอนตาจ สร้างคลิปอิสระแล้วตัดต่อเข้าด้วยกันเพื่อรักษาจังหวะและแรงกระทบทางภาพ
ในการผลิตจริง สองวิธีมักใช้ร่วมกัน ตัวอย่างเช่น ใช้การขยายก่อนเพื่อสร้างบทสนทนาที่ต่อเนื่อง แล้วต่อช็อตว่างหรือคลิปทรานซิชันเข้าไป สมดุลระหว่างความดื่มด่ำกับการเปลี่ยนจังหวะ
กลยุทธ์การจัดแอสเซต
แอสเซตมักแบ่งเป็นสี่บทบาทหน้าที่:
- การยึดตัวละคร: ล็อกรูปลักษณ์ตัวละคร
- การตั้งโทนฉาก: ล็อกสภาพแวดล้อมและสไตล์
- การอ้างอิงการเคลื่อนกล้อง: ล็อกภาษาช็อตและจังหวะการกระทำ
- บรรยากาศเชิงจังหวะ: ใช้เสียงควบคุมอารมณ์และโทนเสียง
การจัดที่แนะนำ รวม 4–5 แอสเซต: ภาพตัวละคร 1–2 ภาพ (โคลสอัปใบหน้า / เต็มตัว) + ภาพฉาก 1 ภาพ + วิดีโอการเคลื่อนกล้อง 1 ชิ้น + คลิปเสียง 1 ชิ้น
ไม่แนะนำให้ใช้ขีดจำกัดแอสเซตจนเต็ม แอสเซตมากเกินไปทำให้โมเดลตัดสินลำดับความสำคัญของลักษณะได้ยาก ซึ่งก่อให้เกิดความขัดแย้งของสไตล์ การระบุตัวแบบที่พร่ามัว และผลลัพธ์ที่เบี่ยงจากที่คาดได้ง่าย
ในตระกูล Seedance 2.0 เสียงจับคู่กับข้อความอย่างเดียวไม่ได้ เพิ่มภาพหรือวิดีโออย่างน้อยหนึ่งชิ้นพร้อมกับเสียง
สิ่งที่ควรสังเกต
มาตรฐานภาษา
ภาษาของบทสนทนาต้องสอดคล้องกัน และควรเลี่ยงการปนภาษาจีนกับภาษาอังกฤษ ยกเว้นชื่อเฉพาะ
มาตรฐานอักขระพิเศษ
การใช้สัญลักษณ์ในพรอมต์อย่างสมเหตุสมผลช่วยให้โมเดลเข้าใจชนิดข้อมูลต่าง ๆ ได้แม่นยำ
| ชนิดข้อมูล | สัญลักษณ์ | ตัวอย่าง |
|---|---|---|
| ดนตรี | () | (fast-paced rock music is playing in the background) |
| เอฟเฟกต์เสียง | ตารางอย่างเป็นทางการเปิดสัญลักษณ์นี้ไว้ บรรยายเสียงเป็นคำ ในบรรทัดเสียงของช็อต | |
| บทสนทนา | {} | {Hello, world} ถ้าบทสนทนาเป็นภาษาที่ไม่ค่อยใช้ ทั้งไม่ใช่จีนและไม่ใช่อังกฤษ ต้องระบุภาษา เช่น says in Japanese {こんにちは} |
| คำบรรยาย | 【】 | 【Chapter One: Departure】 |
คำถามที่พบบ่อย
การอ้างอิงใบหน้าไม่แม่นยำ
อาการทั่วไป รูปลักษณ์ตัวละครที่สร้างไม่สอดคล้องกับภาพอ้างอิง หรือเกิดการสลับใบหน้ากลางวิดีโอ (ID drift) ทำให้ตัวละครในวิดีโอคล้ายคนดังและถูกบล็อกตอนตรวจ
สาเหตุราก ภาพอ้างอิงใบหน้ามีประสิทธิผลไม่พอ
- ภาพอ้างอิงแบบผสม การให้โมเดลภาพรวมภาพเดียวที่มีทั้งอ้างอิงใบหน้า อ้างอิงท่าเต็มตัวหรือครึ่งตัว อ้างอิงเครื่องแต่งกาย อ้างอิงรายละเอียด และองค์ประกอบอ้างอิงอื่น
- สัดส่วนใบหน้าเล็กเกินไป ในภาพอ้างอิงแบบผสม พื้นที่ใบหน้ากินสัดส่วนของภาพทั้งภาพน้อยเกินไป เมื่อดึงลักษณะใบหน้า โมเดลให้น้ำหนักไม่พอ และถูกรบกวนจากพื้นหลังหรือองค์ประกอบอื่นได้ง่าย
ทางแก้ เสริมความเป็นอิสระและน้ำหนักของการอ้างอิงใบหน้า
- เตรียมภาพโคลสอัปใบหน้า นอกจากภาพเต็มตัวเดิม เตรียมภาพโคลสอัปใบหน้าเพิ่มที่มีเพียงศีรษะของตัวละคร เป็น headshot ที่คงไว้เฉพาะใบหน้า ไม่มีสีหน้าดีที่สุด ลดองค์ประกอบรบกวนเช่น ไหล่ คอ และพื้นหลังให้เหลือน้อยที่สุด
- กำหนดตัวแบบในพรอมต์ให้ชัด: ลักษณะใบหน้าอ้างอิง headshot เมคอัพและการจัดทรงอ้างอิงภาพเต็มตัว
- วางแอสเซตสำคัญไว้ก่อน ยิ่งแอสเซตต้องการการอ้างอิงที่แม่นยำ ยิ่งควรอยู่ต้นพรอมต์
สำหรับการอ้างอิงตัวละคร headshot บวกภาพเต็มตัวก็พอ ไม่แนะนำภาพตัวละครแบบ multi-view แอสเซต multi-view มีมุมต่างกันของตัวละครเดียวกัน และโมเดลอาจระบุว่าเป็นหลายตัวแบบต่างกันได้ง่าย ซึ่งกลับทำให้ปัญหา ID drift แย่ลง
ก่อน: ตัวละครในวิดีโอเปลี่ยนใบหน้ากลางทางและคล้ายคนดัง หลัง: ใบหน้าสอดคล้องกับภาพอ้างอิงตลอด
วิธีแก้
Prepare a close-up face image containing only the character's head, in addition to the full-body photo. No expression is best. Minimize shoulders, neck, and background. In the prompt: facial features reference the headshot, makeup and styling reference the full-body photo. Place the asset that needs precise reference earlier. A headshot plus a full-body photo is sufficient. Multi-view character images are not recommended: the model may identify them as multiple different subjects, which worsens ID drift.
คำบรรยายที่ไม่คาดคิดปรากฏในวิดีโอ
อาการทั่วไป พรอมต์ไม่ได้ขอคำบรรยาย แต่วิดีโอที่สร้างมีคำบรรยาย
ทางแก้ ไม่สามารถเลี่ยงการสร้างคำบรรยายได้ 100% โดยตรง ทำได้เพียงลดความน่าจะเป็นและเพิ่มอัตราสำเร็จ
- เพิ่มคำสั่งจำกัดที่ชัดเจนในพรอมต์: "Keep it subtitle-free" และ "Avoid generating any text or subtitles"
- ถ้าภาพหรือวิดีโออ้างอิงมีข้อความที่ไม่จำเป็น ให้ลบข้อความก่อน ด้วยการแก้ไขภาพหรือวิดีโอ แล้วใช้แอสเซตที่ไม่มีข้อความเป็นอินพุต
- ถ้าการใช้งานเอื้ออำนวย ให้ความสำคัญกับการสร้างวิดีโอขนาดแนวนอน ความน่าจะเป็นของการสร้างคำบรรยายในแนวนอนต่ำกว่าแนวตั้งอย่างชัดเจน ภายหลังตัดเป็นแนวตั้งในโปรแกรมตัดต่อได้
โลโก้หรือลายน้ำปรากฏในวิดีโอ
อาการทั่วไป พรอมต์ไม่ได้กล่าวถึงเนื้อหาเกี่ยวกับลายน้ำ แต่วิดีโอที่สร้างมีโลโก้หรือลายน้ำจากแพลตฟอร์มวิดีโออื่น
ทางแก้ เพิ่มคำสั่งจำกัดที่ชัดเจนในพรอมต์: "Do not generate watermarks" และ "Do not generate Logos"
สไตล์ลอย
อาการทั่วไป คาดว่าจะได้สไตล์อนิเมะ 2D หรือ 3D แต่สไตล์ของภาพอ้างอิงที่ป้อนค่อนข้างสมจริง และพรอมต์ไม่ได้เน้นสไตล์วิดีโอ ผลคือวิดีโอที่สร้างอาจลอยไปสู่สไตล์สมจริงแบบคนแสดง
ทางแก้ เพิ่มคำจำกัดสไตล์ที่ชัดเจนในพรอมต์ เช่น "2D Japanese anime style" หรือ "3D Chinese-style comic" ถ้าต้องการควบคุมสไตล์ให้แม่นขึ้น ให้แปลงภาพอ้างอิงเป็นสไตล์เป้าหมายก่อนสร้างวิดีโอ
ก่อน: สไตล์ xianxia ลอยไปเป็นสไตล์คนแสดง หลัง: คงสไตล์ xianxia แบบแอนิเมชัน CG จีน 3D
พรอมต์
Add an explicit style constraint, such as "2D Japanese anime style" or "3D Chinese-style comic". The after example maintains the 3D Chinese animation CG xianxia style. If more precise style control is required, first convert the reference image into the target style, then generate the video.
จัมป์คัตที่จุดเปลี่ยนของการขยายวิดีโอ
อาการทั่วไป หลังจากใช้การขยายวิดีโอเพื่อสร้างวิดีโอใหม่ เมื่อนำวิดีโอใหม่มาต่อกับวิดีโอต้นฉบับ อาจมีเฟรมกระโดดหรือปัญหาเนื้อหาย้อนกลับที่จุดต่อ
ทางแก้ คำแนะนำปัจจุบันคือซ่อมในการตัดต่อภายหลังโดยจัดคีย์เฟรมให้ตรงกัน การปรับปรุงรากฐานจะมาจากการทำซ้ำโมเดลในอนาคต
- นำเข้าวิดีโอที่จะต่อเข้า CapCut หรือซอฟต์แวร์ตัดต่อวิดีโอมืออาชีพอื่น
- ที่จุดต่อแรก ตัด 6 เฟรมจากท้ายช่วงวิดีโอก่อนหน้า
- ในเวลาเดียวกัน ตัด 1 เฟรมจากต้นช่วงวิดีโอถัดไป
- ทำซ้ำขั้นตอนด้านบนสำหรับทุกจุดต่อ
- ส่งออกและตรวจความลื่นของวิดีโอที่ต่อแล้ว
หลังจัดเฟรมวิดีโอให้ตรงกัน การกระโดดเล็กน้อยอาจยังมี แนะนำให้จบคลิปก่อนหน้าที่จังหวะตัดเปลี่ยน และเริ่มวิดีโอถัดไปจากฉากใหม่หลังการตัดนั้น
ก่อน: เกิดการกระโดดของจอทันทีหรือเนื้อหาย้อนกลับที่จุดเปลี่ยน หลัง: การเปลี่ยนลื่นขึ้น
วิธีแก้
Repair the join in post-editing by aligning keyframes. At the first join, trim 6 frames from the end of the previous video segment, and trim 1 frame from the beginning of the following video segment. Repeat for all stitching points.
ตัวละครซ้ำ
อาการทั่วไป ในสถานการณ์ที่มีตัวละครจำนวนมากในเฟรม และให้ภาพตัวละครแบบ three-view เป็นแอสเซตอ้างอิง ตัวละครที่เหมือนกันสองคนอาจปรากฏในเฟรมวิดีโอที่สร้างเฟรมเดียวกันได้ง่าย
สาเหตุราก
- ตัวแบบของตัวละครไม่ได้กำหนดชัดในพรอมต์ จึงแยกบทบาทต่างกันได้ไม่แม่น
- เมื่อใช้ภาพตัวละครแบบ three-view หรือ multi-view เป็นแอสเซตอ้างอิง การรู้จำตัวละครของโมเดลง่ายที่จะสับสน ทำให้สร้างตัวละครซ้ำที่มีรูปลักษณ์เดียวกัน
ทางแก้ ไม่สามารถเลี่ยงปัญหาฝาแฝดได้ 100% โดยตรง วิธีต่อไปลดความน่าจะเป็นและเพิ่มอัตราสำเร็จได้เท่านั้น
- ระบุความเชื่อมระหว่างตัวละครกับตัวแบบให้ชัด กำหนดแต่ละบทบาทในพรอมต์ให้ชัด และระบุความสอดคล้องระหว่างบทบาทกับภาพอ้างอิง ทำเครื่องหมายภาพอ้างอิงที่ตรงกันหลังชื่อตัวละครแต่ละชื่อ และรักษารูปแบบให้สม่ำเสมอ ตัวอย่าง: Zhang San (ตรงกับ image 1) โยนสมุดเงินฝากสีเขียวไปทาง Li Si (ตรงกับ image 2) ที่กำลังยืน
- เพิ่มคำสั่งจำกัดทั้งเรื่อง เพิ่มข้อจำกัดคงที่ท้ายพรอมต์: ตลอดวิดีโอ ห้ามตัวละครที่มีรูปลักษณ์ เสื้อผ้า และเครื่องประดับเหมือนกันทั้งหมด อย่าสร้างอวาตาร์ซ้ำหรือเอฟเฟกต์ฝาแฝด ให้คงตัวละครที่ตรงกันเพียงคนเดียวในเฟรมเดียวกัน และอย่าผลิตสำเนาตัวละครซ้ำ
- ปรับแอสเซตอ้างอิง สำหรับภาพอ้างอิงตัวละคร ให้ความสำคัญกับภาพเดี่ยวของคนเดียว แอสเซต three-view หรือ multi-view ไม่แนะนำ
- ทำให้พรอมต์เรียบและดีขึ้น อย่าใช้บททั้งเรื่องเป็นพรอมต์โดยตรง ข้อความที่ซ้ำซ้อนเกินทำให้ความเข้าใจของโมเดลสับสนได้ง่าย เอาคำบรรยายที่ไม่เกี่ยวข้องออก และให้คำสั่งชัดและโฟกัส
ก่อน: ฝาแฝดปรากฏในวิดีโอ หลัง: หนึ่งคนต่อหนึ่งบทบาท
วิธีแก้
Clearly define each character role and the corresponding reference image, and keep the format consistent. Example: Zhang San (corresponding to image 1) throws the green passbook toward Li Si (corresponding to image 2), who is standing. At the end of the prompt: Throughout the video, characters with completely identical appearance, clothing, and accessories are prohibited. Do not generate duplicate avatars or a twin effect. Keep only a single corresponding character in the same frame, and do not reproduce repeated copies of characters. Prioritize independent single-person photos. Three-view or multi-view assets are not recommended. Do not paste the complete script as the prompt.
คุณภาพภาพลดลงระหว่างการขยายวิดีโอ
อาการทั่วไป เมื่อใช้วิดีโอที่โมเดลสร้างเป็นแอสเซตอินพุตเพื่อขยายและสานต่อ คุณภาพภาพลดลง การสานต่อหลายครั้งทบการลดลง และบล็อกสีด่างมีแนวโน้มปรากฏโดยเฉพาะบริเวณใบหน้าตัวละคร
ทางแก้ วิธีต่อไปบรรเทาการลดคุณภาพภาพได้ การปรับปรุงรากฐานจะทำภายหลังผ่านการทำซ้ำโมเดล
- แปลงวิดีโอต้นฉบับเป็นวิดีโอโมเดลสีขาว แล้วใช้เป็นแอสเซตอินพุตสำหรับการสานต่อ พรอมต์อ้างอิง: แปลงวิดีโอเป็นโมเดล 3D สีขาว (white 3D model) ตัวละครทั้งหมดควรรวมเป็นโมเดล 3D สีขาวบริสุทธิ์ ไม่มีสี ไม่มีพื้นผิว และไม่มีเงา ใช้พื้นหลังสีขาวบริสุทธิ์ โครงสร้างเสถียร และการเคลื่อนไหวลื่น
- ให้ความสำคัญกับภาพความละเอียดสูงเป็นแอสเซตอ้างอิง
- ควบคุมจำนวนการสานต่อวิดีโออย่างสมเหตุสมผล และเลี่ยงการสานต่อซ้ำที่ซ้อนกัน
ก่อน: สานต่อโดยตรงจากเอาต์พุตของโมเดล หลัง: แปลงเอาต์พุตของโมเดลเป็นวิดีโอโมเดลสีขาวก่อนทำการสานต่อ
พรอมต์
Convert the video into a white 3D model. All characters should be unified as pure white 3D models, with no color, no texture, and no shadows; use a pure white background, stable structure, and smooth motion. Then continue from that white-model video. Prioritize high-definition images as reference assets, and avoid repeated stacked continuations.
เอฟเฟกต์พิเศษไม่ตรงความคาด
อาการทั่วไป เมื่อบรรยายเอฟเฟกต์พิเศษหนึ่งผ่านข้อความพรอมต์ เอฟเฟกต์อาจไม่ตรงความคาด ตัวอย่างเช่น ถ้าพรอมต์กำหนดให้เลข "2999" ปรากฏพร้อมแอนิเมชันนับถอยหลัง เอฟเฟกต์เลื่อนตัวเลขที่สร้างจริงอาจกระโดดแบบสุ่มและไม่เดินตามตรรกะการนับถอยหลังมาตรฐาน
ทางแก้ ใช้วิดีโออ้างอิงเพื่อกำหนดเอฟเฟกต์พิเศษ ป้อนวิดีโอเอฟเฟกต์พิเศษเป้าหมายเข้าโมเดลเป็นแอสเซตอ้างอิง เพื่อให้โมเดลเข้าใจรูปของเอฟเฟกต์และตรรกะการเคลื่อนไหวได้แม่นยำ และผลลัพธ์ตรงความคาดมากขึ้น ตัวอย่าง: วิธีที่เลข "2999" ปรากฏควรอ้างอิง @Video1
ก่อน: เอฟเฟกต์เลื่อนตัวเลขมีความรู้สึกกระโดดไร้ระเบียบชัดเจน หลัง: หลังเพิ่มวิดีโอเอฟเฟกต์เลื่อนตัวเลขที่ถูกต้อง ผลเอฟเฟกต์ตรงความคาด
สื่ออ้างอิง
@Video1
พรอมต์
The way the number "2999" appears should reference @Video1.
ตัวละครอ้างอิงมากเกินไป
อาการทั่วไป เมื่อจำนวนคนอ้างอิงเกิน 4 ความเสถียรของเอาต์พุตโมเดลลดลง และวิดีโอที่สร้างอาจมีปัญหาเช่น จำนวนคนผิด (เช่น ตัวละครน้อยเกินไปหรือมากเกินไป) หรือตัวละครซ้ำ
ทางแก้ บรรเทาได้ด้วยวิธีต่อไป ในอนาคตการปรับปรุงรากฐานจะทำตามการทำซ้ำของโมเดล
- สร้างภาพทีละขั้น จัดกลุ่มคนเพื่อให้จำนวนคนในแต่ละภาพที่สร้างไม่เกิน 4 ตัวอย่างเช่น คน 6 คนแบ่งเป็น 2 กลุ่ม กลุ่มละ 3 คน และสร้างภาพแยกกัน
- สร้างวิดีโอจากภาพ ใช้ภาพที่จัดกลุ่มหลายภาพจากขั้นแรกเป็นแอสเซตอ้างอิง แล้วสร้างวิดีโอสุดท้าย
ก่อน: ป้อนตัวละครอ้างอิง 8 คน และวิดีโอเอาต์พุตมี 9 คน หลัง: สร้าง 2 ภาพจากตัวละคร 8 คน แล้วใช้การสร้างจากภาพเป็นวิดีโอ
วิธีแก้
When the number of reference people exceeds 4, group them so that each generated image contains no more than 4 people. For example, 6 people can be divided into 2 groups of 3. Generate those images first, then generate the video from the grouped images.
เสียงรบกวนท้ายวิดีโอ
อาการทั่วไป เมื่อวิดีโอมีการบรรยาย มีแนวโน้มเกิดเสียงคลิกกะทันหันและเสียงรบกวนจากการตัดที่ท้ายวิดีโอ
ทางแก้ สร้างวิดีโอใหม่ หรือใช้โปรแกรมอย่าง CapCut ใส่เฟดเอาต์เสียงบนแทร็กเสียงท้ายผ่าน volume envelope เพื่อกำจัดเสียงรบกวนจากการตัด
ขั้นตอนเฉพาะ โดยใช้ CapCut:
- นำเข้าวิดีโอที่สร้างเข้า CapCut
- เลือกแทร็กวิดีโอบนไทม์ไลน์แล้วคลิก Audio บนแถบเครื่องมือ
- เลือกฟังก์ชัน Volume envelope ในบางเวอร์ชันอยู่ที่เมนู Basic / Adjust เลือกคีย์เฟรม เส้นที่แทนระดับเสียงและคีย์เฟรมจะปรากฏบนแทร็กเสียง
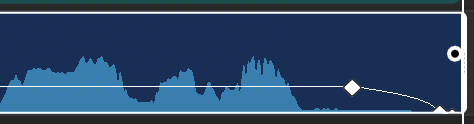
- ใกล้ท้ายวิดีโอ ลากคีย์เฟรมระดับเสียงสุดท้ายลงไปที่ระดับ 0 เพื่อให้เกิดความชันลง เส้นโค้งบนการ์ดคือความชันนั้น
- ดูตัวอย่างและยืนยันว่าเสียงท้ายจางลงอย่างเป็นธรรมชาติ ไม่มีการตัดกะทันหันหรือเสียงรบกวน
ก่อน: มีเสียงรบกวนที่ท้าย หลัง: ไม่มีเสียงรบกวนที่ท้าย
สื่ออ้างอิง
@Image1
วิธีแก้
Regenerate the video, or fade the ending audio to silence with a volume envelope. Near the end, drag the final volume keyframe down to 0 so the curve in @Image1 forms a downward slope.
การออกเสียงภาษาจีนไม่แม่นยำ
อาการทั่วไป โมเดลมีแนวโน้มออกเสียงตัวอักษรหลายเสียง ตัวอักษรไม่คุ้น และตัวอักษรรูปร่างคล้ายกันผิด
ทางแก้ แทนข้อความที่อ่านผิดง่ายด้วยคำพ้องเสียงที่ใช้ทั่วไปซึ่งออกเสียงเดียวกัน เพื่อเลี่ยงความเบี่ยงของการออกเสียงและคืนเอฟเฟกต์เสียงที่คาดไว้ ทางแก้นี้เป็นวิธีปรับให้ดีขึ้นเท่านั้น และเลี่ยงปัญหาการออกเสียงทั้งหมดได้ไม่หมด
ตัวอย่าง: เขียน "螭龙山" ในพรอมต์ใหม่เป็นคำพ้องเสียง "吃龙山"
ก่อน: การออกเสียง "螭" ใน "螭龙山" ไม่ถูกต้อง หลัง: เปลี่ยนเป็น "吃龙山" แล้วการออกเสียงถูกต้อง
พรอมต์
Replace text that is easy to misread with a commonly used homophone of the same pronunciation. Rewrite "螭龙山" as "吃龙山". This is an optimization and cannot completely avoid all pronunciation issues.
การอ้างอิงเสียงไม่แม่นยำ
อาการทั่วไป เมื่อใช้เสียงอ้างอิงเพื่อกำหนดเสียง เสียงในวิดีโอสุดท้ายที่สร้างต่างจากเสียงอ้างอิงอย่างมาก
ทางแก้
- เพิ่มคำบรรยายลักษณะเสียงอย่างละเอียดในพรอมต์ บรรทัดที่ใช้ในตัวอย่างนี้คือ: ใช้เสียงชายวัยกลางคนที่ต่ำ หนา อบอุ่น และมีเกรนละเอียดของ
@Audio1 - ให้สไตล์ประโยคในวิดีโอใกล้โทนและสไตล์การแสดงของเสียงอ้างอิง ซึ่งช่วยให้การคืนเสียงและความเสถียรดีขึ้น
ใน อ้างอิงหลายรายการ ไฟล์นั้นคือ @Audio1 ในตระกูล Seedance 2.0 จับคู่เสียงกับภาพหรือวิดีโออย่างน้อยหนึ่งชิ้น
ก่อน: เสียงไม่ตรงกับเสียงที่ป้อน หลัง: หลังเพิ่มคำบรรยายลักษณะเสียงในพรอมต์ ความแม่นยำของการจับคู่เสียงดีขึ้นอย่างชัดเจน
สื่ออ้างอิง
@Audio1
พรอมต์
Use the low, thick, warm, and finely grainy middle-aged male voice of @Audio1. Keep the style of the lines close to the tone and expression of that reference audio.
ตัวอย่างพรอมต์
ส่วนนี้แสดงตัวอย่างพรอมต์อย่างเป็นทางการสำหรับการสร้างข้อความ การอ้างอิงภาพ การอ้างอิงวิดีโอ และการแก้ไขวิดีโอ พรอมต์บนการ์ดแต่ละใบคงประโยคอย่างเป็นทางการ บทพูดและคำบนจอไม่เปลี่ยน @Image1, @Video1 และ @Audio1 คือโทเคนของสตูดิโอนี้สำหรับ Image 1, Video 1 และ Audio 1 จุดที่พรอมต์อย่างเป็นทางการพูดว่า Image 1, Image 2 และ Image 3 สิ่งเหล่านั้นคือป้ายบนแผ่นอ้างอิงแผ่นเดียว และแผ่นนั้นคือไฟล์เดียว @Image1
สโลแกน
แม่แบบพรอมต์: [เนื้อหาข้อความ] + [จังหวะเวลา] + [การวางตำแหน่ง] + [สไตล์การเข้า/การปรากฏ], [คุณลักษณะภาพ (สี, สไตล์ตัวอักษร)]
Seedance 2.0 จับคู่สไตล์ข้อความที่เหมาะสมตามบริบทได้ ถ้ามีข้อกำหนดเข้มงวดต่อการแสดงข้อความ ให้ใช้ตัวอย่างโลโก้ภายใต้การอ้างอิงหลายภาพ
สื่ออ้างอิง
@Image1
พรอมต์
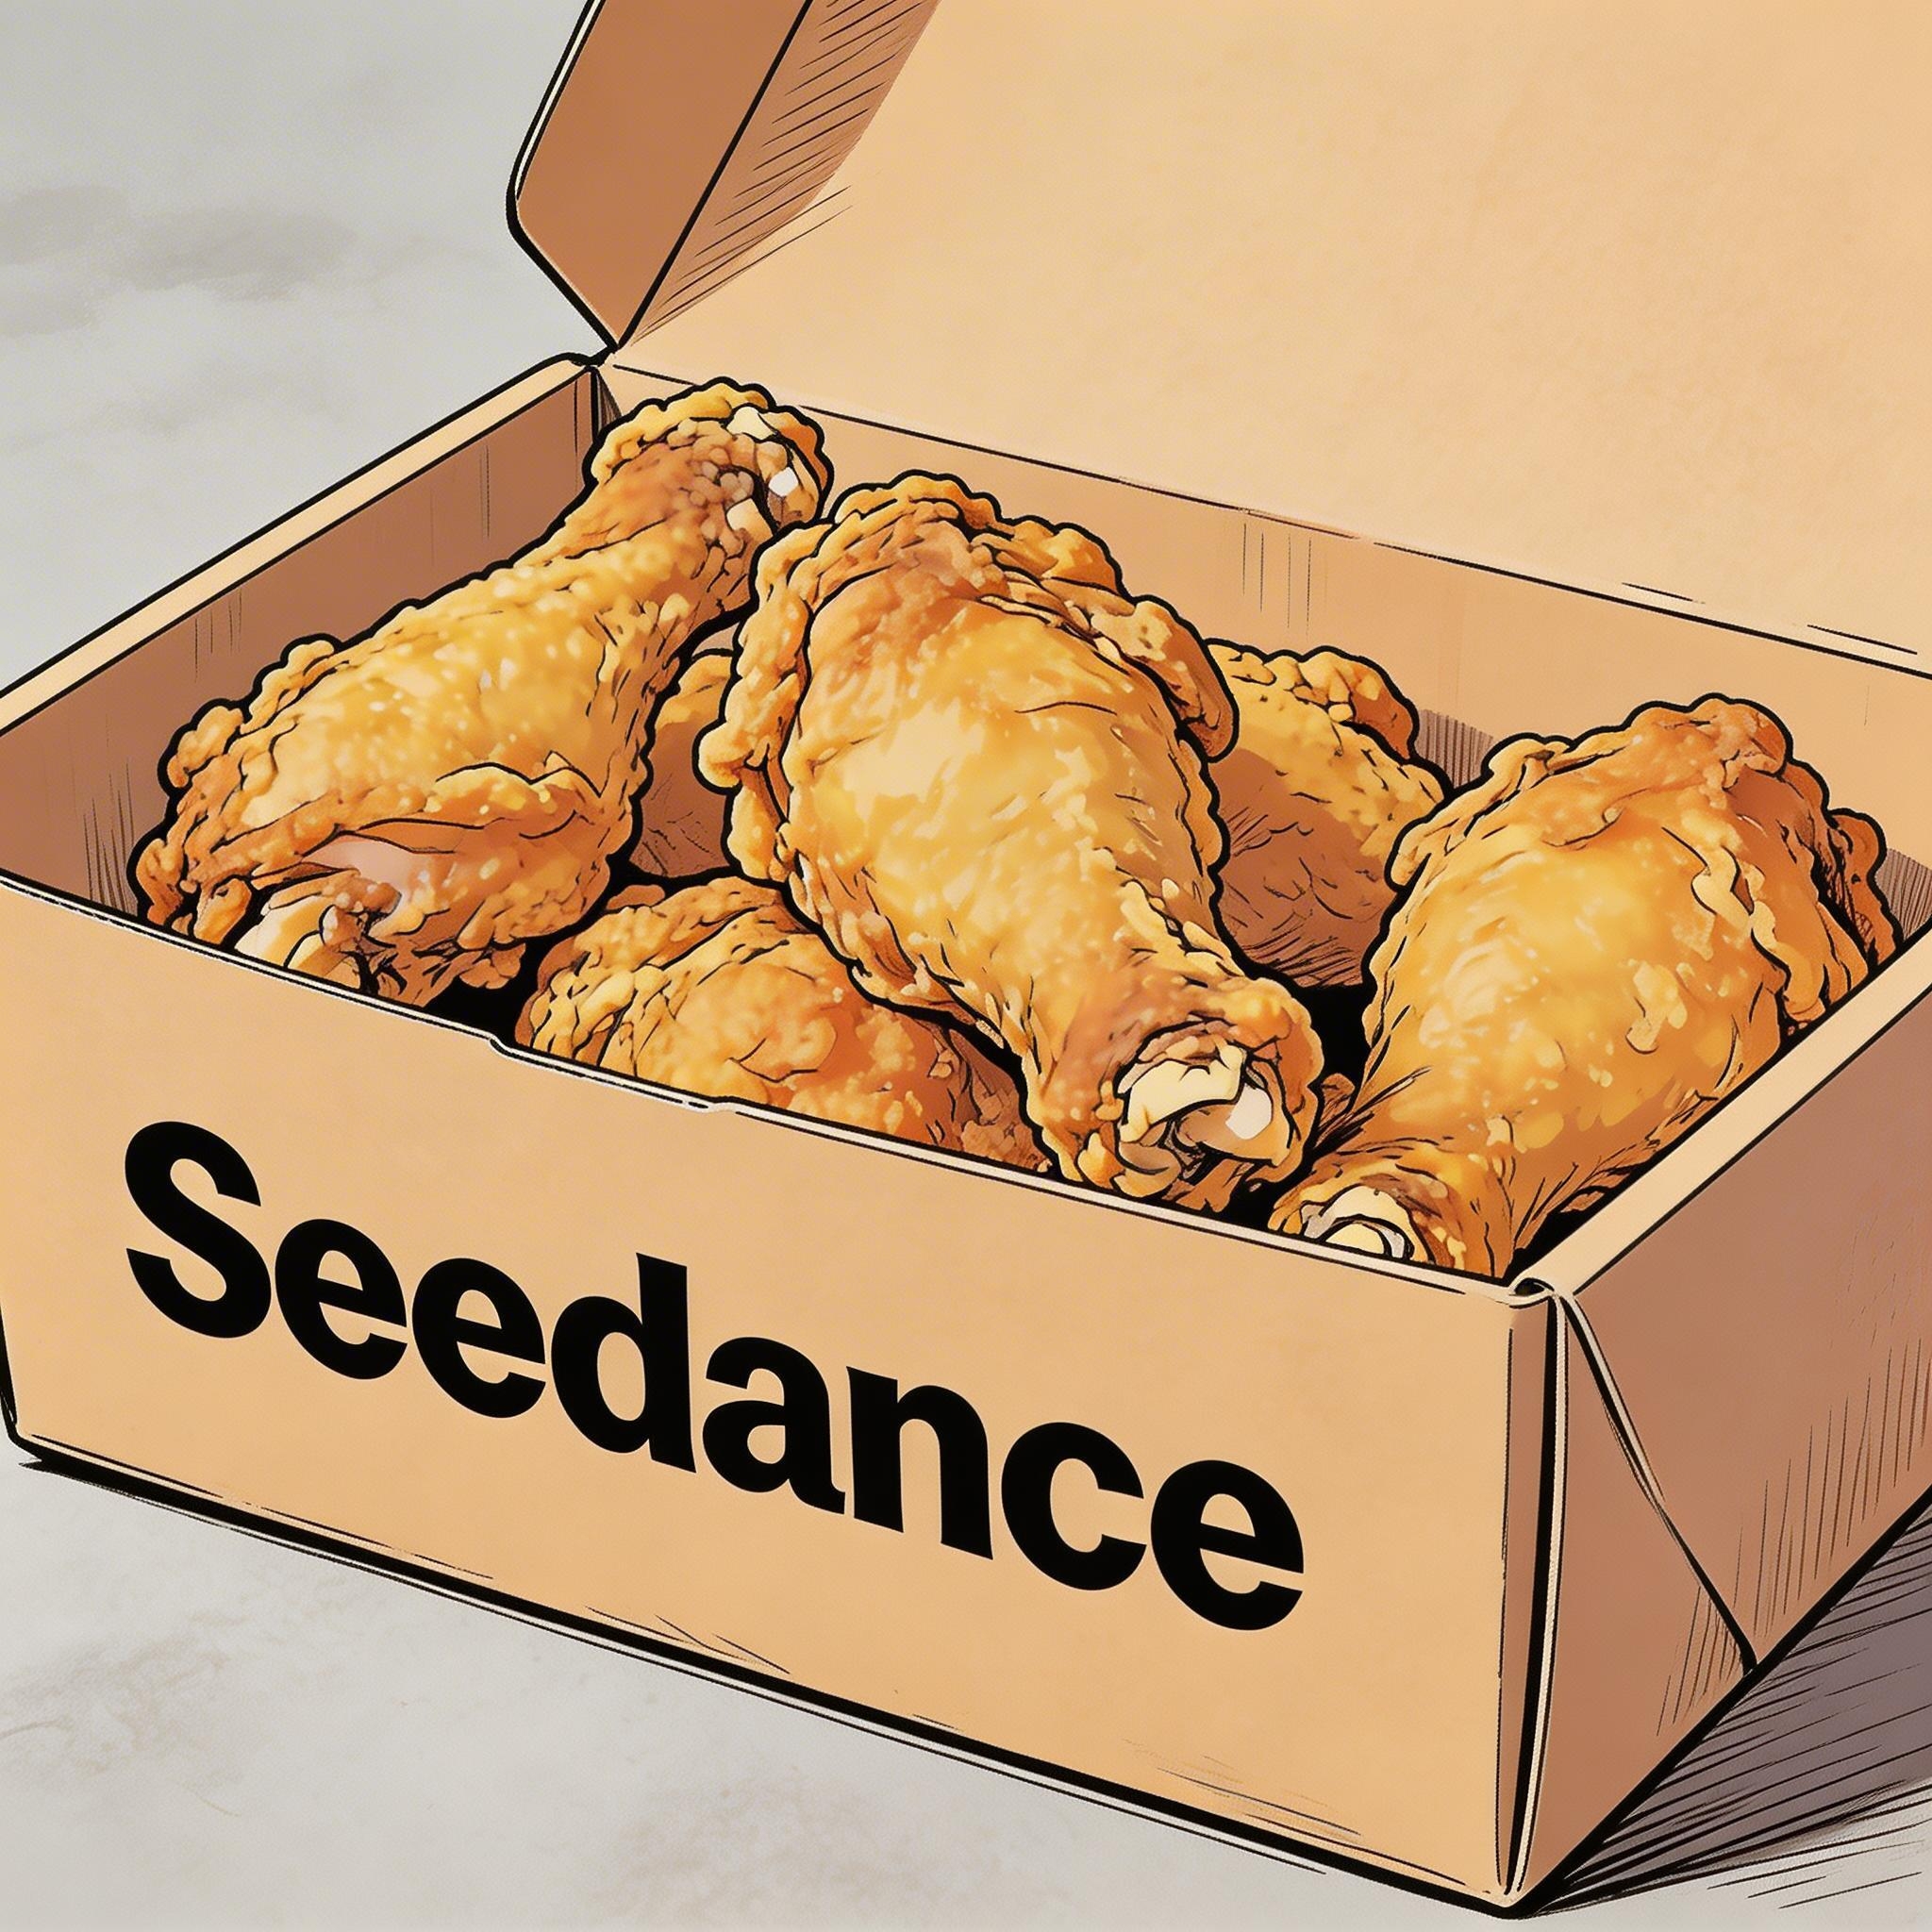
Hand-drawn comic style: Three people are sitting around a table enjoying the fried chicken shown in @Image1, with a friendly and joyful atmosphere. The frame then gradually blurs, and the text "Bite", "Laugh", and "Seedance" in order appears in the center of the screen.
คำบรรยาย
แม่แบบพรอมต์: แสดงคำบรรยายที่กึ่งกลางด้านล่างพร้อมข้อความ คำบรรยายต้องซิงก์กับจังหวะและความเร็วของเสียงอย่างสมบูรณ์
ตัวอย่างแรกเป็นเสียงบรรยาย ตัวอย่างที่สองเป็นการพากย์
สื่ออ้างอิง
@Image1
พรอมต์
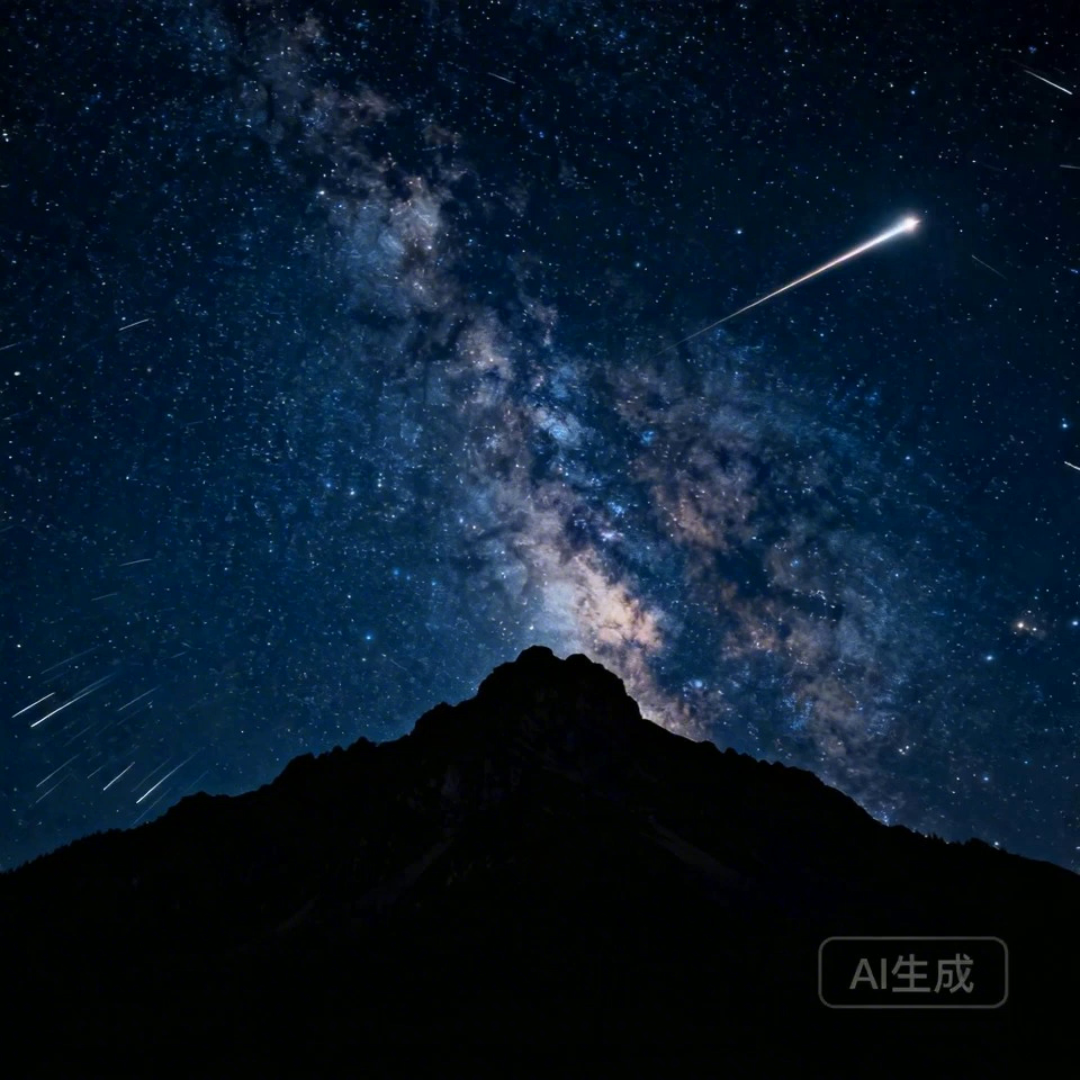
I2V: A time-lapse of a mountain landscape transitioning from a vast, starry night to a vibrant dawn. Reference @Image1. Voiceover: A deep, serene male voice says: "In the vast silence of the cosmos, our world is but a fleeting moment. Yet, within it, life defiantly thrives." Text integration: Render the narration as subtitles at the bottom-center. Subtitles must be perfectly synchronized with audio timing.
สื่ออ้างอิง
@Image1
พรอมต์
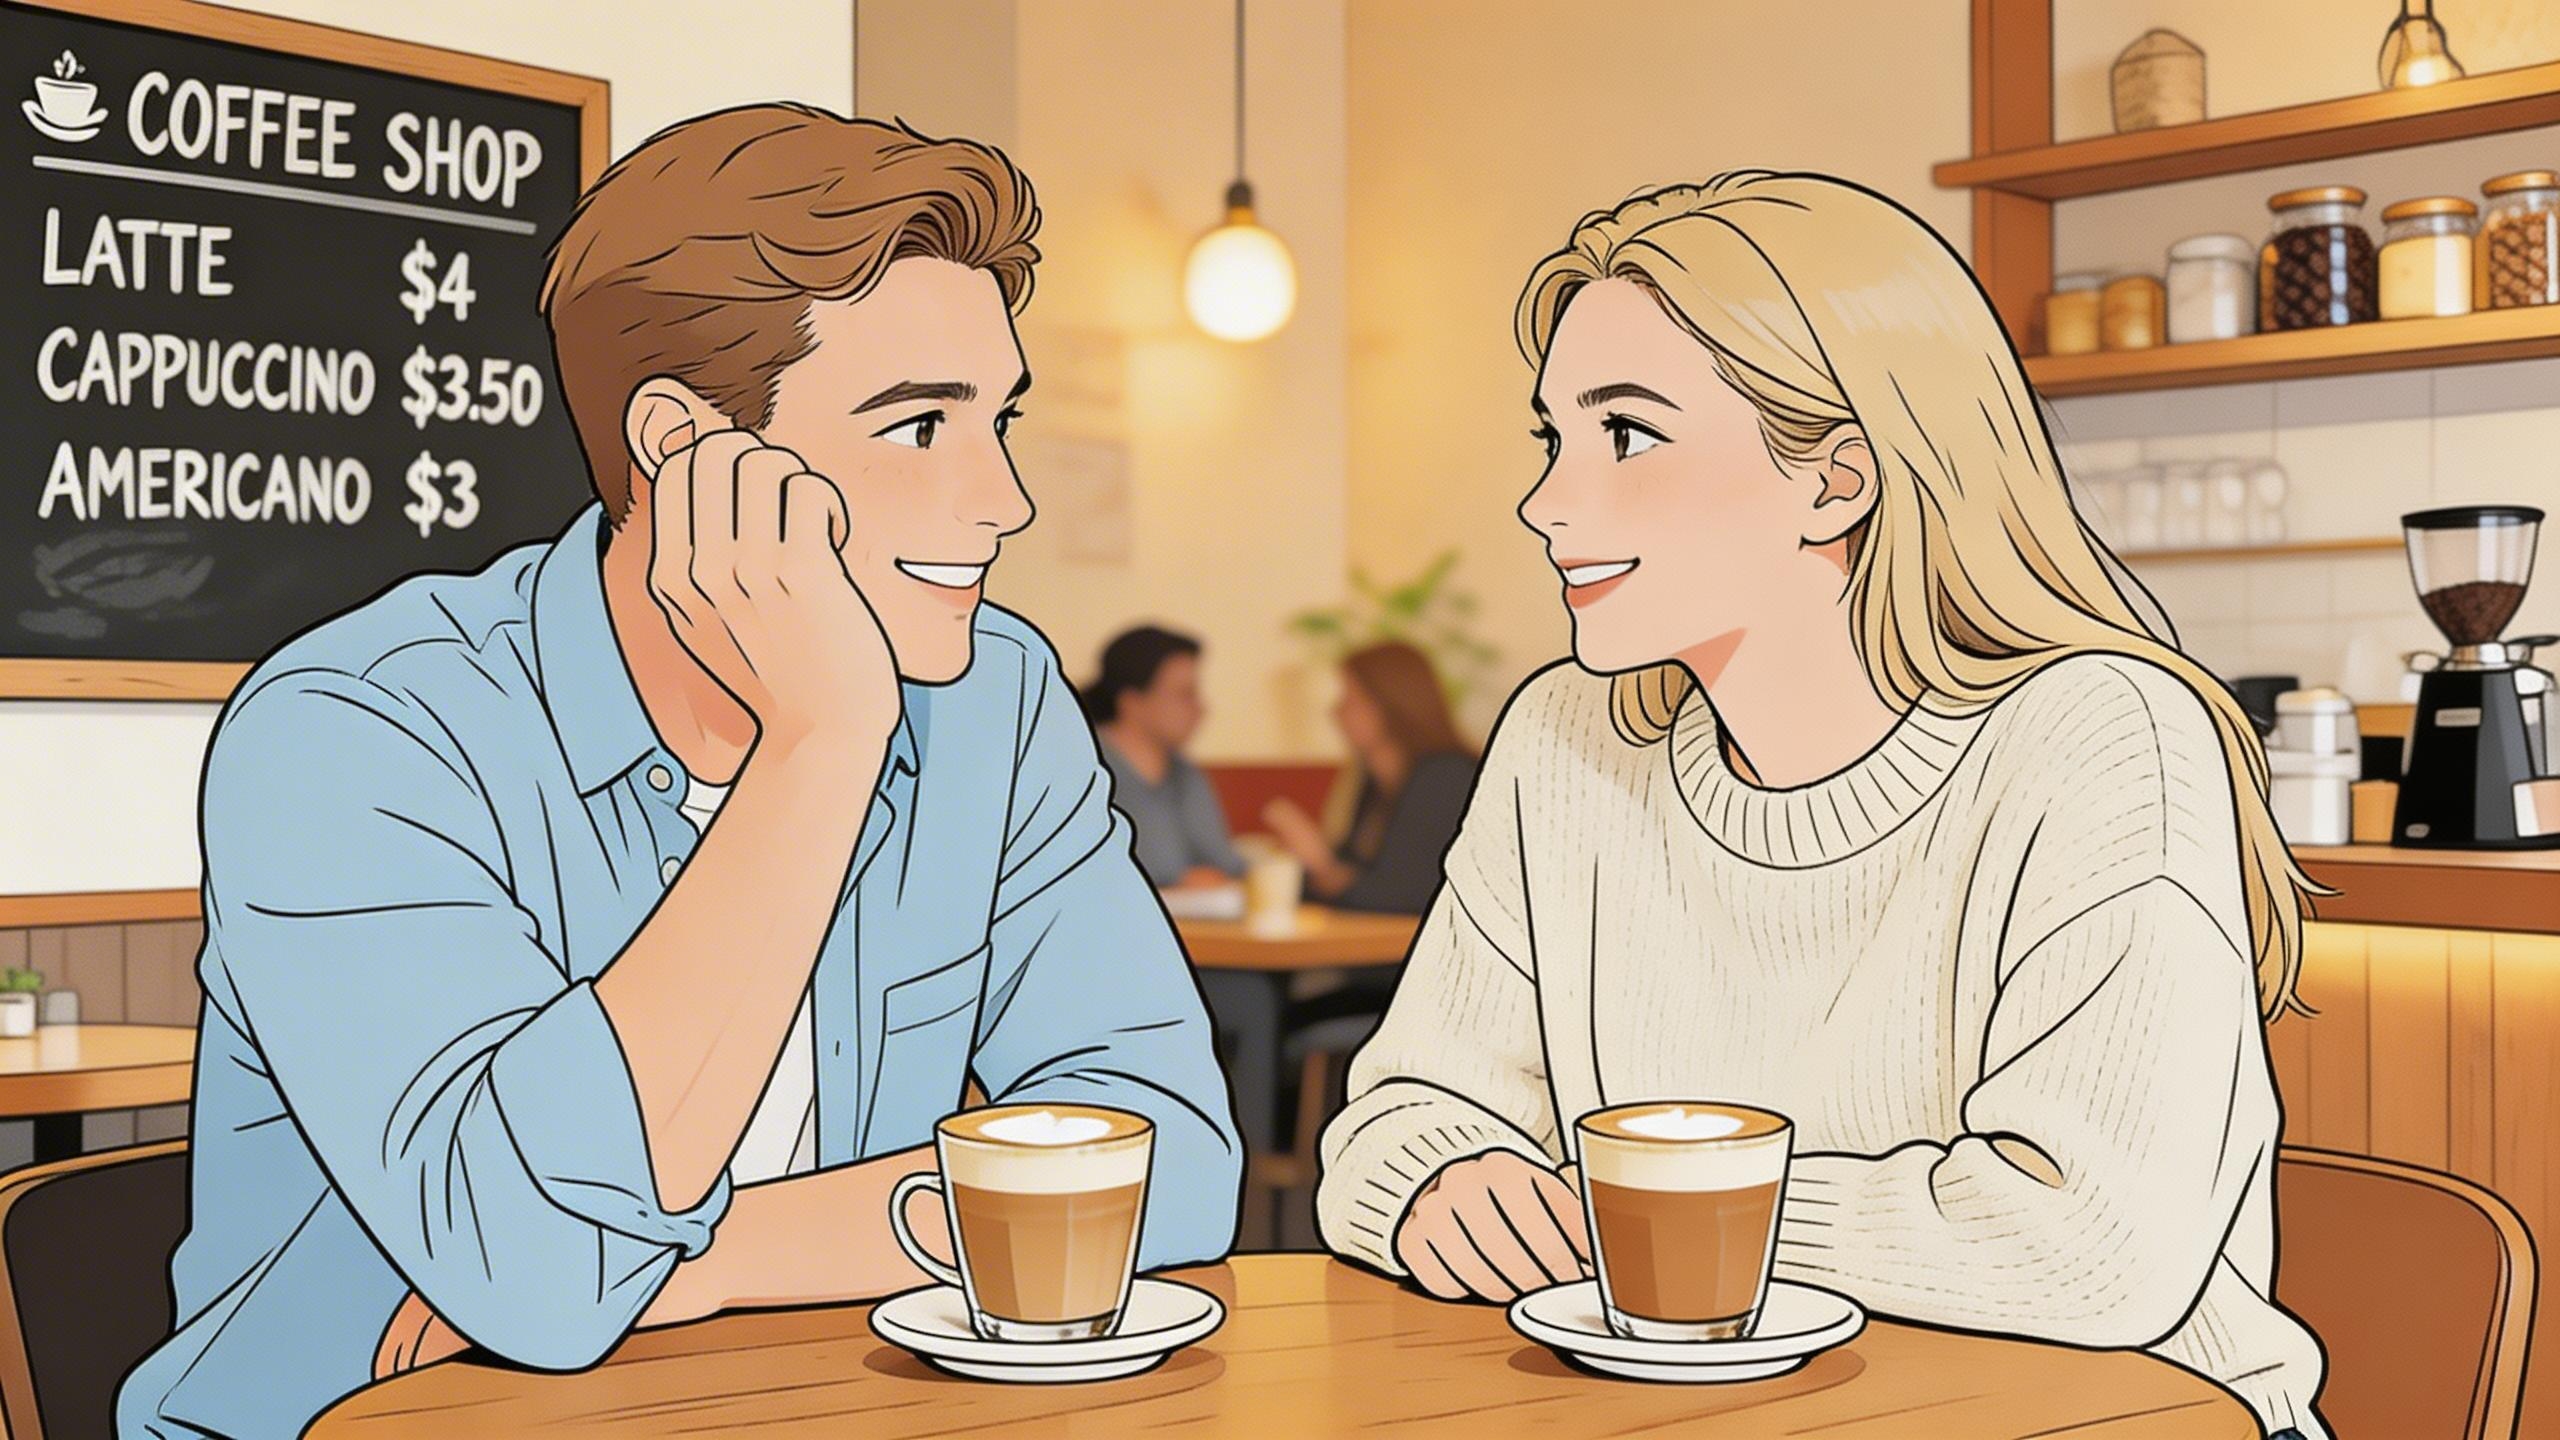
R2V: A shot of these two people in @Image1 chatting in a modern office. The woman speaks first with a playful tone: "You always arrive right on time, don't you just love that perfect timing?" followed by the man's smiling reply: "I have my own rhythm." Text integration: Render the dialogue as subtitles at the bottom-center of the screen. Subtitles should appear sequentially as each character speaks.
บับเบิลคำพูด
บับเบิลคำพูดมีบทที่พูด และปรากฏข้างตัวละครที่กำลังพูด
สื่ออ้างอิง
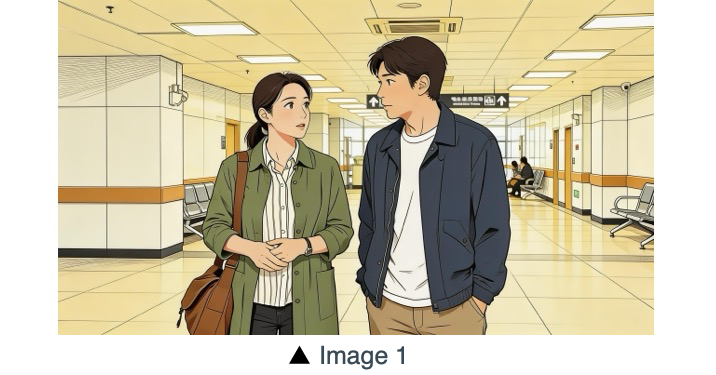
@Image1
พรอมต์
The two characters from @Image1, both dressed in sportswear, are running on the school playground. The girl looks at the boy, smiling confidently as she says: "We can definitely do it!". Cut to a close-up of the boy. He hesitates and replies: "Are you sure?". Cut back to a medium close-up of the girl. She speaks in a light, upbeat tone: "Yes!" Her demeanor is bright and resolute. Speech bubbles containing the corresponding lines appear around the speaking character.
สื่ออ้างอิง
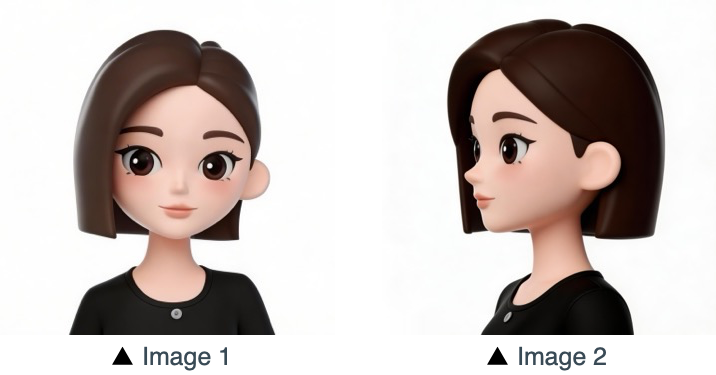
@Image1
พรอมต์
Refer to the character design of the girl in Image 1 and Image 2 on @Image1. The scene is set in an apple field: the girl picks one apple, takes a bite, smiles and says "This is the real deal!". A speech bubble pops up beside the girl, with this line written inside.
การอ้างอิงตัวแบบหลายมุม
ตัวแบบเดียว อ้างอิงจากหลายมุมบนแผ่น: อิเล็กทรอนิกส์ผู้บริโภค บ้านและไลฟ์สไตล์ และบุคคล
สื่ออ้างอิง
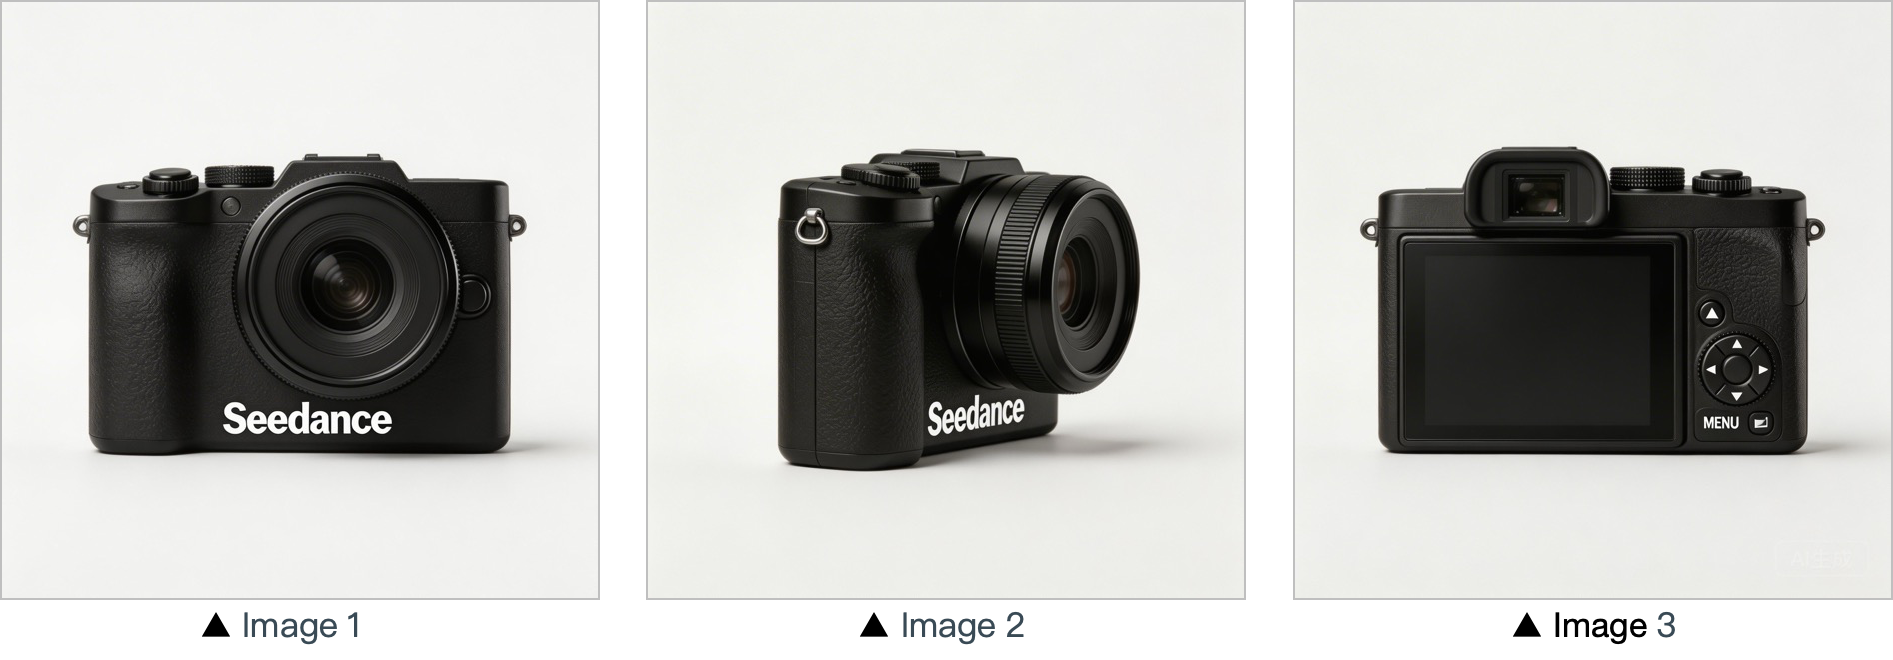
@Image1
พรอมต์
Use the cameras featured in Image 1, Image 2 and Image 3 on @Image1. Replace the original background with a white one, and place the cameras on a white table. The camera first focuses on the cameras in close-up, then slowly rotates 360° with the cameras as the main subject, clearly displaying the front, sides and back of each camera.
สื่ออ้างอิง
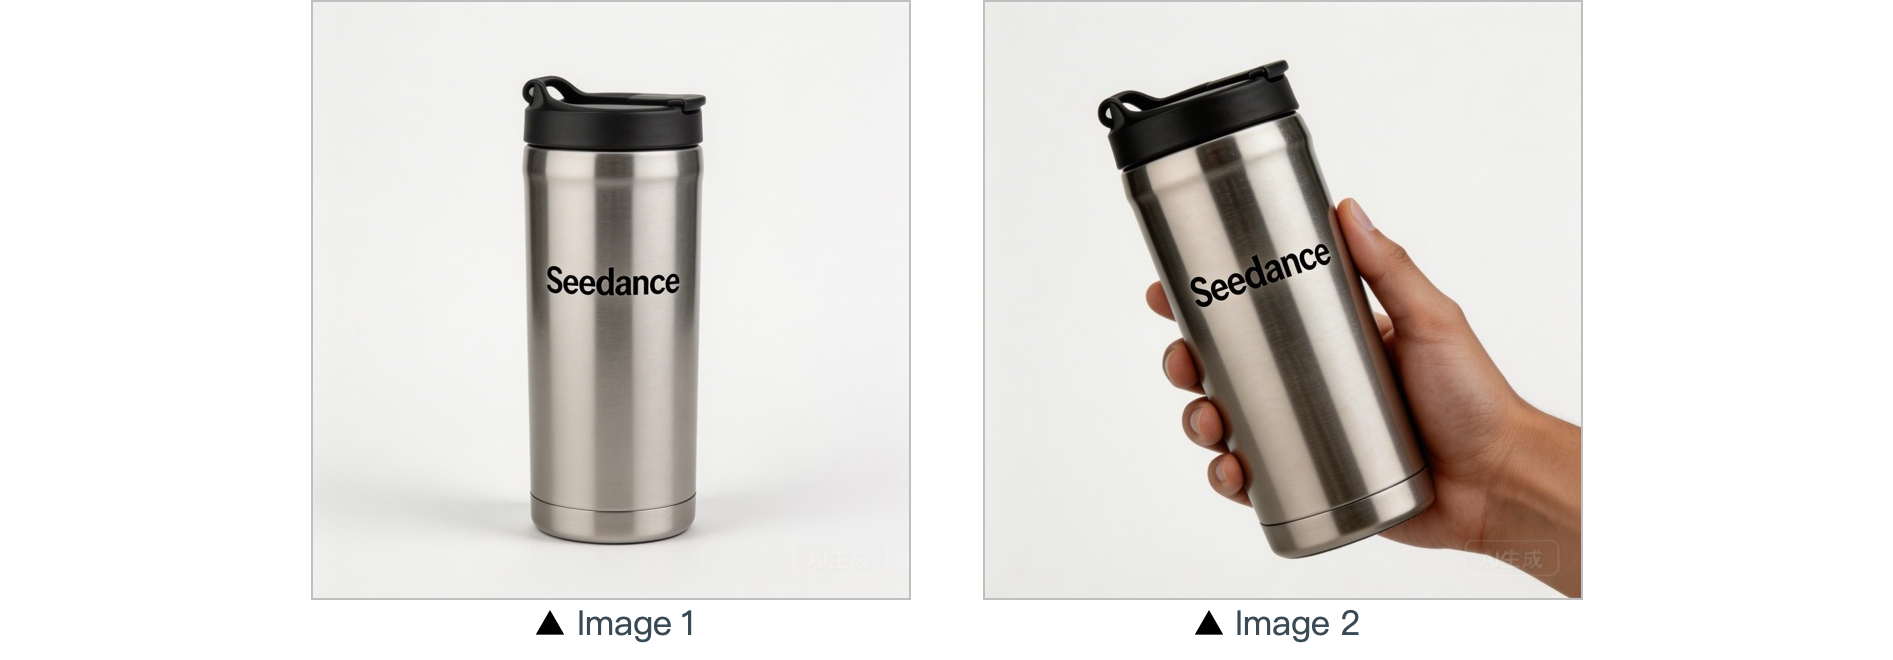
@Image1
พรอมต์
In a warm-toned home setting, present the thermos shown in @Image1 in a medium shot. Then smoothly push the camera into a close-up of the thermos. Next, a hand naturally enters the frame off-screen, gently grips the thermos body and picks it up. The camera follows the slight rotating motion of the hand to showcase the thermos.
สื่ออ้างอิง
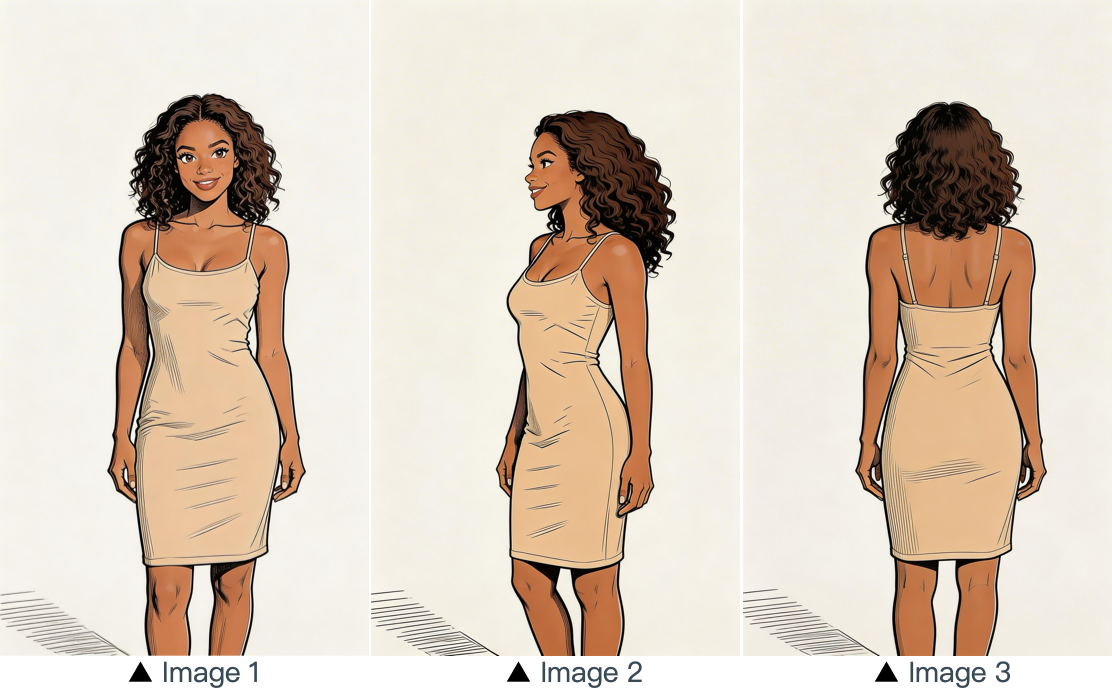
@Image1
พรอมต์
Refer to the image of the woman in Image 1, Image 2 and Image 3 on @Image1, and generate a scene of her eating a cake in a coffee shop.
การอ้างอิงหลายภาพ
แต่ละภาพบนแผ่นมีหน้าที่หนึ่ง: โลโก้, หลายตัวแบบ, นักแสดงและสถานที่, ลำดับหลายช่อง หรือลำดับเฟรม
สื่ออ้างอิง
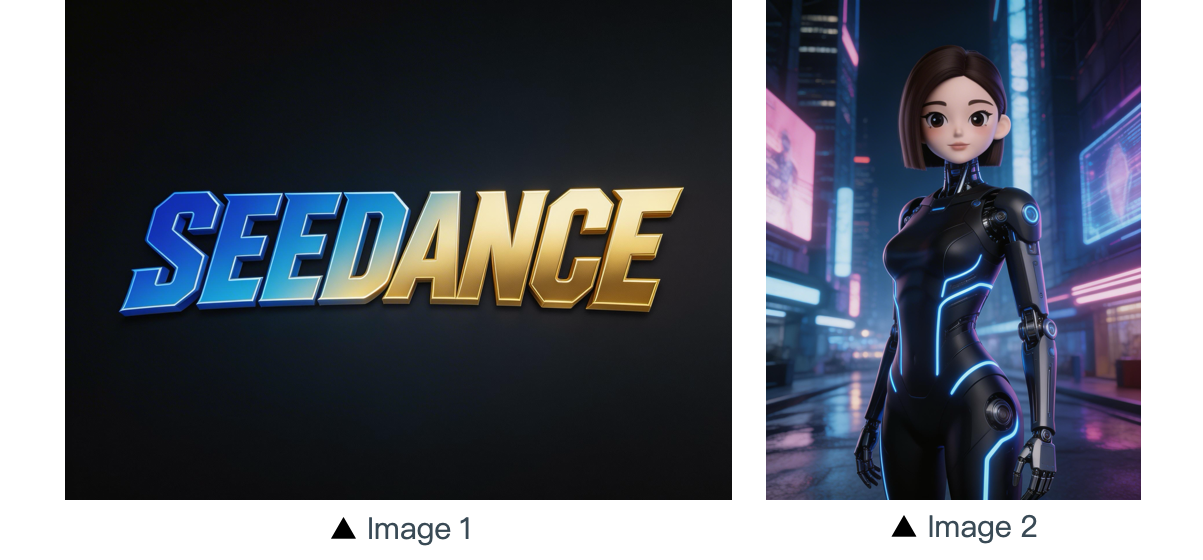
@Image1
พรอมต์
The scene is set on an aerial corridor in a neon-drenched futuristic metropolis, where flying vehicles and holographic ads intertwine. Featuring the girl from Image 2 on @Image1, the sequence opens with a medium shot of her releasing a silver floating lantern embedded with a holographic projection. The camera then pulls back to reveal floating lanterns flooding the sky, which gradually converge at the center of the frame to form the logo from Image 1 on @Image1. The entire piece adopts a 3D cyberpunk sci-fi animation style.
สื่ออ้างอิง
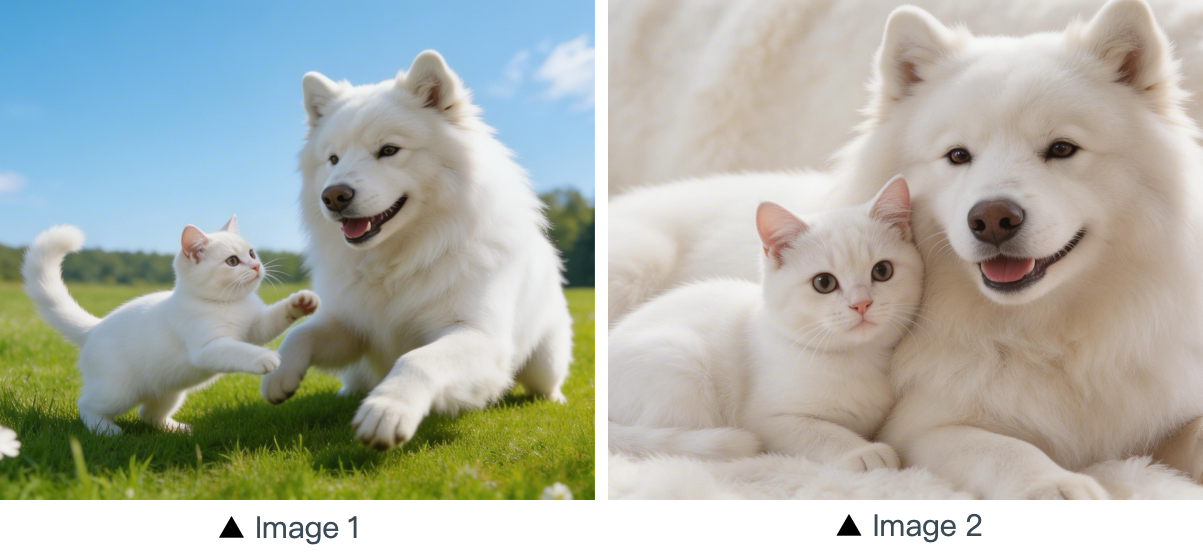
@Image1
พรอมต์
Using the cat and dog from Image 1 and Image 2 on @Image1 as prototypes, the scene unfolds in a cozy apartment. The dog is lying on the ground eating dog food when the cat approaches, extending a paw to nudge the dog. The dog pauses its meal upon noticing the cat, and the cat snuggles up next to the dog. The entire scene features a warm colored tone.
สื่ออ้างอิง
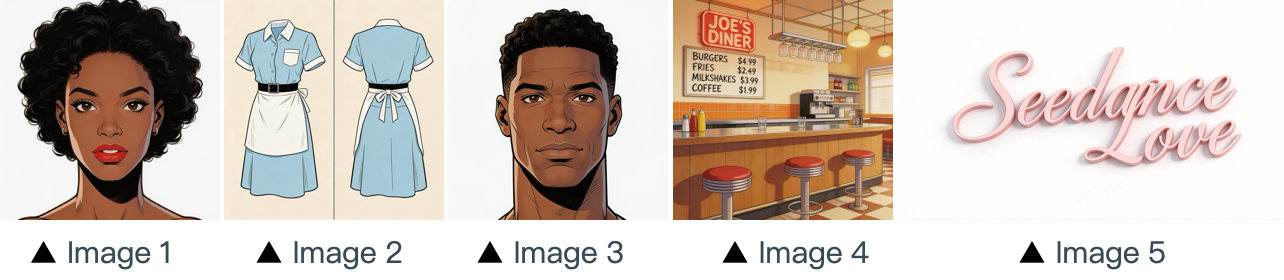
@Image1
พรอมต์
The scene is set in the restaurant from image 4 on @Image1, with people coming and going. The girl from image 1, wearing the clothes from image 2, is organizing the items on the counter. The boy, a customer, from image 3 approaches her to ask for her contact information. The logo from image 5 remains in the bottom right corner throughout.
สื่ออ้างอิง
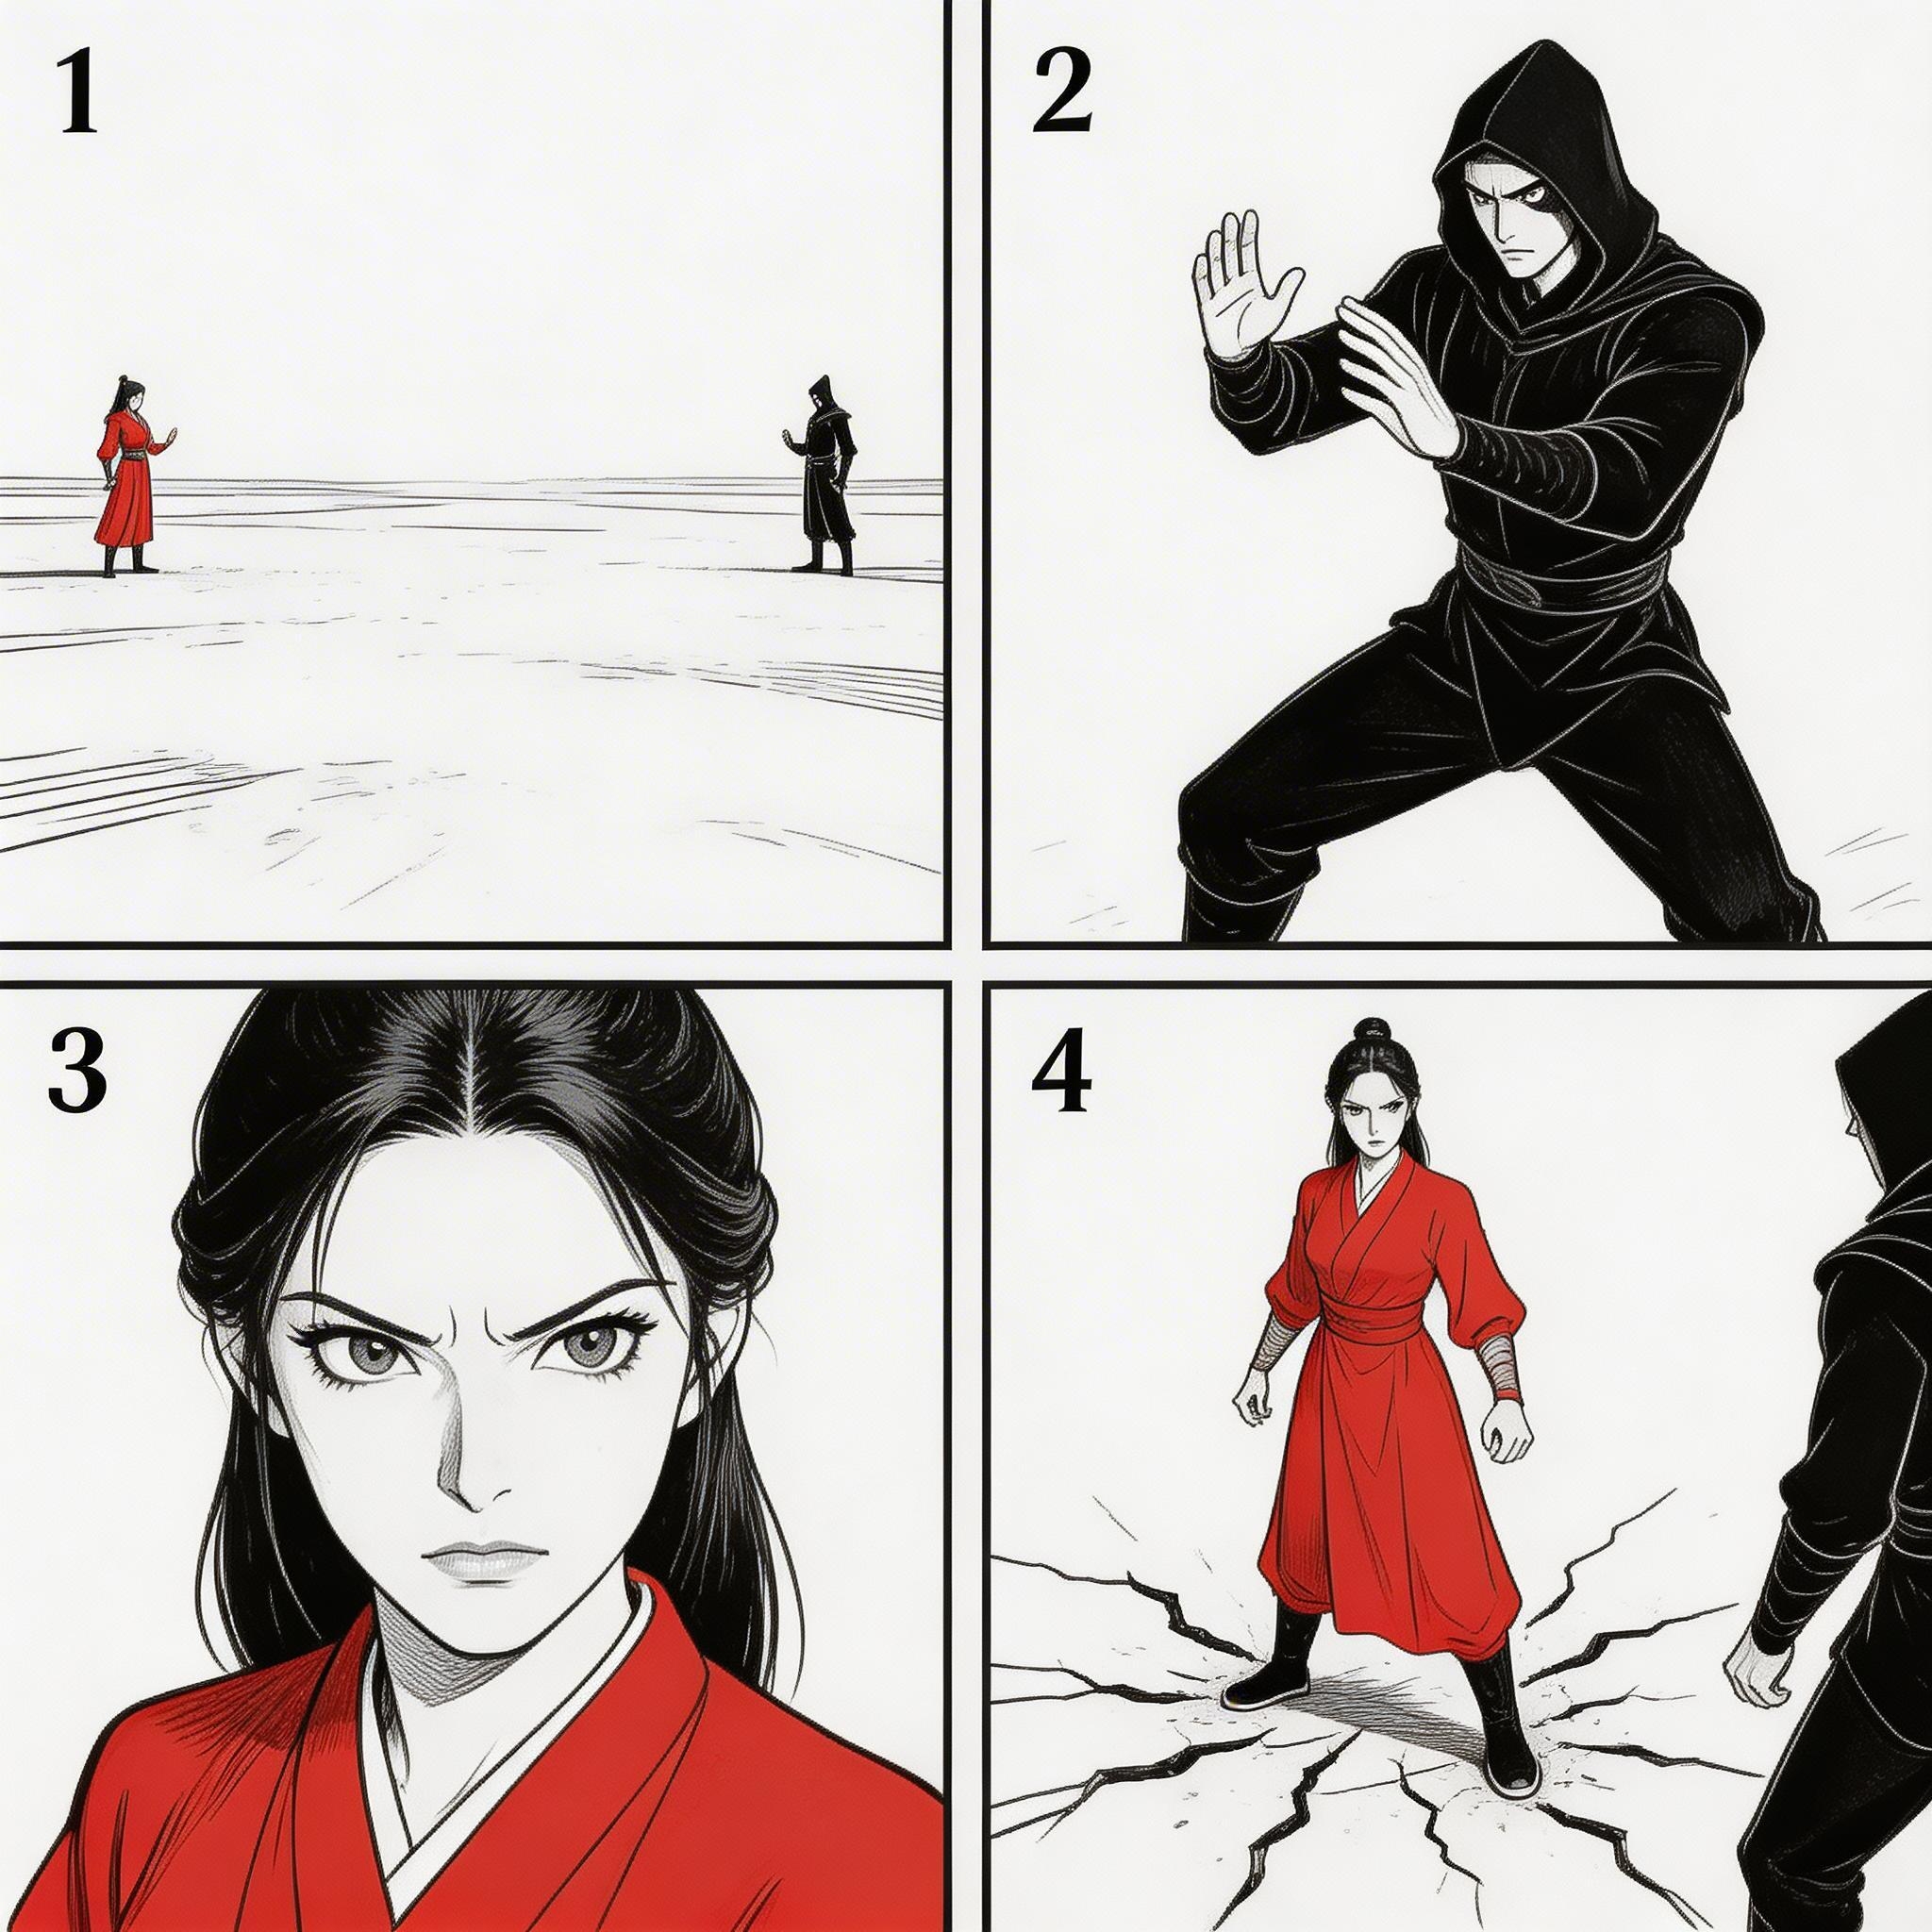
@Image1
พรอมต์
Refer to the sequence in @Image1 to create an intense high-energy fight sequence. All frame compositions from @Image1 shall be presented in strict predefined order, after which the two characters engage in fierce, fast-paced combat.
สื่ออ้างอิง
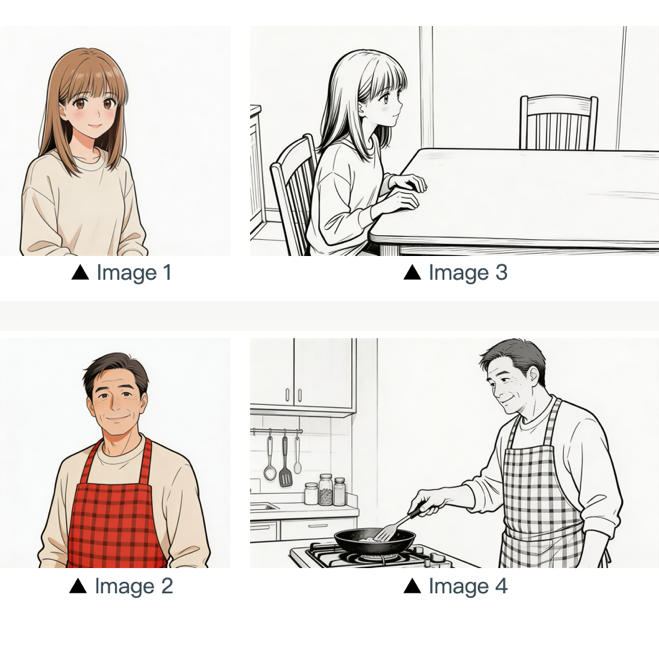
@Image1
พรอมต์
Refer to the composition in Image 3 on @Image1. A girl (her character design refers to Image 1) is waiting for her father to finish cooking, and she says: "아빠, 배고파요! 밥 다 됐어요?" Then the camera pans right and cuts to the frame and composition shown in Image 4. The father (his character design refers to Image 2) replies to her: "거의 다 됐어, 조금만 기다려!" Next, the camera cuts back to a close-up shot of the daughter's slightly disappointed facial expression, and she says: "아직 멀었어요? 맛있는 냄새 나는데..." Then the shot switches to a close-up of the father's face, and he says: "이제 진짜 금방이야. '빨리빨리' 하지 말고 손부터 씻고 와!"
การอ้างอิงการเคลื่อนไหว
อ้างอิงการเคลื่อนไหวของตัวละครและภาษาช็อตในวิดีโอ แล้วนำไปใช้กับตัวละครในภาพ ตัวอย่างการตลาดอ้างอิงรูปทรงการวิ่งของม้าในวิดีโอ
สื่ออ้างอิง
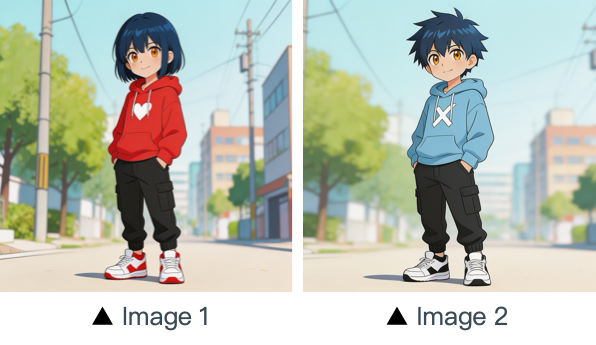
@Image1
@Video1
พรอมต์
Refer to the character movements and shot language in @Video1 to create a fight scene with the character from Image 2 on @Image1 on the left and the character from Image 1 on @Image1 on the right. Include intense background music.
สื่ออ้างอิง
@Video1
พรอมต์
Referencing the running shape of the horse in @Video1, generate a scene: a golden steed runs on the grassland, then freezes its magnificent running posture and turns into a horse-shaped gold pendant.
การอ้างอิงการเคลื่อนกล้อง
อ้างอิงการเคลื่อนกล้องในวิดีโอ และตั้งชื่อตัวแบบใหม่ในภาพ
สื่ออ้างอิง
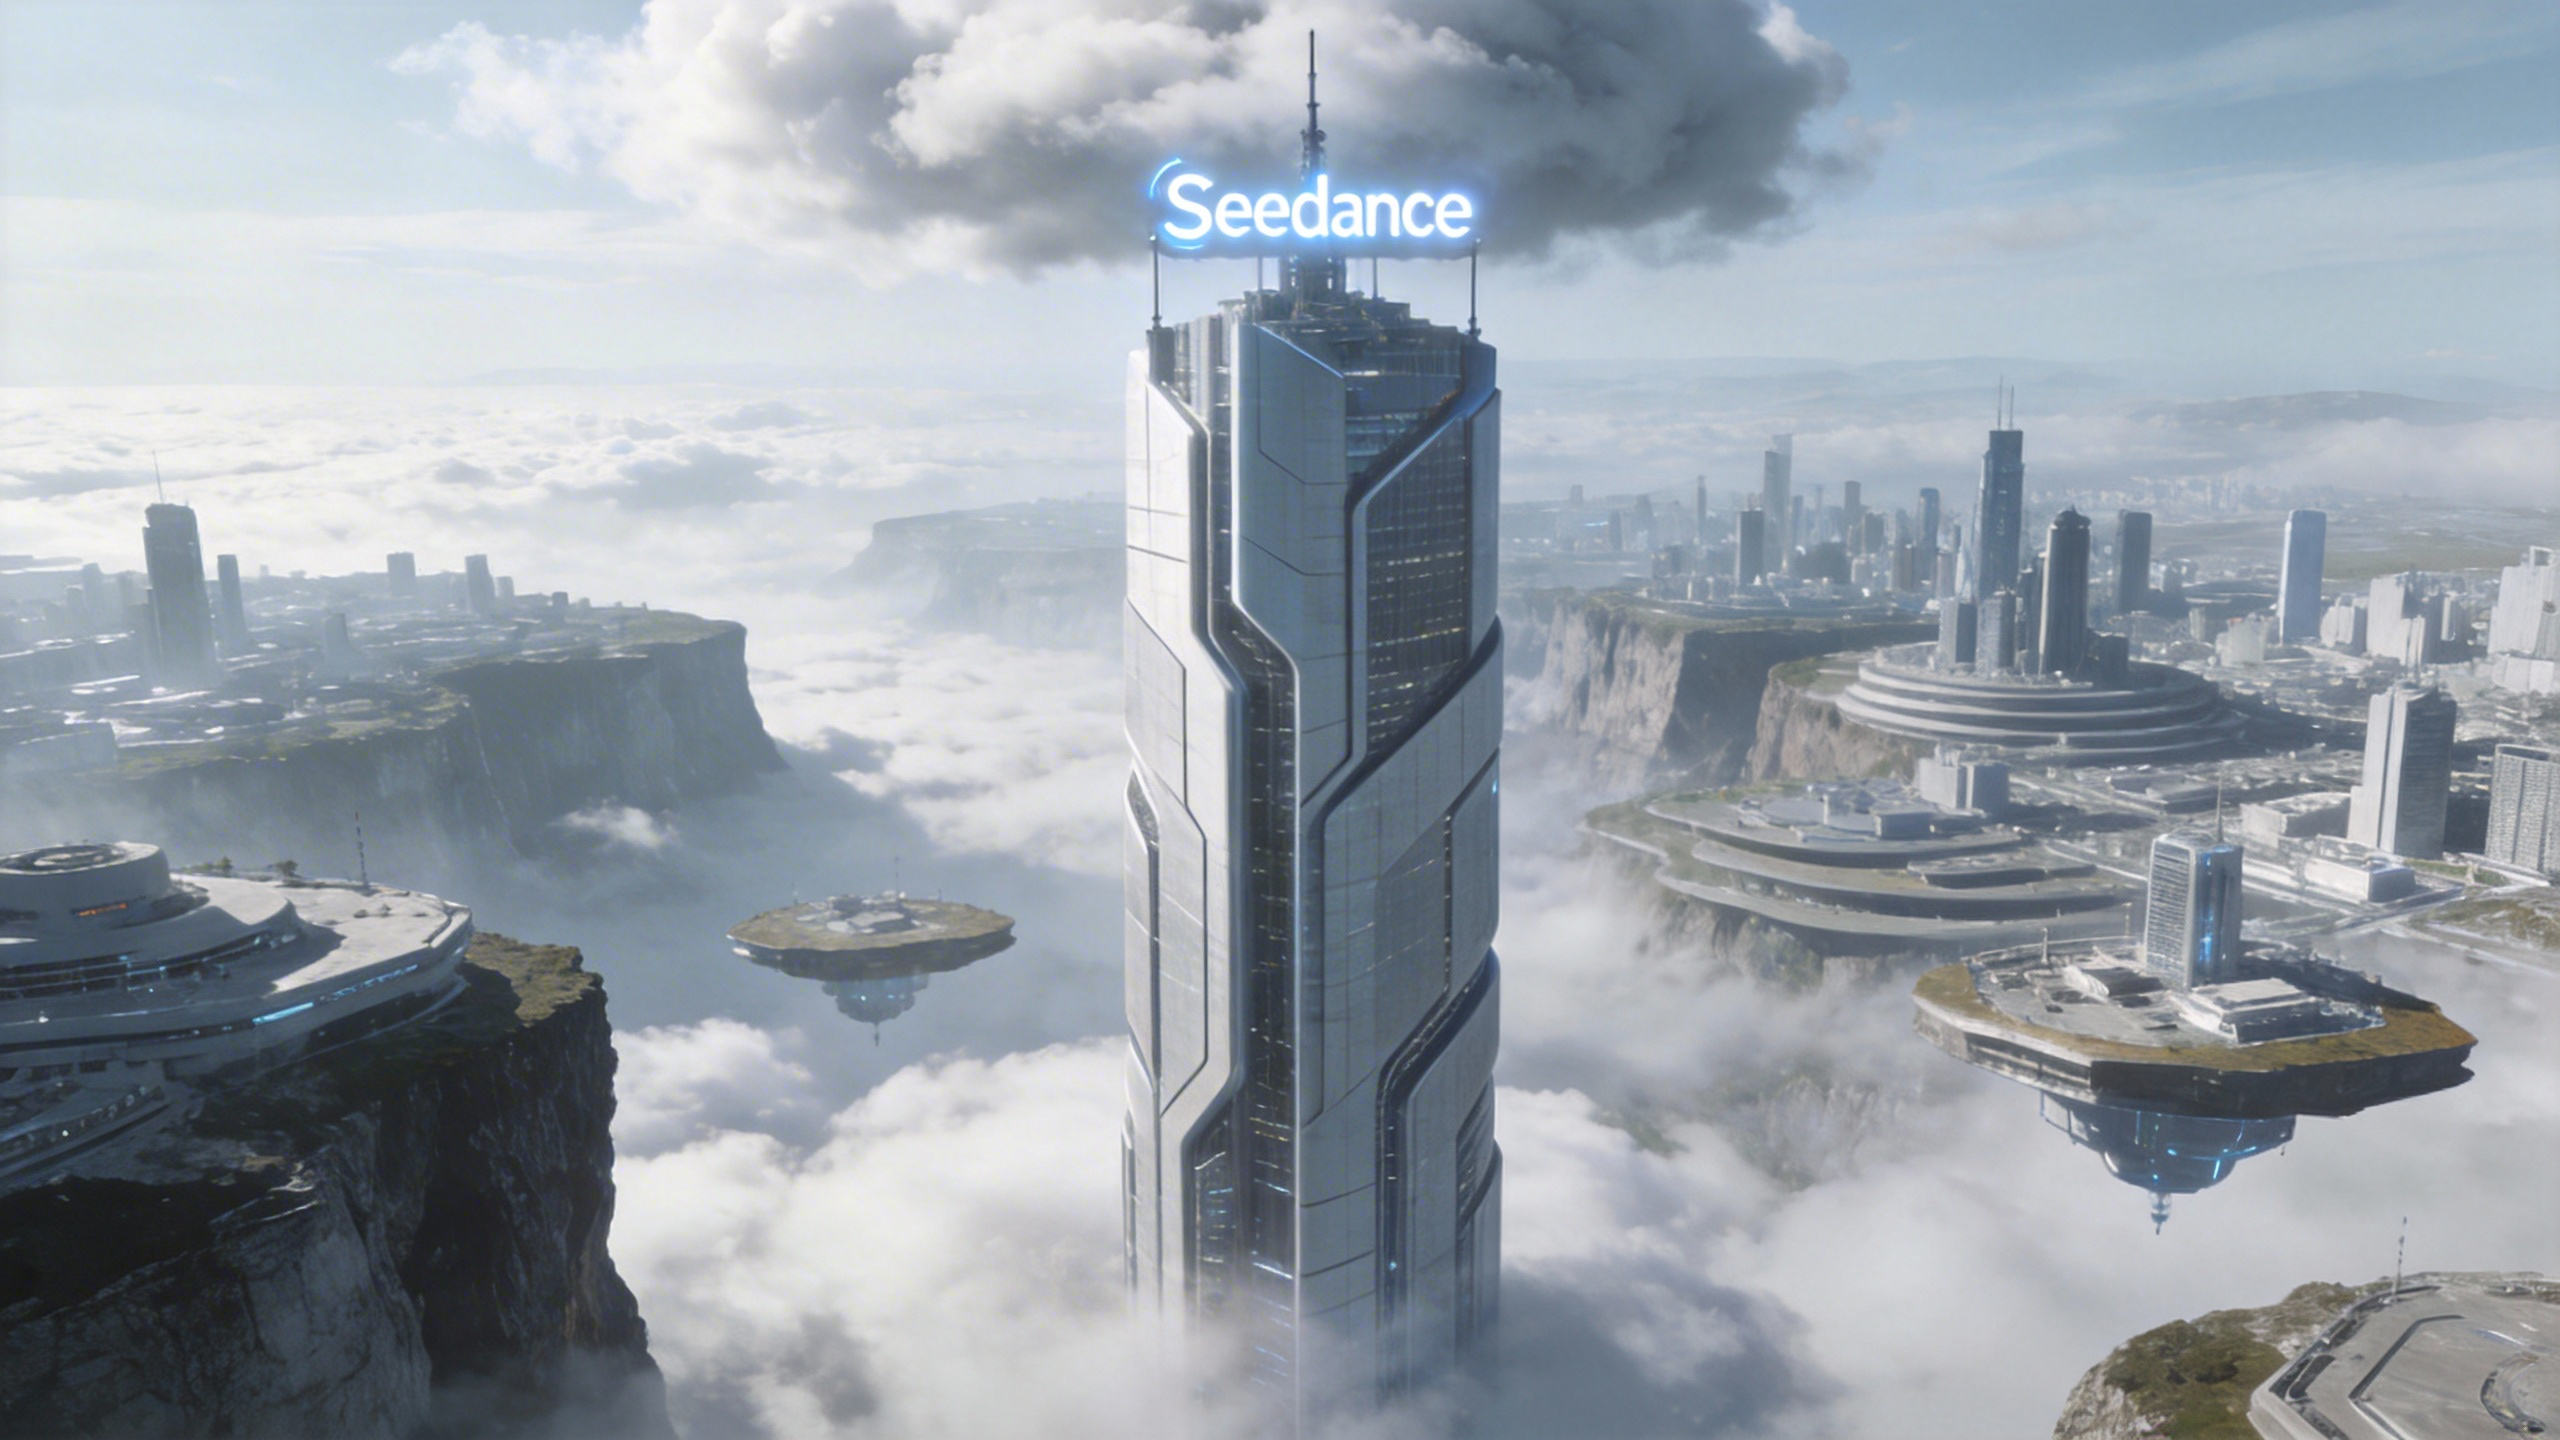
@Image1
@Video1
พรอมต์
Referring to the camera movement in @Video1, create a concept video for a science and technology park, with the tall building in @Image1 as the visual center, also using a first-person diving perspective, to reflect the sense of technology in the park from @Image1.
การอ้างอิงเอฟเฟกต์พิเศษ
อ้างอิงเอฟเฟกต์พิเศษในวิดีโอ แล้วนำเอฟเฟกต์ เส้นทาง และลำดับเดียวกันนั้นไปใช้กับตัวละครในภาพ
สื่ออ้างอิง
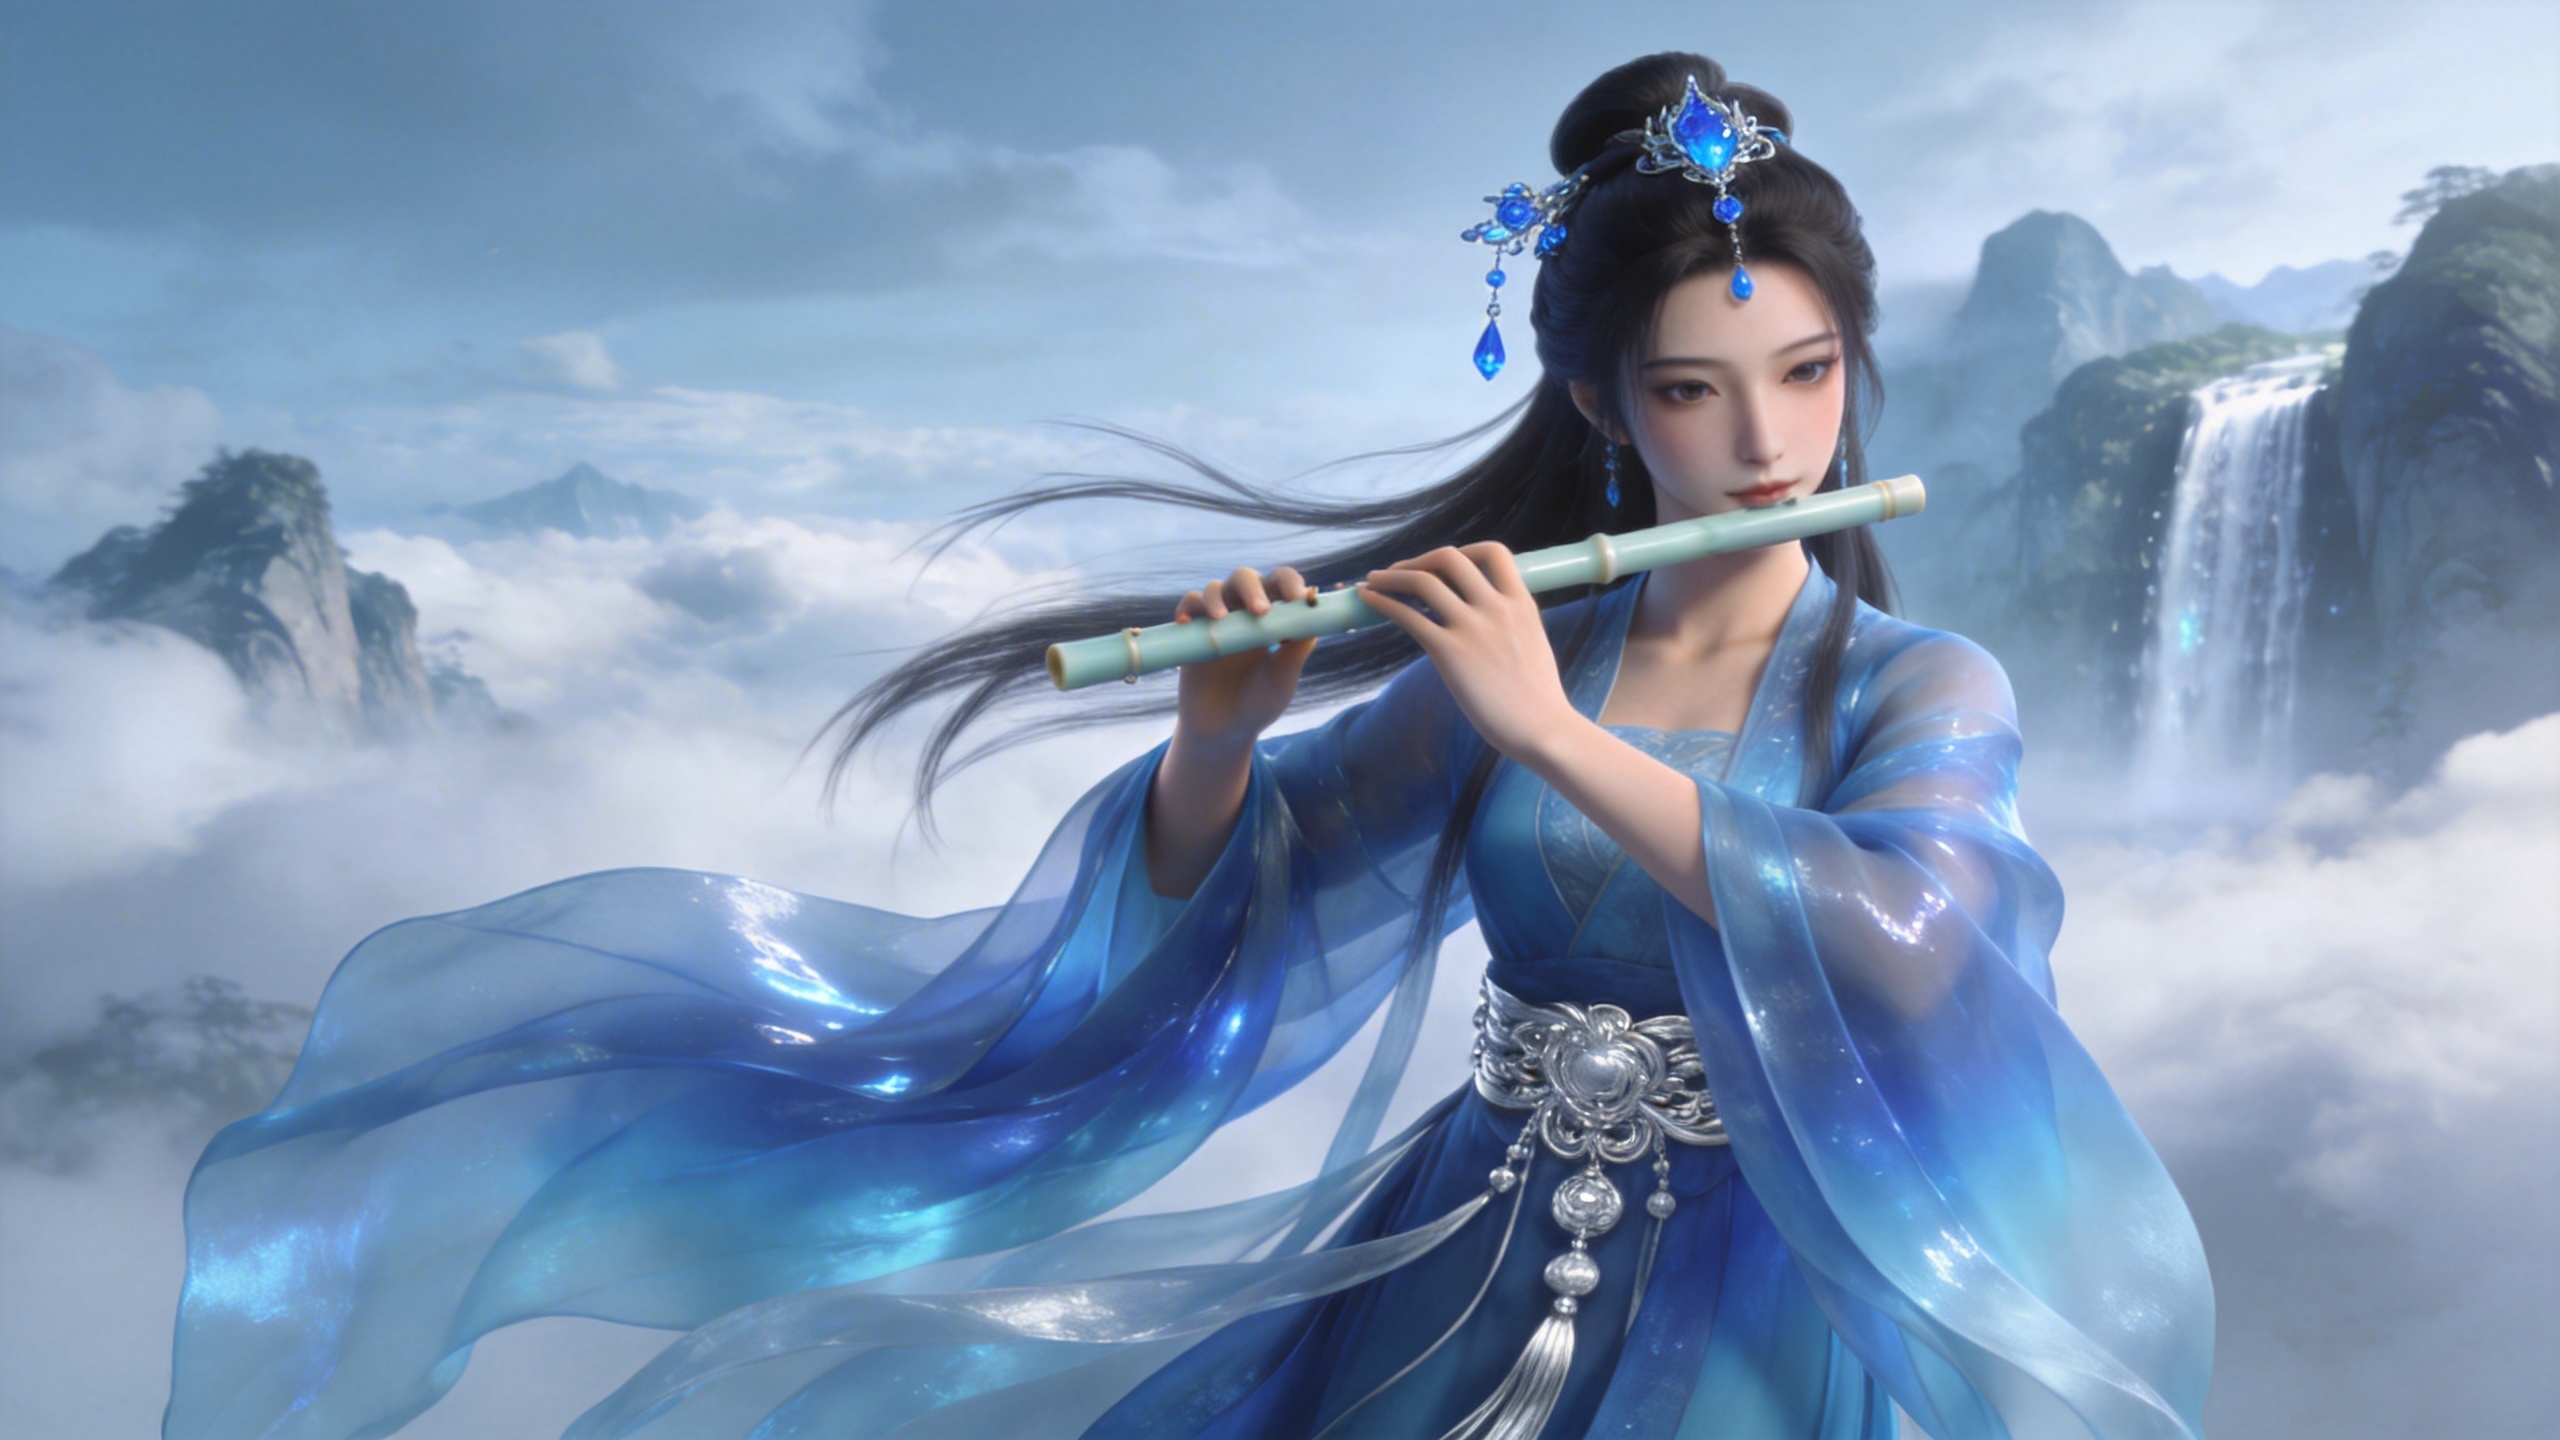
@Image1
@Video1
พรอมต์
Refer to the golden particle effects in @Video1, so that when the character in @Image1 plays the flute, the same particle effects surround their body.
สื่ออ้างอิง
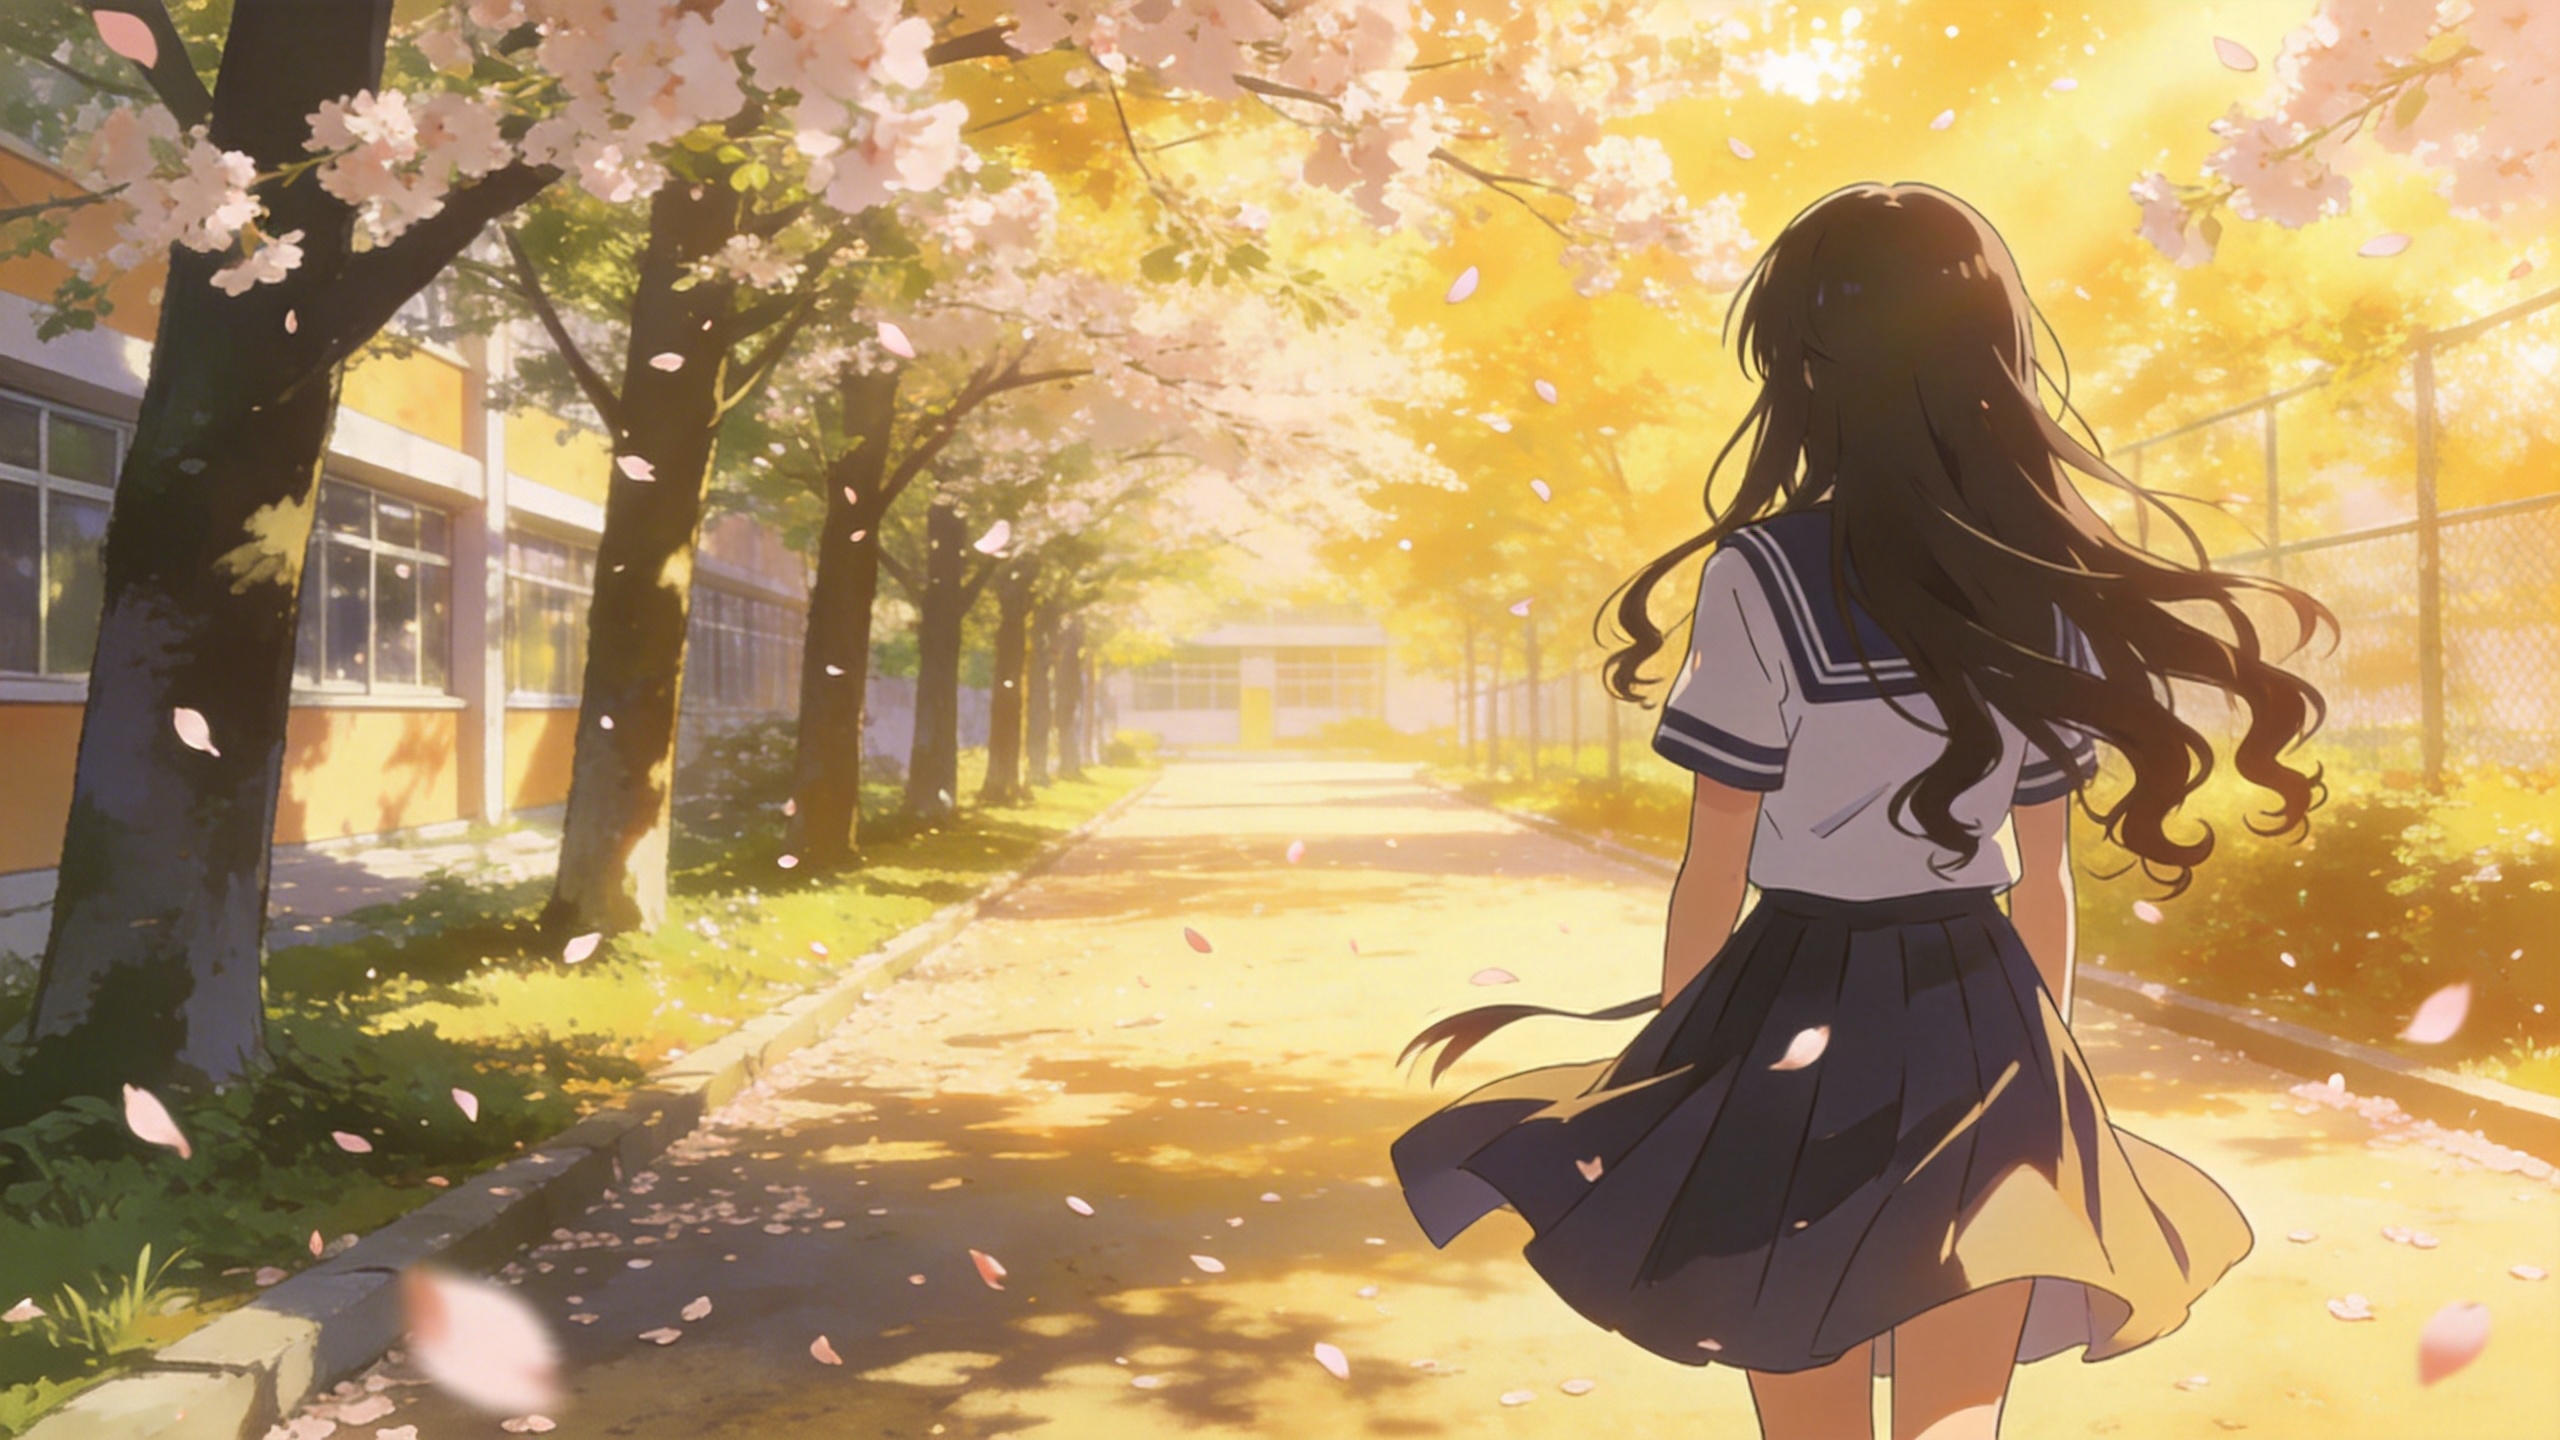
@Image1
@Video1
พรอมต์
Refer to the special effects shown in @Video1 to generate identical wings for the girl in @Image1, ensuring the wing formation trajectory follows the exact same motion path and sequence depicted in the video.
การเพิ่ม การเอาออก หรือการแก้องค์ประกอบ
เพิ่ม เอาออก หรือแทนที่ สำหรับการแก้ไข อย่าเขียน "reference" ส่วนที่ไม่ได้กล่าวถึงคงเดิม
สื่ออ้างอิง
@Video1
พรอมต์
Add snacks such as fried chicken and pizza to the countertop in @Video1.
สื่ออ้างอิง
@Video1
พรอมต์
Remove everything that isn't office supplies from the table in @Video1, keeping the rest of the video content unchanged.
สื่ออ้างอิง
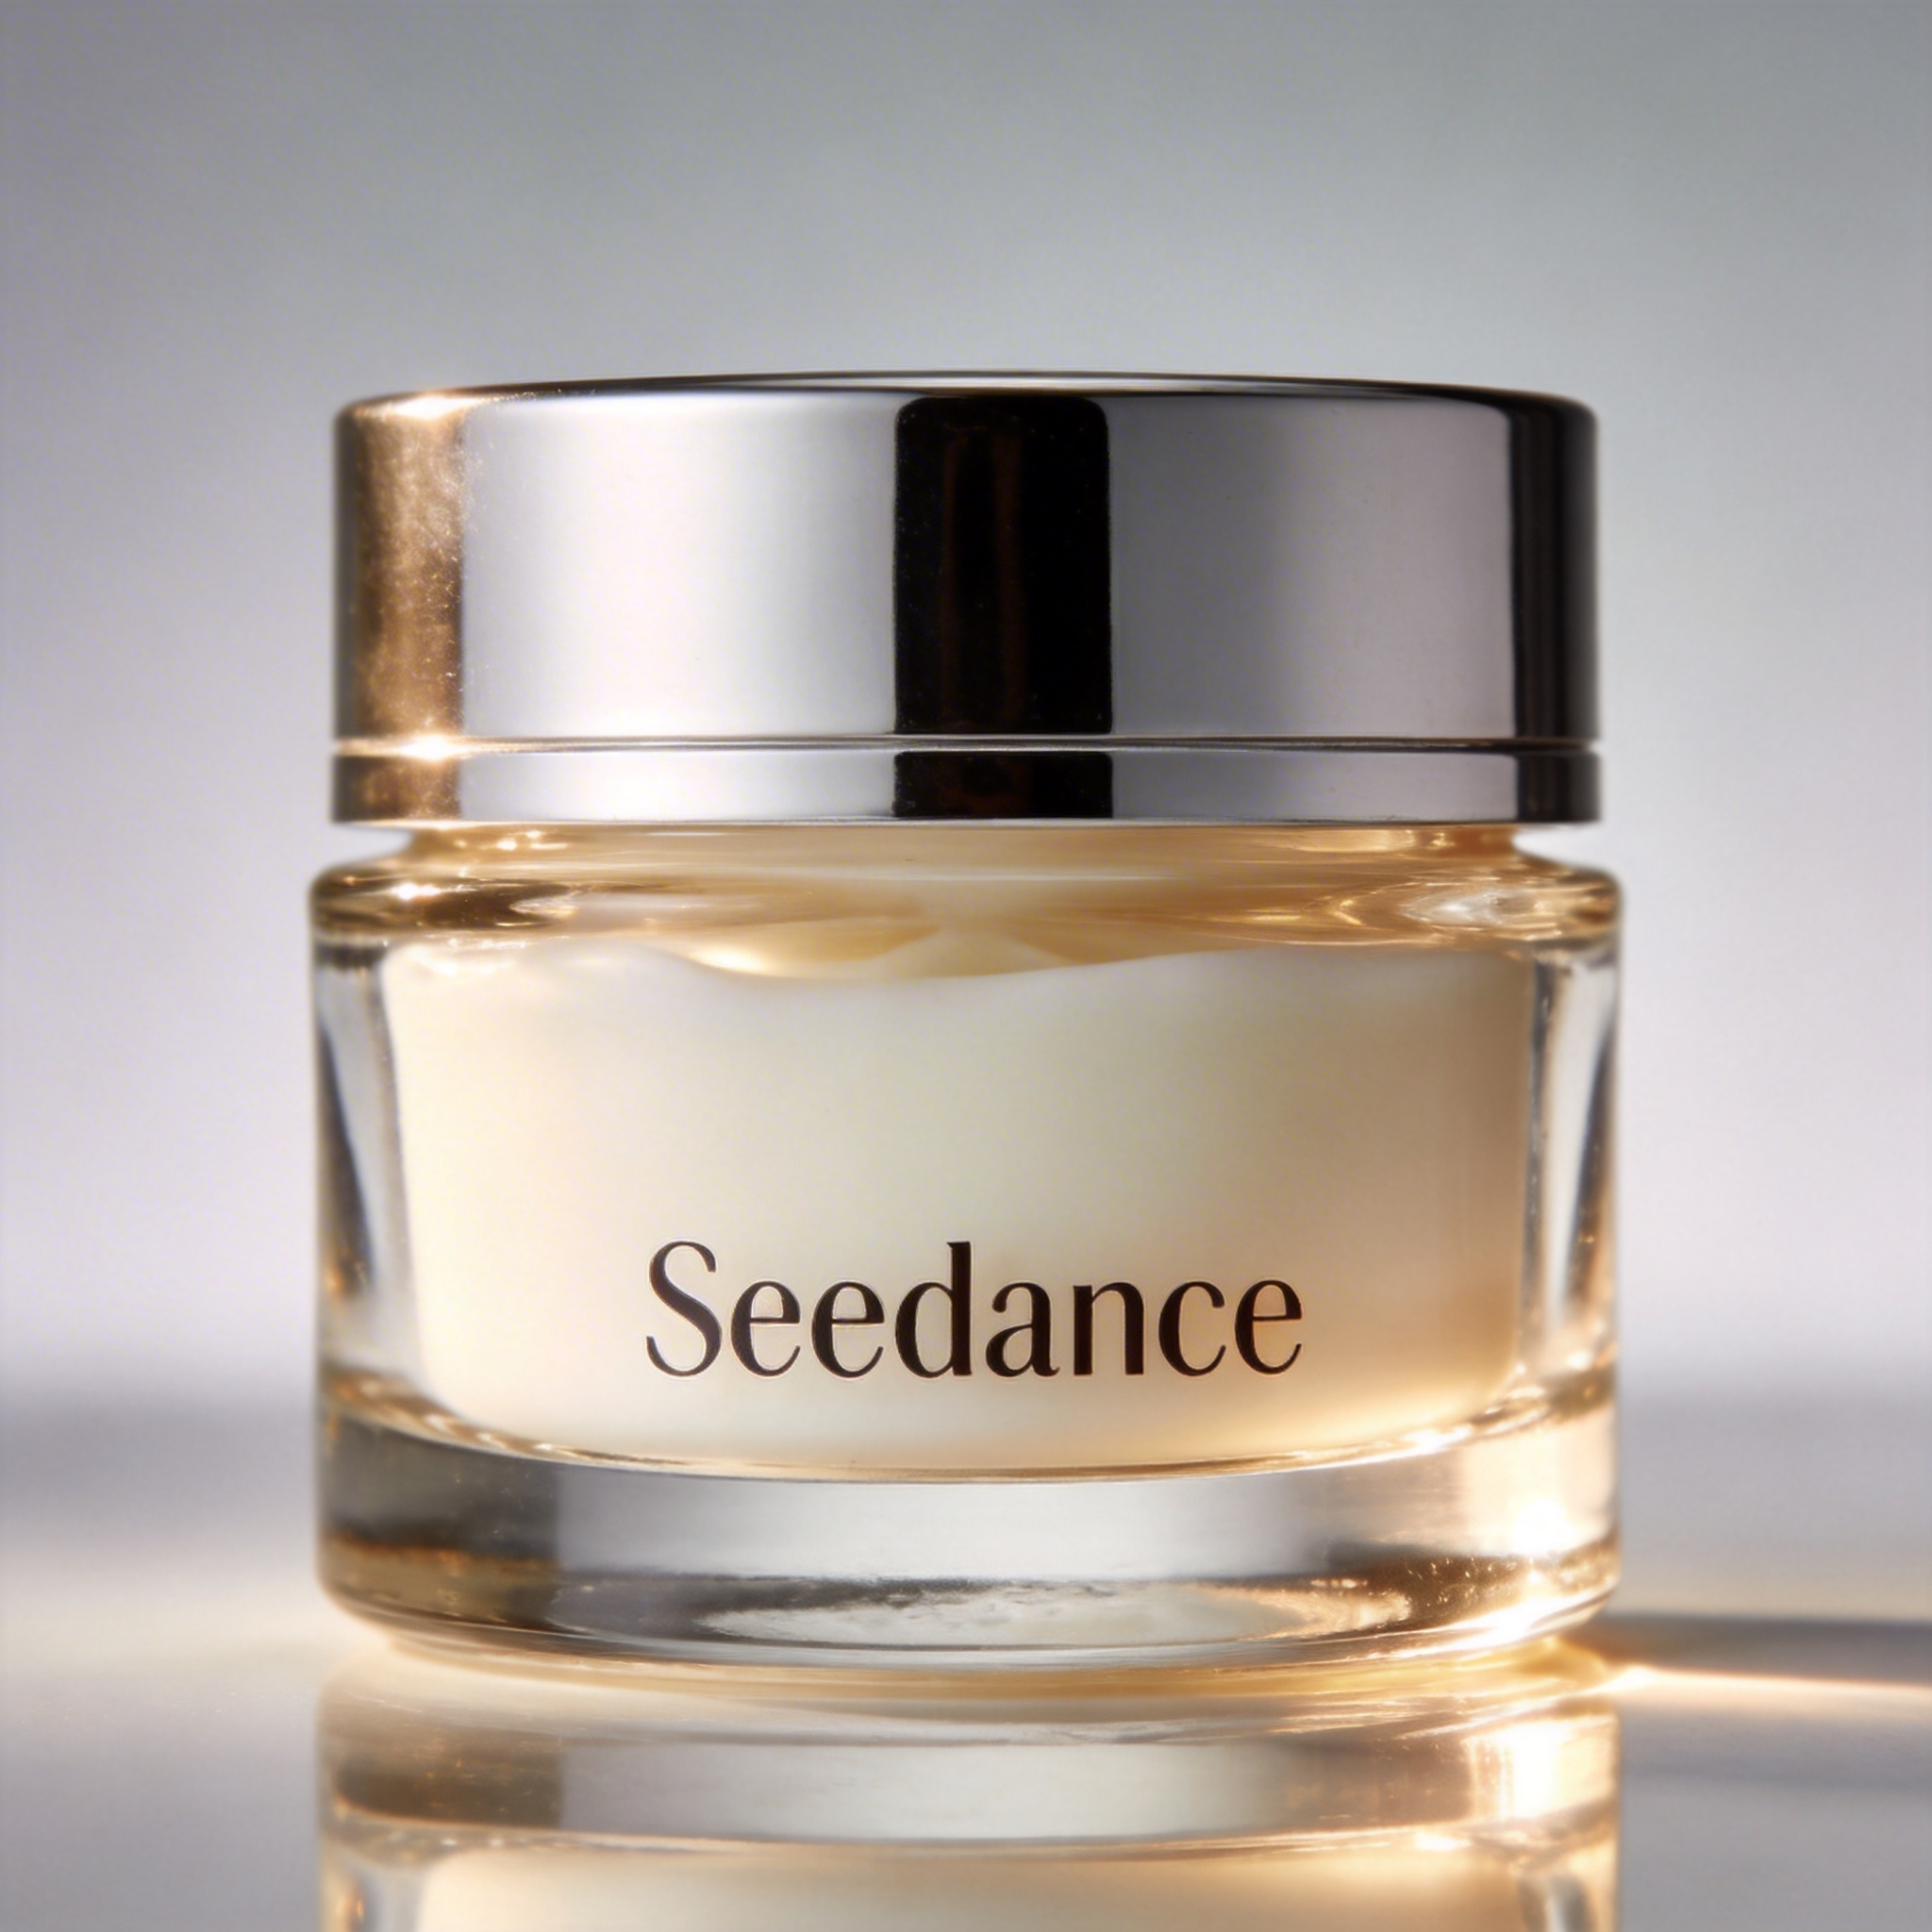
@Image1
@Video1
พรอมต์
Replace the perfume featured in @Video1 with the face cream from @Image1, with all original motions and camera work preserved.
การขยายวิดีโอ
การขยายไปข้างหน้าสร้างเนื้อหาหลังวิดีโอ การขยายย้อนกลับขยายช่วงเปิดของวิดีโอ
สื่ออ้างอิง
@Video1
พรอมต์
Generate the content after @Video1: the two men who are late run towards them, the five people finally meet and have a friendly chat.
สื่ออ้างอิง
@Video1
พรอมต์
Extend the opening segment of @Video1: Set up an over-the-shoulder shot of the man in a hoodie, and the man says: "It's not that bad. You're just stressed. Everyone goes through this, you just need to keep going."
การเติมแทร็กให้ครบ
@Video1 แล้วสะพาน ตามด้วย @Video2
สื่ออ้างอิง
@Video1
@Video2
พรอมต์
@Video1. The moment a leaf falls to the ground, it sets off a special effect of golden particles. A gust of wind blows by, leading into @Video2.
ขีดจำกัดโดยย่อ
| ตระกูล Seedance 2.0 | |
|---|---|
| ภาพอ้างอิง | สูงสุด 9 |
| วิดีโออ้างอิง | สูงสุด 3 ชิ้น ชิ้นละ 2–15 วินาที รวม 15 วินาที |
| เสียงอ้างอิง | สูงสุด 3 ชิ้น ชิ้นละ 2–15 วินาที รวม 15 วินาที |
| ความยาวเอาต์พุต | 4–15 วินาที |
| ความละเอียดเอาต์พุต | 2.0: 480p–4K; Fast และ Mini: 480p / 720p |
วิดีโออ้างอิงควรเป็น 480p หรือ 720p ที่ 24–60 fps