이 가이드는 공식 기준을 바탕으로 하고, 그 위에 보충 설명을 더했습니다. Seedance 2.0 시리즈(2.0, 2.0 Fast, 2.0 Mini)에 해당합니다. 프롬프트를 잘 써야 Seedance의 효과가 나옵니다.
기본 공식
Seedance 2.0 시리즈 모델은 동영상, 이미지, 오디오 같은 멀티모달 에셋을 동시에 참조할 수 있습니다. 캐릭터 외형, 동작 효과, 시각 스타일, 내레이션 음색 같은 특성을 정확하게 고정할 수 있어, 프롬프트를 쓰는 문턱을 크게 낮춥니다. 이를 바탕으로 단순한 기본 공식으로 모델을 이끌고, 멀티모달 에셋의 특성을 써서 특정 요건을 만족하는 동영상을 빠르게 생성합니다.
참조 기반 동영상 생성은 세 가지 작업으로 나뉩니다. 옴니 레퍼런스(omni reference), 동영상 편집, 동영상 연장입니다. 작업 종류에 맞춰 기본 프롬프트 공식을 고릅니다. 세 가지는 함께 쓸 수도 있습니다.
옴니 레퍼런스(omni reference)
에셋에서 일부 요소(피사체, 스타일, 장면, 효과음 등)를 꺼내 완전히 새로운 동영상을 생성합니다.
해당하는 상황: 동작 옮기기, 피사체 재사용, 분위기 참조, 그리고 비슷한 작업.
권장 패턴:
- 이미지 참조:
@Image1의 피사체를 참조해 생성… - 동영상 참조:
@Video1의 움직임을 참조해 생성… - 오디오 참조:
@Audio1의 음색을 참조해 생성…
이 스튜디오에서 옴니 레퍼런스(omni reference)는 멀티 레퍼런스입니다. 프롬프트 칸에서 **@**를 입력하고 파일을 고릅니다. 삽입되는 것은 @Image1, @Video1, @Audio1이며, 그 종류 안에서의 업로드 순서로 번호가 붙습니다. 각 썸네일에는 그 토큰이 표시됩니다. 파일을 빼면 그 종류에 남은 토큰은 번호가 다시 매겨집니다. 위의 패턴에서는 어떤 요소를 가져오는지 여전히 적어야 합니다. 토큰만으로는 얼굴인지, 움직임인지, 스타일인지, 음색인지를 모델이 알지 못합니다.
동영상 편집
원본 동영상을 바탕으로 부분 수정 또는 전체 수정을 합니다. 언급하지 않은 부분은 기본적으로 그대로 남습니다.
해당하는 상황: 국소 교체, 피사체 제거, 속성 변경, 그리고 비슷한 작업.
권장 패턴:
- 요소 추가:
@Video1과 새 요소와 그것이 놓일 위치를 분명히 적습니다. - 요소 변경:
@Video1을 엄격히 편집하고, 그 안의 한 요소를 다른 것으로 바꿉니다. - 요소 삭제: 삭제해야 할 요소를 지정합니다. 바꾸지 않고 남아야 할 요소는, 성능을 높이려면 프롬프트 안에서 강조합니다.
동영상 연장
시간 차원을 따라 원본 동영상을 이어 갑니다. 영상과 오디오의 스타일, 피사체, 서사가 일관되게 남을 것을 요구합니다.
해당하는 상황: 줄거리 이어 가기, 동작 연장, 클립 완성, 그리고 비슷한 작업.
권장 패턴:
- 동영상 연장:
@Video1을 앞 방향 또는 뒤 방향으로 연장해 생성… - 트랙 완성:
@Video1과 그곳에서 일어나는 일, 이어서@Video2와 그다음에 일어나는 일.
편집과 연장 작업에서는 동영상을 직접 가리킵니다. "strictly edit @Video1", "extend @Video1 forward". 이 작업들에 "reference @Video1"라고 쓰지 마세요. "Reference"는 옴니 레퍼런스(omni reference) 패턴이며, 모델은 편집이나 연장을 완전히 새로운 클립으로 잘못 읽을 수 있습니다.
이미지 → 동영상은 별도의 모드입니다. 첫 프레임과 마지막 프레임은 한 번의 생성에서 레퍼런스 파일과 섞을 수 없습니다. 첫 프레임이 시작이며, 화면 비율은 그 이미지를 따릅니다. 끝 프레임도 고정해야 할 때는 마지막 프레임 추가를 켜고, 두 프레임 사이에서 일어나는 일만 적습니다. 생성하기 전에 마지막 프레임 반환을 켭니다. 클립이 준비되면 이어서 생성은 그 최종 프레임을 다음 클립의 첫 프레임으로 쓰므로, 이음새는 한 장의 그림에 고정됩니다. 이것이 이 스튜디오에서 프레임을 고정해 이어 가는 방법입니다. 소스가 멀티 레퍼런스 안의 동영상일 때는 공식 연장 공식이 그대로 적용됩니다.
결합 작업
위의 세 가지 작업은 함께 쓸 수도 있습니다.
해당하는 상황: 한 에셋을 참조하고 다른 에셋을 편집합니다.
권장 문장 패턴: @Video1의 [참조 차원]을 참조하고, @Video2를 엄격히 편집한다, [구체적 편집].
[참조 차원]은 첫 파일에서 가져오는 한 가지, 예를 들어 카메라 움직임, 효과, 음색입니다. [구체적 편집]은 두 번째 파일에 넣고 싶은 유일한 변경입니다. 편집에서 이름을 적지 않은 것은 모두 그대로 남습니다.
고급 공식
Seedance 2.0은 본질적으로 멀티모달 AI 감독입니다. 텍스트 프롬프트, 이미지, 동영상, 오디오를 동시에 읽고, 내부에서 두 차원, 프레임 안에 무엇이 있는지를 다루는 공간 레이어(spatial layer)와 시간에 따라 일이 어떻게 바뀌는지를 다루는 시간 레이어(temporal layer)로 나누어 영상을 이해하고 생성합니다.
좋은 프롬프트는 단순한 카피 문장식 묘사가 아니라 공학식 지시입니다. 누가, 어떤 장면에서, 어떤 동작을 하고, 카메라가 어떻게 움직이며, 사건이 어떤 시간 순서로 일어나는지가 각각 공간 레이어(spatial layer)와 시간 레이어(temporal layer)로 전달됩니다.
1. 피사체 정의하기
실제로 참조하는 에셋에서는 이미지 한 장에 피사체가 여러 개 들어 있는 경우가 많습니다. 에셋 안의 특정 대상을 정확하게 참조하려면 피사체를 분명히 정의해야 합니다. 피사체는 사람, 소품, 장면 등입니다.
기본 정의
핵심 특징의 요건: 분명하고 안정된 정적 특징 2~3개(옷, 머리 모양, 외모, 범주 등)로 피사체를 묘사해, 유일하게 식별할 수 있게 합니다.
예:
@Image1에서 빨간 드레스와 밀짚모자를 쓴 여성을 피사체 1로 정의한다.@Image1에서 빨간 드레스와 밀짚모자를 쓴 여성을 Zhang Hong으로 정의한다.
여러 자료에 걸친 단일 피사체
여러 에셋 안의 대상이 같은 피사체를 가리킬 때는 일관되게 묶습니다. @Image1의 얼굴과 @Image2의 전신 사진이 같은 사람이라고 쓰세요.
다중 피사체 장면
동영상에 피사체가 여러 명 나올 때는 따로 정의하고 라벨로 구분합니다. 라벨은 고유하고 안정되어야 하며, 이후 묘사에서도 대응하는 라벨을 일관되게 써서 참조의 모호함을 피합니다.
예: @Video1의 키 큰 남성을 경찰관으로 정의하고, 다른 키 작은 남성을 도둑으로 정의한다. 장면은 사람으로 붐비는 낮의 시장이다. 밝은 햇빛, 많은 과일 좌판, 빽빽한 행인 통행이 있어 활기찬 거리 시장의 분위기를 만든다. 도둑은 붐비는 시장을 당황한 채로 앞으로 달리고, 경찰관은 전속력으로 바로 뒤를 쫓는다. 둘은 좌판 사이를 빠르게 빠져나간다. 핸드헬드 카메라가 빠르게 앞을 따라가며, 약간의 사실적인 카메라 흔들림이 있어 긴장된 추격 분위기를 만든다.
피사체가 관여할 때마다, 빠뜨리지 않도록 명시적으로 가리켜야 합니다. 두 가지 쓰임이 있습니다.
- 피사체를 정의하지 않은 단순한 장면에서는, 피사체를 언급할 때마다 @를 써서 피사체와 에셋의 묶음을 강조합니다. 예: Zhang San
@Image1. - 피사체를 미리 정의한 장면에서는, 피사체를 언급할 때마다 같은 라벨을 씁니다.
@Video1의 키 큰 남성을 경찰관으로, 키 작은 남성을 도둑으로 정의한 뒤, 이후 문장에서는 경찰관과 도둑이라고 말하고 "the tall one"과 "the other man"이라고 말하지 않습니다.
에셋 라이브러리 id를 쓸 때도 피사체를 가리키려면 @Image1 또는 @Video1이 필요합니다. 모델은 에셋 id를 참조 내용과 직접 연결하지 못하므로, 파일 토큰 대신 에셋 id를 쓰면 안 됩니다.
묘사는 가능한 한 간결하게 하고, 중복을 피하며, 같은 피사체에 모순되는 특징 같은 의미 충돌을 피합니다. 공간 관계는 먼저 참조 이미지로 나타내고, 복잡한 텍스트 묘사를 줄입니다.
사람이라면 헤드샷과 전신 사진이면 충분합니다. 여기서는 멀티 뷰(multi-view) 캐릭터 이미지를 권하지 않습니다. 턴어라운드 시트(three-view)는 ID 드리프트(ID drift)의 흔한 원인이기 때문입니다.
2. 샷 순서 정하기
모델 내부의 모델링은 공간과 시간을 분리합니다. 따라서 복잡한 동영상에 이상적인 프롬프트 형태는 타임라인에 기반한 스토리보드입니다. 동영상을 여러 샷으로 나누고, 사건이 일어나는 순서대로 각 샷을 동적으로 묘사합니다. 누가 + 어디에서 + 무엇을 하며 + 카메라가 어떻게 움직이는지.
샷 순서를 씁니다. 동영상의 각 구간에 단순한 Shot 1 / Shot 2 / Shot 3 스토리보드를 쓰고, 그것들을 하나의 완전한 프롬프트로 합칩니다.
부정 예: "A man runs nervously down the street, and the scene feels very cinematic."
긍정 예:
- Shot 1: 골목의 옆 샷. 남성이 천천히 달리기 시작하고, 호흡이 빨라지는 느낌이 있다.
- Shot 2: 남성이 과일 좌판을 넘어뜨린다. 카메라가 빠르게 흔들리며 남성의 겁에 질린 얼굴을 클로즈업한다.
- Shot 3: 남성이 낮은 담을 넘어 사라진다. 카메라는 천천히 빠지며 빈 거리에서 멈춘다.
Shot 1, Shot 2, Shot 3 같은 식별자를 써서, 사건이 일어나는 순서대로, 주된 것을 먼저, 부차적인 것을 나중에 내용을 정리합니다. 각 구간의 길이에 엄격한 제한을 두지 마세요. 줄거리에 따라 모델이 자연스럽게 호흡을 생성하도록 두는 것을 우선합니다. 0~3초 같은 정밀한 타이밍에 대한 모델의 지원은 불안정하며, 길이를 억지로 제한하면 생성 결과가 비정상으로 이어질 수 있습니다.
각 샷을 이 순서로 정리합니다.
- 카메라 움직임 또는 샷 전환 방식. 예를 들어 "slowly push in from a wide shot", "fixed camera position", "cut to…".
- 피사체의 동작과 표정. 중심이 되는 인물이나 사물의 주요 동작과 표정의 변화를 적습니다.
- 위치 또는 공간의 변화. 피사체가 있는 장면, 위치, 공간 관계를 설명합니다.
- 오디오 정보. 그 샷에 대응하는 효과음, 목소리, 배경 음악을 적습니다.
3. 동작 묘사 요건
신체 움직임의 정밀화 + 정도의 수량화. 동작은 손, 다리, 머리, 어깨, 등 같은 신체 부위까지 구체적으로 하고, 동시에 범위, 속도, 힘의 묘사를 보충합니다. 예: 손을 천천히 들기, 머리를 빠르게 돌리기, 땅을 세게 밀어 차기, 머리를 약간 숙이기.
느리고 부드러우며 연속된 작은 움직임을 우선한다. 느리고 부드러우며 이어지는 미세한 움직임을 우선하고, 전력 질주, 큰 점프, 격한 구르기처럼 폭발적이고 다이내믹이 큰 동작은 피하도록 합니다. 예: 천천히 걷기, 손을 부드럽게 들기, 머리를 약간 숙이기, 동작에 실려 자연스럽게 앉기.
동작과 동작 사이의 전환을 보충한다. 앞뒤 동작 사이의 관성과 연속성을 지정해, 화면 위의 움직임이 이어지고 자연스럽도록 합니다. 예: 돌아서는 관성을 이용해 자연스럽게 손을 들기, 멈춤에서 손을 드는 움직임으로 자연스럽게 넘어가기.
감정의 구체적인 외면화. 구체적인 신체의 세부로 감정을 나타내고, "very sad"나 "extremely angry." 같은 추상적인 말을 대체합니다.
| 추상적 감정 | 동작과 세부로 외면화 |
|---|---|
| 슬픔 | 고개를 숙임, 어깨가 약간 떨림, 눈이 붉어짐, 손가락이 무의식적으로 옷자락을 쥠, 눈물이 눈에 고이지만 떨어지지 않음 |
| 기쁨 | 입꼬리가 참지 못하고 올라감, 눈썹과 눈이 풀림, 발걸음이 가벼워짐, 무의식적으로 콧노래를 부름, 제자리에서 도는 것을 참지 못함 |
| 긴장 / 불안 | 시계를 자주 확인함, 손가락이 끊임없이 탁자를 두드림, 호흡이 빠름, 눈이 시선을 피함, 무의식적으로 손톱을 깨묾 |
| 분노 | 두 주먹을 쥠, 턱선이 긴장함, 가슴이 격하게 오르내림, 눈이 칼처럼 날카로움, 이를 악물고 말을 짜냄 |
| 안도 | 긴 숨을 내쉼, 긴장했던 어깨가 완전히 풀림, 오래간만의 희미한 미소가 얼굴에 나타남, 먼 곳을 올려다봄 |
4. 카메라 움직임 프롬프트
모델은 카메라 움직임 용어를 강하게 이해하므로, 표준 카메라 용어를 직접 쓸 수 있습니다. 예를 들어 "medium shot, close-up, wide shot, slow push-in, smooth lateral tracking, fixed shot."입니다.
한 샷에서는 카메라 움직임을 한 가지만 지정하도록 합니다. 밀기, 당기기, 팬, 이동을 동시에 요구하지 마세요. 화면의 불안정이 커집니다.
5. 화질, 스타일, 제약어
화질, 스타일, 제약어는 동영상 생성 결과를 제어하는 열쇠입니다. 모델에 창작의 경계를 정하고, 화질과 예술적 색조를 통일하며, 시각적 결함과 무작위 이탈을 피할 수 있습니다. 안정되고 요건에 맞는 최종 출력을 확보하는 데 필요한 설정입니다.
- 화질. 이미지의 선명도, 세부의 질감, 조명의 질을 정해 최종 동영상의 기초 화질을 높입니다. 예: HD, 풍부한 세부, 영화적 질감, 자연스러운 색, 부드러운 조명.
- 스타일. 전체 화풍과 시각적 색조를 설정해 이미지의 예술적 분위기를 통일합니다. 예: 사이버펑크의 차가운 청보라 톤, 레트로 필름, 산뜻한 일본풍.
- 제약어. 제약어는 매우 중요합니다. 시각적 결함, 변형, 붕괴, 불합리한 요소를 효과적으로 피하고, 생성의 경계와 안정성을 제약합니다.
자주 쓰는 제약어 템플릿:
- 자막 생성을 피하기: "keep it subtitle-free", "avoid generating any text or subtitles".
- 로고 생성을 피하기: "do not generate a logo".
- 워터마크 생성을 피하기: "do not generate a watermark".
6. 사례
다음 두 예는 위의 고급 공식을 어떻게 쓰는지 보여 줍니다. 대사는 {} 안에 둡니다. 이것은 특수 문자 기준에 있는 대화 표시입니다.
예 1: 기숙사 감정 단편(대화 중심)
에셋 준비:
@Image1: 여성 주인공의 반신 사진@Image2: 기숙사 장면 참조 이미지@Video1: 실내 대화용 카메라 움직임 참조(미디엄 샷 달리 인/아웃, 또는 약간의 팬)@Audio1: 실내 환경음, 또는 가벼운 음악
Use the girl in @Image1 as the main character, use @Image2 as the dormitory scene style reference, and refer to the camera movement in @Video1.

Shot 1: At dusk, girl @Image1 walks briskly to the dormitory entrance @Image2. The camera follows steadily in a medium shot. Warm yellow sunlight spills into the hallway from the window. She pauses at the doorway, takes a deep breath, and looks slightly nervous.

Shot 2: Girl @Image1 pushes the door open and enters the dormitory. The camera cuts to an indoor medium shot. Her roommates look up at her while organizing their books. One of them smiles and asks {How did the exam go? Did you pass?}. The camera slowly cuts between half-body close-ups of several people.

Shot 3: Girl @Image1 first lowers her head with a dejected expression. The camera gives her a close-up. Then she raises her head, unable to hold back a smile, laughs out loud, and says {I was kidding}. Her roommates start chasing and play-fighting with her. The camera slowly pulls back and freezes on a wide shot of the dormitory filled with laughter.

The entire video should have a high-definition cinematic documentary style, with warm tones and soft lighting. The character's face remains stable without deformation; movements are natural and smooth, with no stutter or flicker. The ambient sound blends naturally with @Audio1.
예 2: 고풍 절벽 대치(액션/분위기 중심)
에셋 준비:
@Image1: 붉은 옷의 여성 주인공@Image2: 검은 옷의 자객(상대)@Image3: 절벽과 대나무 숲 장면 이미지@Video1: 무술 대치용 카메라 움직임 참조@Audio1: 촘촘한 북소리, 또는 격투 효과음
Use the woman in red from @Image1 as the female lead, use the woman in black from @Image2 as the opponent, use the cliff and bamboo forest environment in @Image3 as the scene reference, refer to the overall camera movement and action rhythm in @Video1, and synchronize the background sound effects with @Audio1.

Shot 1: At dusk, the camera slowly pushes in from a side medium shot of woman in red @Image1. She stands at the edge of the cliff and lifts a wine flask to drink. Her sleeves and robe hem sway gently in the mountain wind. The camera circles halfway around her, moving from the front to her back. In the distance, a figure in black is faintly visible in the bamboo forest.

Shot 2: The camera zooms and fades into a long shot. From a drone perspective, it overlooks the entire cliff and bamboo forest. The two characters stand at opposite ends of the cliff. The mountain wind lifts their robe hems and dust, and the rhythm slightly accelerates with the drum beats.

Shot 3: The camera cuts back to a ground-level close shot. The two slowly draw their swords and face off. Woman in red @Image1 shifts from a careless expression to a cold gaze. Woman in black @Image2 looks determined, and the sword tip trembles slightly. The camera steadily follows the two as they circle each other, finally freezing on a close-up of the instant before the two swords meet.

The overall visual style should feel like a cinematic wuxia world in misty rain, with cool tones, low saturation, a film-grain texture, and rich light-and-shadow layers. The characters' faces and body proportions remain stable without deformation. Movements are continuous and natural, not stiff, with no clipping or stutter.
그 밖의 요령
텍스트 생성
Seedance 2.0 시리즈 모델은 흔한 텍스트 생성을 지원합니다. 모델은 문맥에 따라 적절한 스타일과 색을 자동으로 맞출 수 있고, 프롬프트 안에서 텍스트의 색, 스타일, 나타나는 방식, 나타나는 타이밍, 나타나는 위치를 지정하는 것도 지원합니다. 쓸 때는 흔한 글자를 우선하고, 드문 글자와 특수 기호를 피해 가장 좋은 표시를 확보합니다. 현재 광고 슬로건, 자막, 말풍선 같은 장면을 지원합니다. 사례는 마지막 절에 있습니다.
슬로건 프롬프트 템플릿: [텍스트 내용] + [타이밍] + [배치] + [등장/나타나는 방식], [시각 속성(색, 글꼴 스타일)].
Seedance 2.0은 문맥에 따라 적절한 텍스트 스타일을 맞출 수 있습니다. 텍스트 표시에 엄격한 요건이 있으면, 다중 이미지 참조 아래의 로고 예를 씁니다.
자막 프롬프트 템플릿: 텍스트와 함께 자막을 하단 중앙에 표시한다. 자막은 오디오의 리듬과 호흡에 완전히 동기화되어야 합니다.
동영상 연장과 구간별 이어 붙이기
- 연속된 롱 테이크(동영상 연장): 한 장면 안의 대화, 예를 들어 긴 대화, 감정의 진행, 한 길을 따른 이동에 맞습니다. 몰입감 있고 이어지는 원샷 효과를 얻습니다.
- 장면/동작의 전환점(구간별 이어 붙이기): 줄거리의 전환, 또는 추격, 격투, 몽타주처럼 복잡하고 템포가 빠른 액션 장면에 맞습니다. 독립된 클립을 생성한 뒤 편집으로 이어, 리듬과 시각적 충격을 확보합니다.
실제 제작에서는 두 방법을 보통 함께 씁니다. 예를 들어 먼저 연장으로 이어지는 대화를 생성하고, 그다음 빈 샷이나 전환 클립을 끼워, 몰입과 리듬 변화의 균형을 맞춥니다.
에셋 구성 전략
에셋은 보통 네 가지 기능적 역할로 나뉩니다.
- 캐릭터 고정: 캐릭터 외형을 고정합니다.
- 장면 톤 설정: 환경과 스타일을 고정합니다.
- 카메라 움직임 참조: 샷 언어와 동작 리듬을 고정합니다.
- 리듬 있는 분위기: 오디오로 감정과 음색을 제어합니다.
권장 구성은 합계 45개의 에셋입니다. 캐릭터 이미지 12장(얼굴 클로즈업 / 전신) + 장면 이미지 1장 + 카메라 움직임 동영상 1개 + 오디오 클립 1개.
에셋 한도를 모두 쓰는 것은 권하지 않습니다. 에셋이 너무 많으면 모델이 특징의 우선순위를 판단하기 어려워지고, 스타일 충돌, 피사체 식별의 흐림, 기대에서 벗어난 생성 결과가 생기기 쉽습니다.
Seedance 2.0 제품군에서는 오디오를 텍스트만과 짝지을 수 없습니다. 오디오와 함께 이미지나 동영상을 적어도 하나 더합니다.
주의할 점
언어 기준
대화의 언어는 일치해야 하며, 고유 명사를 제외하고 중국어와 영어를 섞는 것은 피해야 합니다.
특수 문자 기준
프롬프트 안에서 기호를 알맞게 쓰면, 모델이 서로 다른 종류의 정보를 정확하게 이해하는 데 도움이 됩니다.
| 정보 종류 | 기호 | 예 |
|---|---|---|
| 음악 | () | (fast-paced rock music is playing in the background) |
| 효과음 | 공식 표는 이 기호 칸을 비워 둡니다. 소리는 말로, 샷의 오디오 줄에 적으세요. | |
| 대화 | {} | {Hello, world}. 대화가 중국어도 영어도 아닌, 덜 흔한 언어일 때는 언어를 표시해야 합니다. 예: 일본어로 {こんにちは}라고 말한다. |
| 자막 | 【】 | 【Chapter One: Departure】 |
자주 묻는 질문
부정확한 얼굴 참조
전형적인 증상. 생성된 캐릭터 외형이 참조 이미지와 일치하지 않습니다. 또는 동영상 도중에 얼굴이 바뀌는 일(ID 드리프트, ID drift)이 일어나, 동영상 안의 캐릭터가 유명인과 닮아 심사에서 차단됩니다.
근본 원인. 얼굴 참조 이미지의 효력이 충분하지 않습니다.
- 섞인 참조 이미지. 얼굴 참조, 전신 또는 반신 포즈 참조, 의상 참조, 세부 참조, 그 밖의 참조 요소를 한 장에 모은 이미지를 모델에 줍니다.
- 얼굴 비율이 너무 작다. 섞인 참조 이미지에서 얼굴 영역이 이미지 전체에서 차지하는 비율이 너무 작습니다. 얼굴 특징을 추출할 때 모델은 거기에 충분한 가중치를 주지 않고, 배경이나 다른 요소에 쉽게 흔들립니다.
해결. 얼굴 참조의 독립성과 가중치를 높입니다.
- 얼굴 클로즈업 이미지를 준비합니다. 원래의 전신 사진에 더해, 캐릭터의 머리만 담긴 얼굴 클로즈업을 따로 준비합니다. 헤드샷이며, 얼굴만 남깁니다. 무표정이 가장 좋습니다. 어깨, 목, 배경처럼 방해가 되는 요소를 최소한으로 합니다.
- 프롬프트 안에서 피사체를 분명히 정의합니다. 얼굴 특징은 헤드샷을 참조하고, 메이크업과 스타일링은 전신 사진을 참조합니다.
- 중요한 에셋을 앞에 둡니다. 정밀한 참조가 필요한 에셋일수록 프롬프트 안에서 더 앞에 둡니다.
캐릭터 참조에서는 헤드샷과 전신 사진이면 충분합니다. 멀티 뷰(multi-view) 캐릭터 이미지는 권하지 않습니다. 멀티 뷰 에셋은 같은 캐릭터의 다른 각도를 담고 있어, 모델이 그것들을 서로 다른 여러 피사체로 식별하기 쉽고, 오히려 ID 드리프트(ID drift)를 악화시킵니다.
이전: 동영상 안의 캐릭터가 도중에 얼굴이 바뀌고 유명인과 닮습니다. 이후: 얼굴은 처음부터 끝까지 참조 이미지와 일치한 채 남습니다.
고치는 법
Prepare a close-up face image containing only the character's head, in addition to the full-body photo. No expression is best. Minimize shoulders, neck, and background. In the prompt: facial features reference the headshot, makeup and styling reference the full-body photo. Place the asset that needs precise reference earlier. A headshot plus a full-body photo is sufficient. Multi-view character images are not recommended: the model may identify them as multiple different subjects, which worsens ID drift.
동영상에 예상 밖 자막이 나타남
전형적인 증상. 프롬프트는 자막을 요구하지 않았는데, 생성된 동영상에 자막이 들어 있습니다.
해결. 자막 생성을 100% 직접 피하는 것은 가능하지 않습니다. 확률을 낮추고 성공률을 높이는 수밖에 없습니다.
- 프롬프트에 명시적인 제약 지시를 더합니다. "Keep it subtitle-free"와 "Avoid generating any text or subtitles".
- 참조 이미지나 동영상에 필수가 아닌 텍스트가 있으면, 이미지 편집 또는 동영상 편집으로 먼저 그 텍스트를 지우고, 텍스트가 없는 에셋을 입력으로 씁니다.
- 용도가 허용하면 가로 크기 동영상 생성을 우선합니다. 가로에서 자막이 생성될 확률은 세로보다 분명히 낮습니다. 나중에 편집기에서 세로로 자를 수 있습니다.
동영상에 로고나 워터마크가 나타남
전형적인 증상. 프롬프트는 워터마크 관련 내용을 언급하지 않았는데, 생성된 동영상에 다른 동영상 플랫폼의 로고나 워터마크가 들어 있습니다.
해결. 프롬프트에 명시적인 제약 지시를 더합니다. "Do not generate watermarks"와 "Do not generate Logos".
스타일 드리프트
전형적인 증상. 2D 또는 3D 애니메이션 스타일을 생성하려 했는데, 입력한 참조 이미지의 스타일이 비교적 사실적이고, 프롬프트가 동영상 스타일을 강조하지 않습니다. 그 결과 생성된 동영상이 실사 사실 스타일로 흘러갈 수 있습니다.
해결. 프롬프트에 명시적인 스타일 제약어를 더합니다. 예를 들어 "2D Japanese anime style" 또는 "3D Chinese-style comic". 더 정밀한 스타일 제어가 필요하면, 동영상을 생성하기 전에 참조 이미지를 먼저 목표 스타일로 변환합니다.
이전: 선협(xianxia) 스타일이 실사 스타일로 흘러갑니다. 이후: 3D 중국 애니메이션 CG 선협(xianxia) 스타일을 유지합니다.
프롬프트
Add an explicit style constraint, such as "2D Japanese anime style" or "3D Chinese-style comic". The after example maintains the 3D Chinese animation CG xianxia style. If more precise style control is required, first convert the reference image into the target style, then generate the video.
동영상 연장 전환점의 점프 컷
전형적인 증상. 동영상 연장으로 새 동영상을 생성한 뒤, 새 동영상을 원본 동영상과 이으면, 이음새에서 프레임 점프 또는 되감기 문제가 생길 수 있습니다.
해결. 현재의 권장은 키프레임을 맞추는 후반 편집으로 이것을 고치는 것입니다. 근본적인 최적화는 이후 모델 반복으로 이루어집니다.
- 이을 동영상을 CapCut 또는 다른 전문 동영상 편집 소프트웨어로 가져옵니다.
- 첫 이음새에서, 앞 동영상 구간의 끝에서 6프레임을 잘라 냅니다.
- 동시에, 뒤따르는 동영상 구간의 시작에서 1프레임을 잘라 냅니다.
- 모든 이음점에서 위의 조작을 반복합니다.
- 내보내고, 이은 동영상의 매끄러움을 확인합니다.
동영상 프레임을 맞춘 뒤에도 약간의 점프가 남을 수 있습니다. 앞 클립은 전환 컷의 순간에 끝내고, 다음 동영상은 그 컷 뒤의 새 장면에서 시작하는 것을 권합니다.
이전: 전환점에서 화면이 순간적으로 뛰거나 내용이 되감깁니다. 이후: 전환이 더 매끄럽습니다.
고치는 법
Repair the join in post-editing by aligning keyframes. At the first join, trim 6 frames from the end of the previous video segment, and trim 1 frame from the beginning of the following video segment. Repeat for all stitching points.
중복된 캐릭터
전형적인 증상. 프레임 안의 캐릭터가 많고, 삼면도(three-view) 캐릭터 이미지를 참조 에셋으로 준 장면에서는, 생성된 같은 동영상 프레임 안에 동일한 캐릭터가 둘 나타나기 쉽습니다.
근본 원인.
- 프롬프트 안에서 캐릭터 피사체가 분명히 정의되지 않아, 모델이 서로 다른 캐릭터 역할을 정확하게 구분하지 못합니다.
- 캐릭터의 삼면도(three-view) 또는 멀티 뷰(multi-view) 이미지를 참조 에셋으로 쓰면, 모델의 캐릭터 인식이 헷갈리기 쉽고, 같은 외형의 중복 캐릭터를 생성합니다.
해결. 쌍둥이 문제를 100% 직접 피하는 것은 가능하지 않습니다. 다음 방법은 그 확률을 낮추고 성공률을 높일 뿐입니다.
- 캐릭터 피사체의 대응을 분명히 지정한다. 프롬프트 안에서 각 캐릭터 역할을 분명히 정의하고, 역할과 참조 이미지의 대응을 지정합니다. 각 캐릭터 이름 뒤에 대응하는 참조 이미지를 표시하고 형식을 일관되게 유지합니다. 예: Zhang San(image 1에 대응)이 서 있는 Li Si(image 2에 대응)를 향해 녹색 통장을 던집니다.
- 전역 제약 지시를 더한다. 프롬프트 끝에 고정된 제약을 더합니다. 동영상 전체를 통해, 외형, 옷, 액세서리가 완전히 동일한 캐릭터는 금지합니다. 중복 아바타나 쌍둥이 효과를 생성하지 않습니다. 같은 프레임에는 대응하는 캐릭터를 한 명만 남기고, 캐릭터의 반복된 복제를 재현하지 않습니다.
- 참조 에셋을 최적화한다. 캐릭터 참조 이미지는 독립된 한 사람의 사진을 우선합니다. 삼면도(three-view) 또는 멀티 뷰(multi-view) 에셋은 권하지 않습니다.
- 프롬프트를 단순화하고 최적화한다. 완전한 대본을 그대로 프롬프트로 쓰지 않습니다. 지나치게 장황한 문장은 모델의 이해를 헷갈리게 하기 쉽습니다. 무관한 묘사를 빼고, 지시가 분명하고 초점이 맞도록 합니다.
이전: 동영상 안에 쌍둥이가 나타납니다. 이후: 역할마다 한 사람.
고치는 법
Clearly define each character role and the corresponding reference image, and keep the format consistent. Example: Zhang San (corresponding to image 1) throws the green passbook toward Li Si (corresponding to image 2), who is standing. At the end of the prompt: Throughout the video, characters with completely identical appearance, clothing, and accessories are prohibited. Do not generate duplicate avatars or a twin effect. Keep only a single corresponding character in the same frame, and do not reproduce repeated copies of characters. Prioritize independent single-person photos. Three-view or multi-view assets are not recommended. Do not paste the complete script as the prompt.
동영상 연장 중 화질 저하
전형적인 증상. 모델이 생성한 동영상을 연장과 이어 가기의 입력 에셋으로 쓰면 화질 저하가 일어납니다. 여러 번의 이어 가기는 저하를 쌓고, 캐릭터 얼굴 영역에는 얼룩진 색 블록이 특히 나타나기 쉽습니다.
해결. 다음 방법으로 화질 저하를 완화할 수 있습니다. 근본적인 최적화는 나중에 모델 반복을 통해 이루어집니다.
- 원본 동영상을 흰색 모델 동영상으로 변환한 뒤, 그것을 이어 가기의 입력 에셋으로 씁니다. 참조 프롬프트: 동영상을 흰색 3D 모델(white 3D model)로 변환한다. 모든 캐릭터는 색도 없고, 텍스처도 없고, 그림자도 없는 순백의 3D 모델로 통일한다. 순백 배경, 안정된 구조, 매끄러운 움직임을 쓴다.
- 참조 에셋으로는 고화질 이미지를 우선합니다.
- 동영상 이어 가기 횟수를 합리적으로 제어하고, 반복해서 쌓은 이어 가기를 피합니다.
이전: 모델 출력을 그대로 바탕으로 이어 갑니다. 이후: 이어 가기를 하기 전에 모델 출력을 흰색 3D 모델(white 3D model) 동영상으로 변환합니다.
프롬프트
Convert the video into a white 3D model. All characters should be unified as pure white 3D models, with no color, no texture, and no shadows; use a pure white background, stable structure, and smooth motion. Then continue from that white-model video. Prioritize high-definition images as reference assets, and avoid repeated stacked continuations.
특수 효과가 기대에 맞지 않음
전형적인 증상. 특정 특수 효과를 프롬프트 텍스트로 묘사하면 효과가 기대와 맞지 않을 수 있습니다. 예를 들어 프롬프트가 숫자 "2999"가 카운트다운 애니메이션과 함께 나타난다고 지정해도, 실제로 생성되는 숫자 스크롤 효과는 무작위로 뛰고 표준 카운트다운 논리를 따르지 않을 수 있습니다.
해결. 참조 동영상으로 특수 효과를 정의합니다. 목표 특수 효과 동영상을 참조 에셋으로 모델에 넣으면, 모델이 효과의 형태와 움직임 논리를 정확하게 이해할 수 있고, 생성 결과는 기대에 더 잘 맞습니다. 예를 들어 숫자 "2999"가 나타나는 방식은 @Video1을 참조합니다.
이전: 숫자 스크롤 효과에 흐트러진 점프의 느낌이 분명합니다. 이후: 올바른 숫자 스크롤 효과 동영상을 더하면 효과 결과가 기대에 맞습니다.
참조 소재
@Video1
프롬프트
The way the number "2999" appears should reference @Video1.
참조 캐릭터가 너무 많음
전형적인 증상. 참조하는 사람 수가 4명을 넘으면 모델 출력의 안정성이 떨어지고, 생성된 동영상에 사람 수의 오류(예를 들어 캐릭터가 너무 적거나 너무 많음)나 캐릭터 중복 같은 문제가 생길 수 있습니다.
해결. 다음 방법으로 완화할 수 있습니다. 앞으로 모델 반복에 따라 근본적인 최적화가 이루어집니다.
- 이미지를 단계적으로 생성한다. 사람들을 그룹으로 나누어, 생성하는 각 이미지의 사람 수가 4명을 넘지 않게 합니다. 예를 들어 6명이면 3명씩 2그룹으로 나누고, 이미지를 따로 생성할 수 있습니다.
- 이미지에서 동영상을 생성한다. 첫 단계에서 생성한, 그룹으로 나뉜 여러 이미지를 참조 에셋으로 쓴 다음, 최종 동영상을 생성합니다.
이전: 참조 캐릭터 8명을 입력하면 출력 동영상은 9명이 됩니다. 이후: 8명의 캐릭터로 이미지 2장을 생성한 다음 이미지에서 동영상을 만듭니다.
고치는 법
When the number of reference people exceeds 4, group them so that each generated image contains no more than 4 people. For example, 6 people can be divided into 2 groups of 3. Generate those images first, then generate the video from the grouped images.
동영상 끝의 노이즈
전형적인 증상. 동영상에 내레이션이 있을 때, 동영상 끝에 갑작스러운 클릭음과 끊기는 노이즈가 나기 쉽습니다.
해결. 동영상을 다시 생성하거나, CapCut 같은 편집기를 써서 볼륨 엔벨로프(volume envelope)를 통해 끝부분 오디오 트랙에 오디오 페이드아웃 처리를 적용하고, 끊기는 노이즈를 없앱니다.
CapCut을 쓰는 구체적인 단계:
- 생성된 동영상을 CapCut으로 가져옵니다.
- 타임라인의 비디오 트랙을 고르고 도구 막대의 Audio를 클릭합니다.
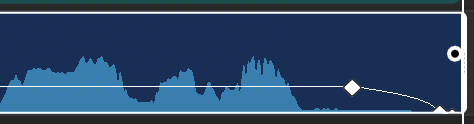
- Volume envelope 기능을 고릅니다. 일부 버전에서는 Basic / Adjust 메뉴 안에 있습니다. 키프레임을 고릅니다. 음량과 키프레임을 나타내는 선이 오디오 트랙 위에 나타납니다.
- 동영상 끝 근처에서 마지막 음량 키프레임을 음량 0까지 아래로 끌어, 아래를 향한 경사를 만듭니다. 카드 위의 곡선이 그 경사입니다.
- 미리 보고, 끝부분 오디오가 자연스럽게 페이드아웃되며 갑작스러운 끊김이나 노이즈가 없는지 확인합니다.
이전: 끝에 노이즈가 있습니다. 이후: 끝에 노이즈가 없습니다.
참조 소재
@Image1
고치는 법
Regenerate the video, or fade the ending audio to silence with a volume envelope. Near the end, drag the final volume keyframe down to 0 so the curve in @Image1 forms a downward slope.
부정확한 중국어 발음
전형적인 증상. 모델은 다음자, 드문 글자, 모양이 비슷한 글자를 잘못 읽기 쉽습니다.
해결. 잘못 읽기 쉬운 텍스트를, 같은 발음의 흔히 쓰는 동음어로 바꾸면 발음 이탈을 피하고 기대하는 오디오 효과를 되돌릴 수 있습니다. 이 해결은 최적화 방법일 뿐이며, 모든 발음 문제를 완전히 피할 수는 없습니다.
예: 프롬프트 안의 "螭龙山"을 동음인 "吃龙山"으로 다시 쓸 수 있습니다.
이전: "螭龙山"의 "螭" 발음이 틀립니다. 이후: "吃龙山"으로 바꾸면 발음이 맞습니다.
프롬프트
Replace text that is easy to misread with a commonly used homophone of the same pronunciation. Rewrite "螭龙山" as "吃龙山". This is an optimization and cannot completely avoid all pronunciation issues.
부정확한 목소리 참조
전형적인 증상. 참조 오디오로 목소리를 지정했을 때, 최종 생성된 동영상의 오디오 목소리가 참조 목소리와 크게 다릅니다.
해결.
- 프롬프트에 목소리 특성의 자세한 묘사를 더합니다. 이 예에서 실제로 쓰는 한 줄은 "use the low, thick, warm, and finely grainy middle-aged male voice of
@Audio1"입니다. - 동영상 대사의 스타일을 참조 오디오의 어조와 표현 스타일에 가깝게 유지합니다. 이것은 목소리 복원과 안정성을 높이는 데 도움이 됩니다.
멀티 레퍼런스에서 그 파일은 @Audio1입니다. Seedance 2.0 제품군에서는 오디오를 적어도 하나의 이미지나 동영상과 짝짓습니다.
이전: 목소리가 입력 오디오와 맞지 않습니다. 이후: 프롬프트에 목소리 특성 묘사를 더하면 목소리 일치 정확도가 분명히 올라갑니다.
참조 소재
@Audio1
프롬프트
Use the low, thick, warm, and finely grainy middle-aged male voice of @Audio1. Keep the style of the lines close to the tone and expression of that reference audio.
프롬프트 예시
이 절은 텍스트 생성, 이미지 참조, 동영상 참조, 동영상 편집에 대한 공식 프롬프트 예시를 보여 줍니다. 각 카드의 프롬프트는 공식 문장을 유지합니다. 대사와 화면 위 글자는 바꾸지 않았습니다. @Image1, @Video1, @Audio1은 Image 1, Video 1, Audio 1에 대한 이 스튜디오의 토큰입니다. 공식 프롬프트가 Image 1, Image 2, Image 3이라고 말하는 곳은 참조 시트 한 장 위의 라벨이며, 그 시트가 단일 파일 @Image1입니다.
슬로건
프롬프트 템플릿: [텍스트 내용] + [타이밍] + [배치] + [등장/나타나는 방식], [시각 속성(색, 글꼴 스타일)].
Seedance 2.0은 문맥에 따라 적절한 텍스트 스타일을 맞출 수 있습니다. 텍스트 표시에 엄격한 요건이 있으면, 다중 이미지 참조 아래의 로고 예를 씁니다.
참조 소재
@Image1
프롬프트
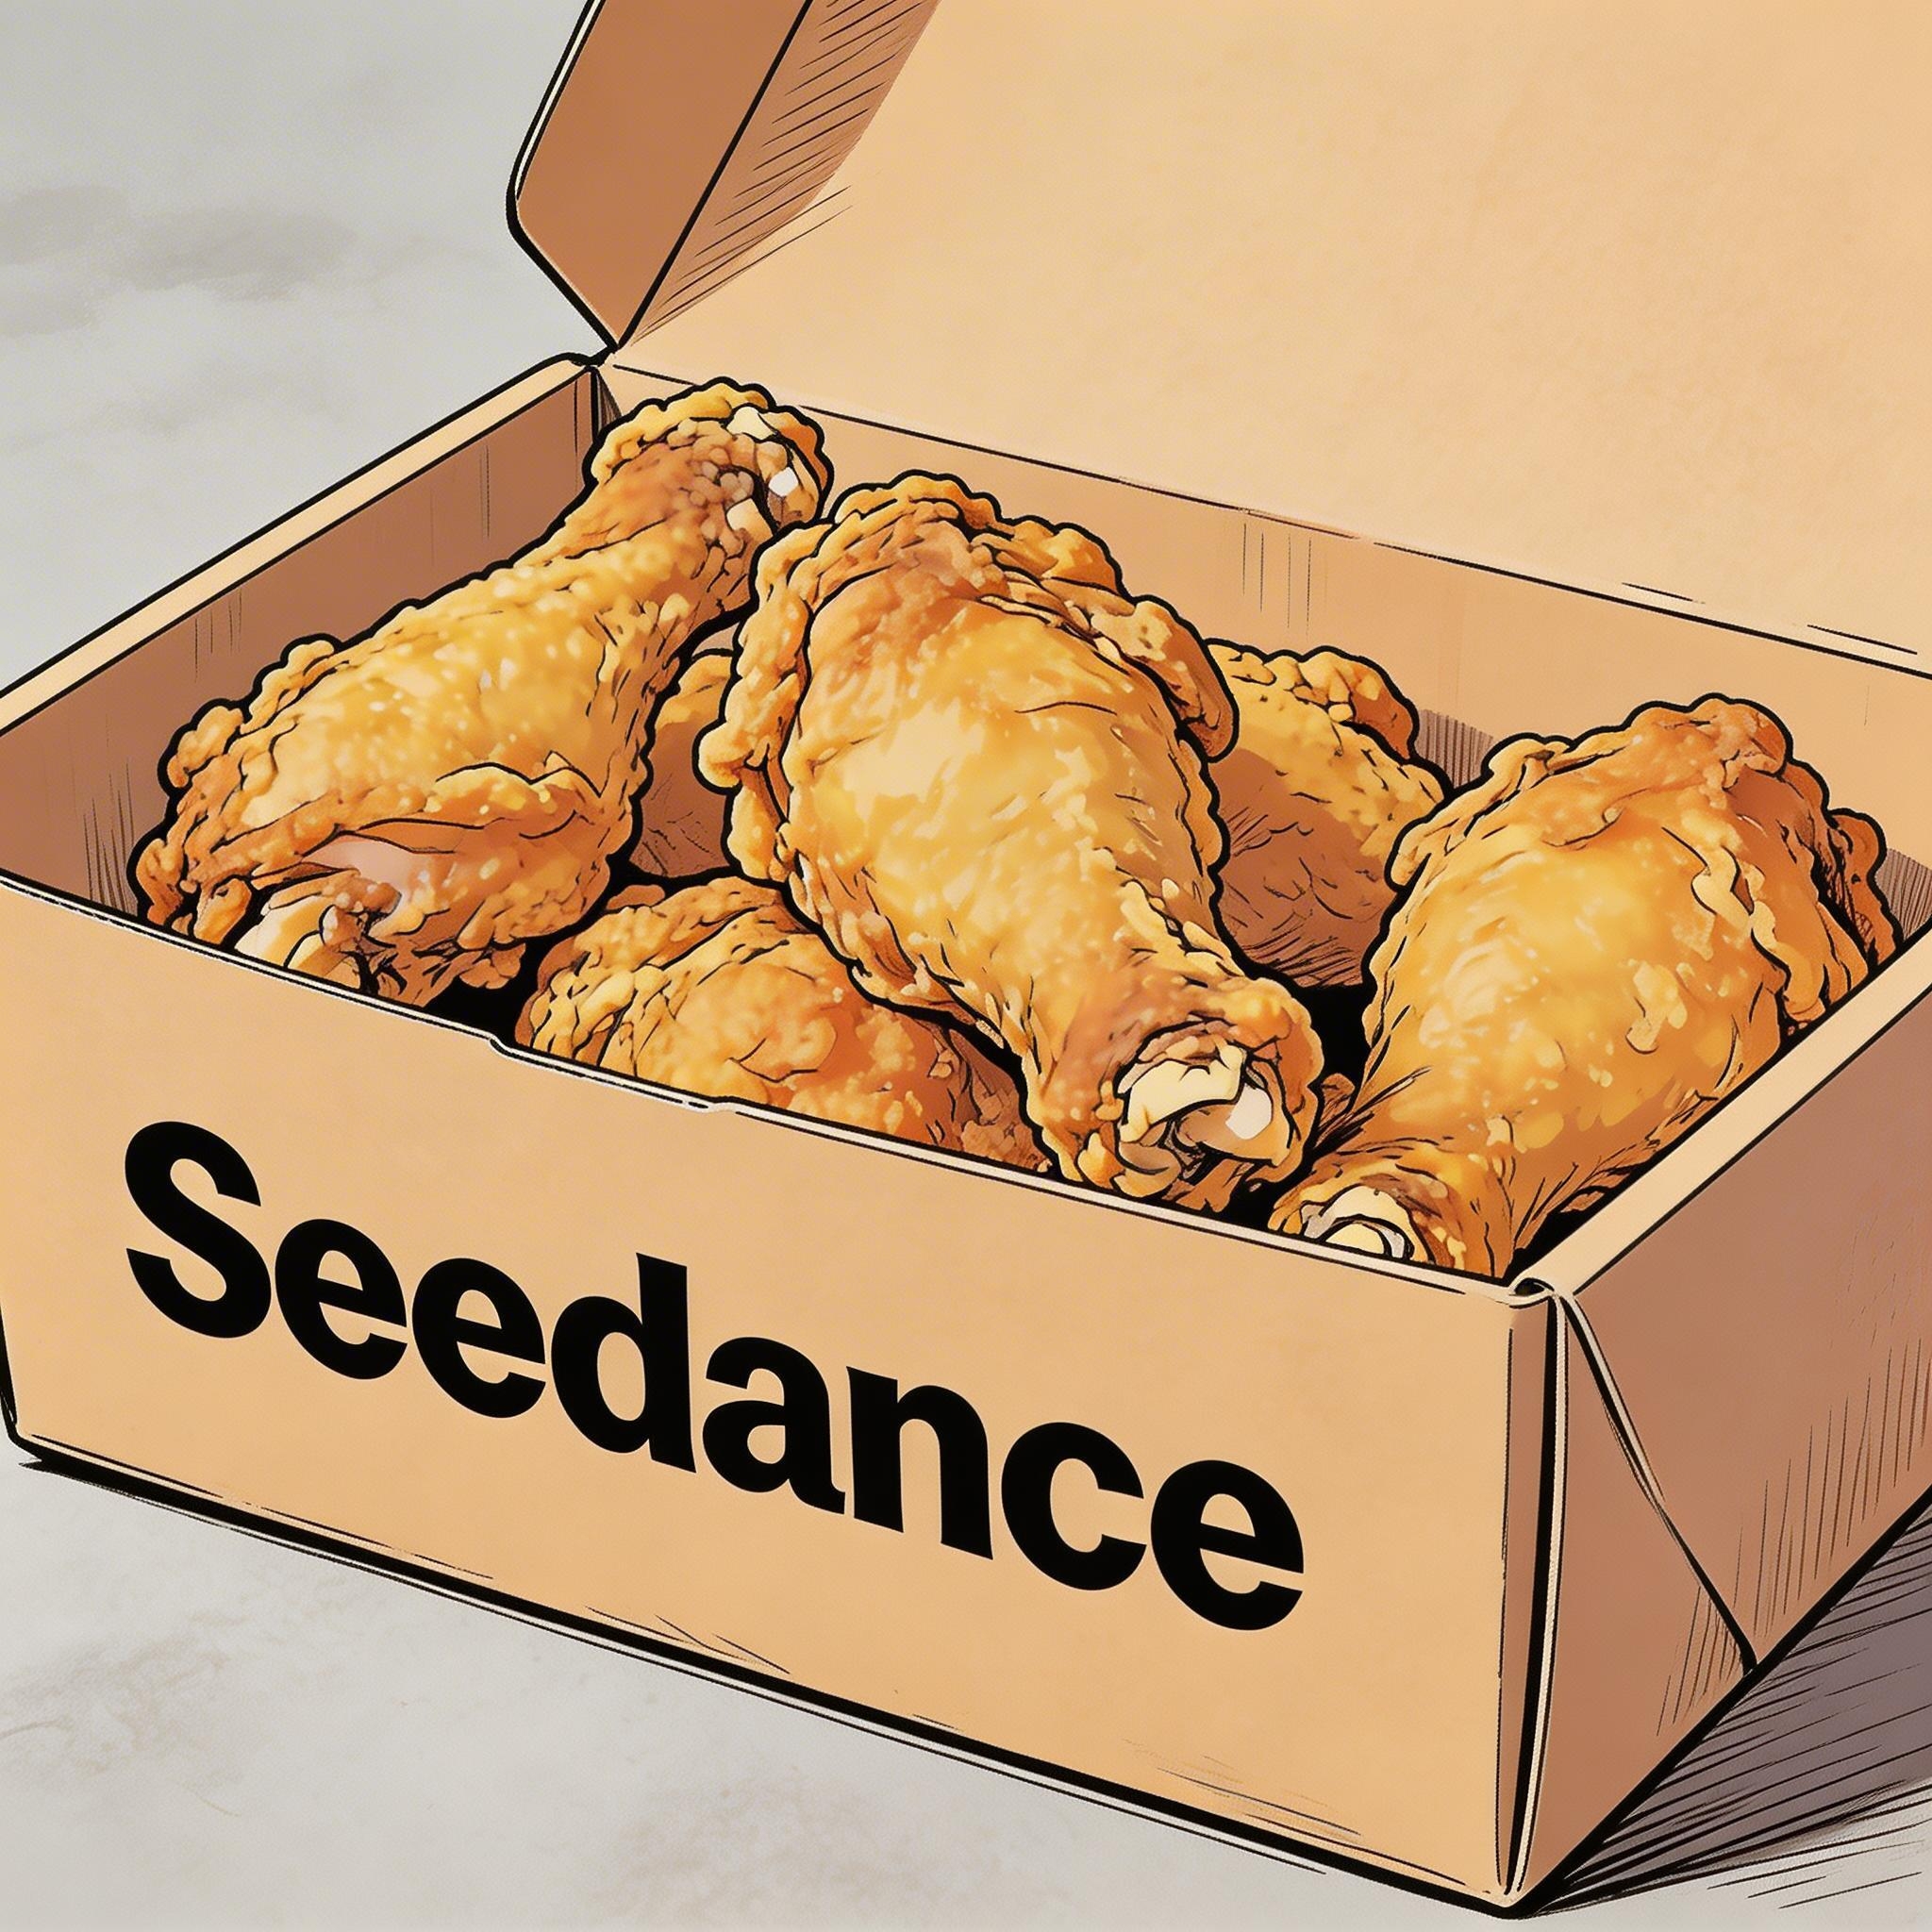
Hand-drawn comic style: Three people are sitting around a table enjoying the fried chicken shown in @Image1, with a friendly and joyful atmosphere. The frame then gradually blurs, and the text "Bite", "Laugh", and "Seedance" in order appears in the center of the screen.
자막
프롬프트 템플릿: 텍스트와 함께 자막을 하단 중앙에 표시한다. 자막은 오디오의 리듬과 호흡에 완전히 동기화되어야 합니다.
첫 예는 보이스오버입니다. 두 번째는 더빙입니다.
참조 소재
@Image1
프롬프트
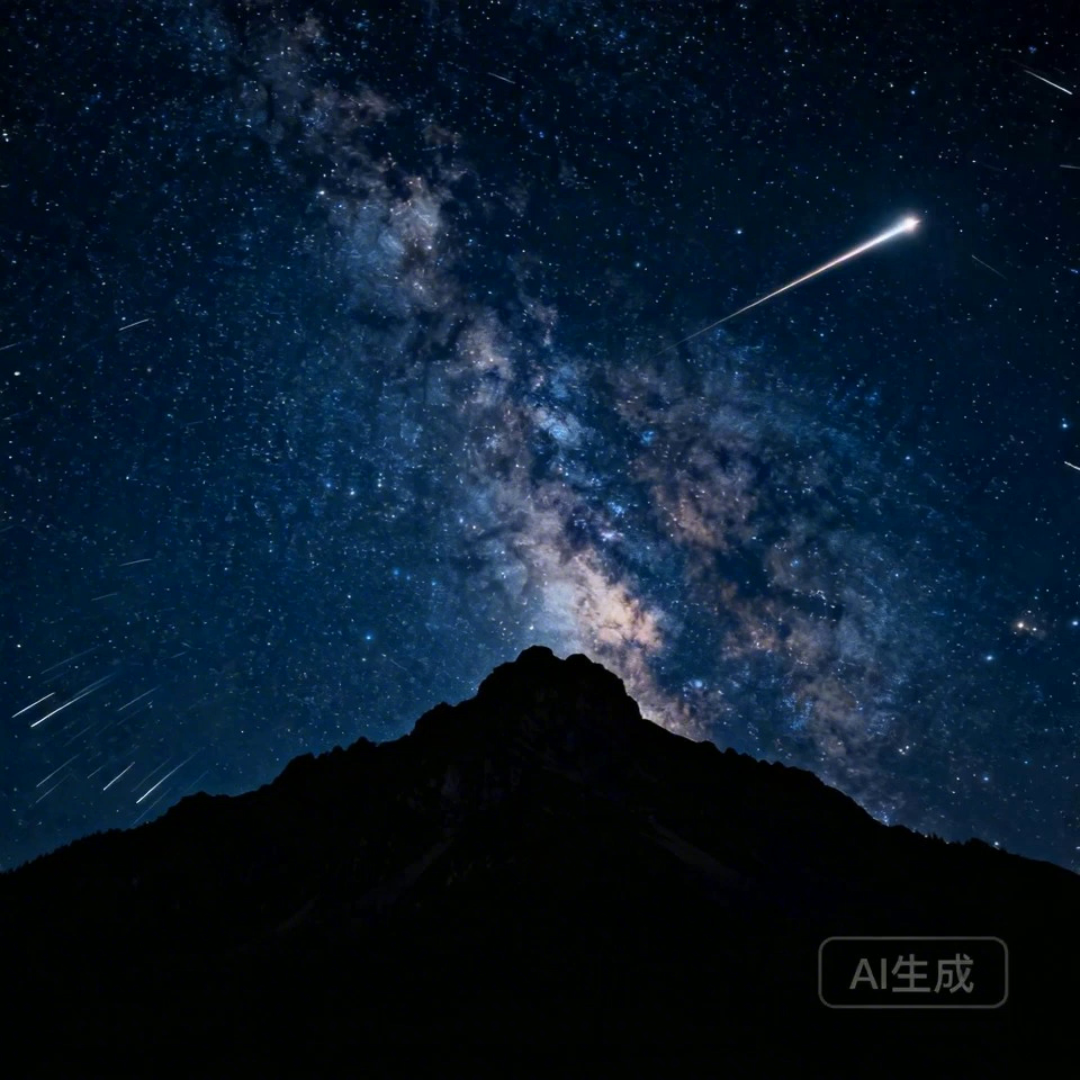
I2V: A time-lapse of a mountain landscape transitioning from a vast, starry night to a vibrant dawn. Reference @Image1. Voiceover: A deep, serene male voice says: "In the vast silence of the cosmos, our world is but a fleeting moment. Yet, within it, life defiantly thrives." Text integration: Render the narration as subtitles at the bottom-center. Subtitles must be perfectly synchronized with audio timing.
참조 소재
@Image1
프롬프트
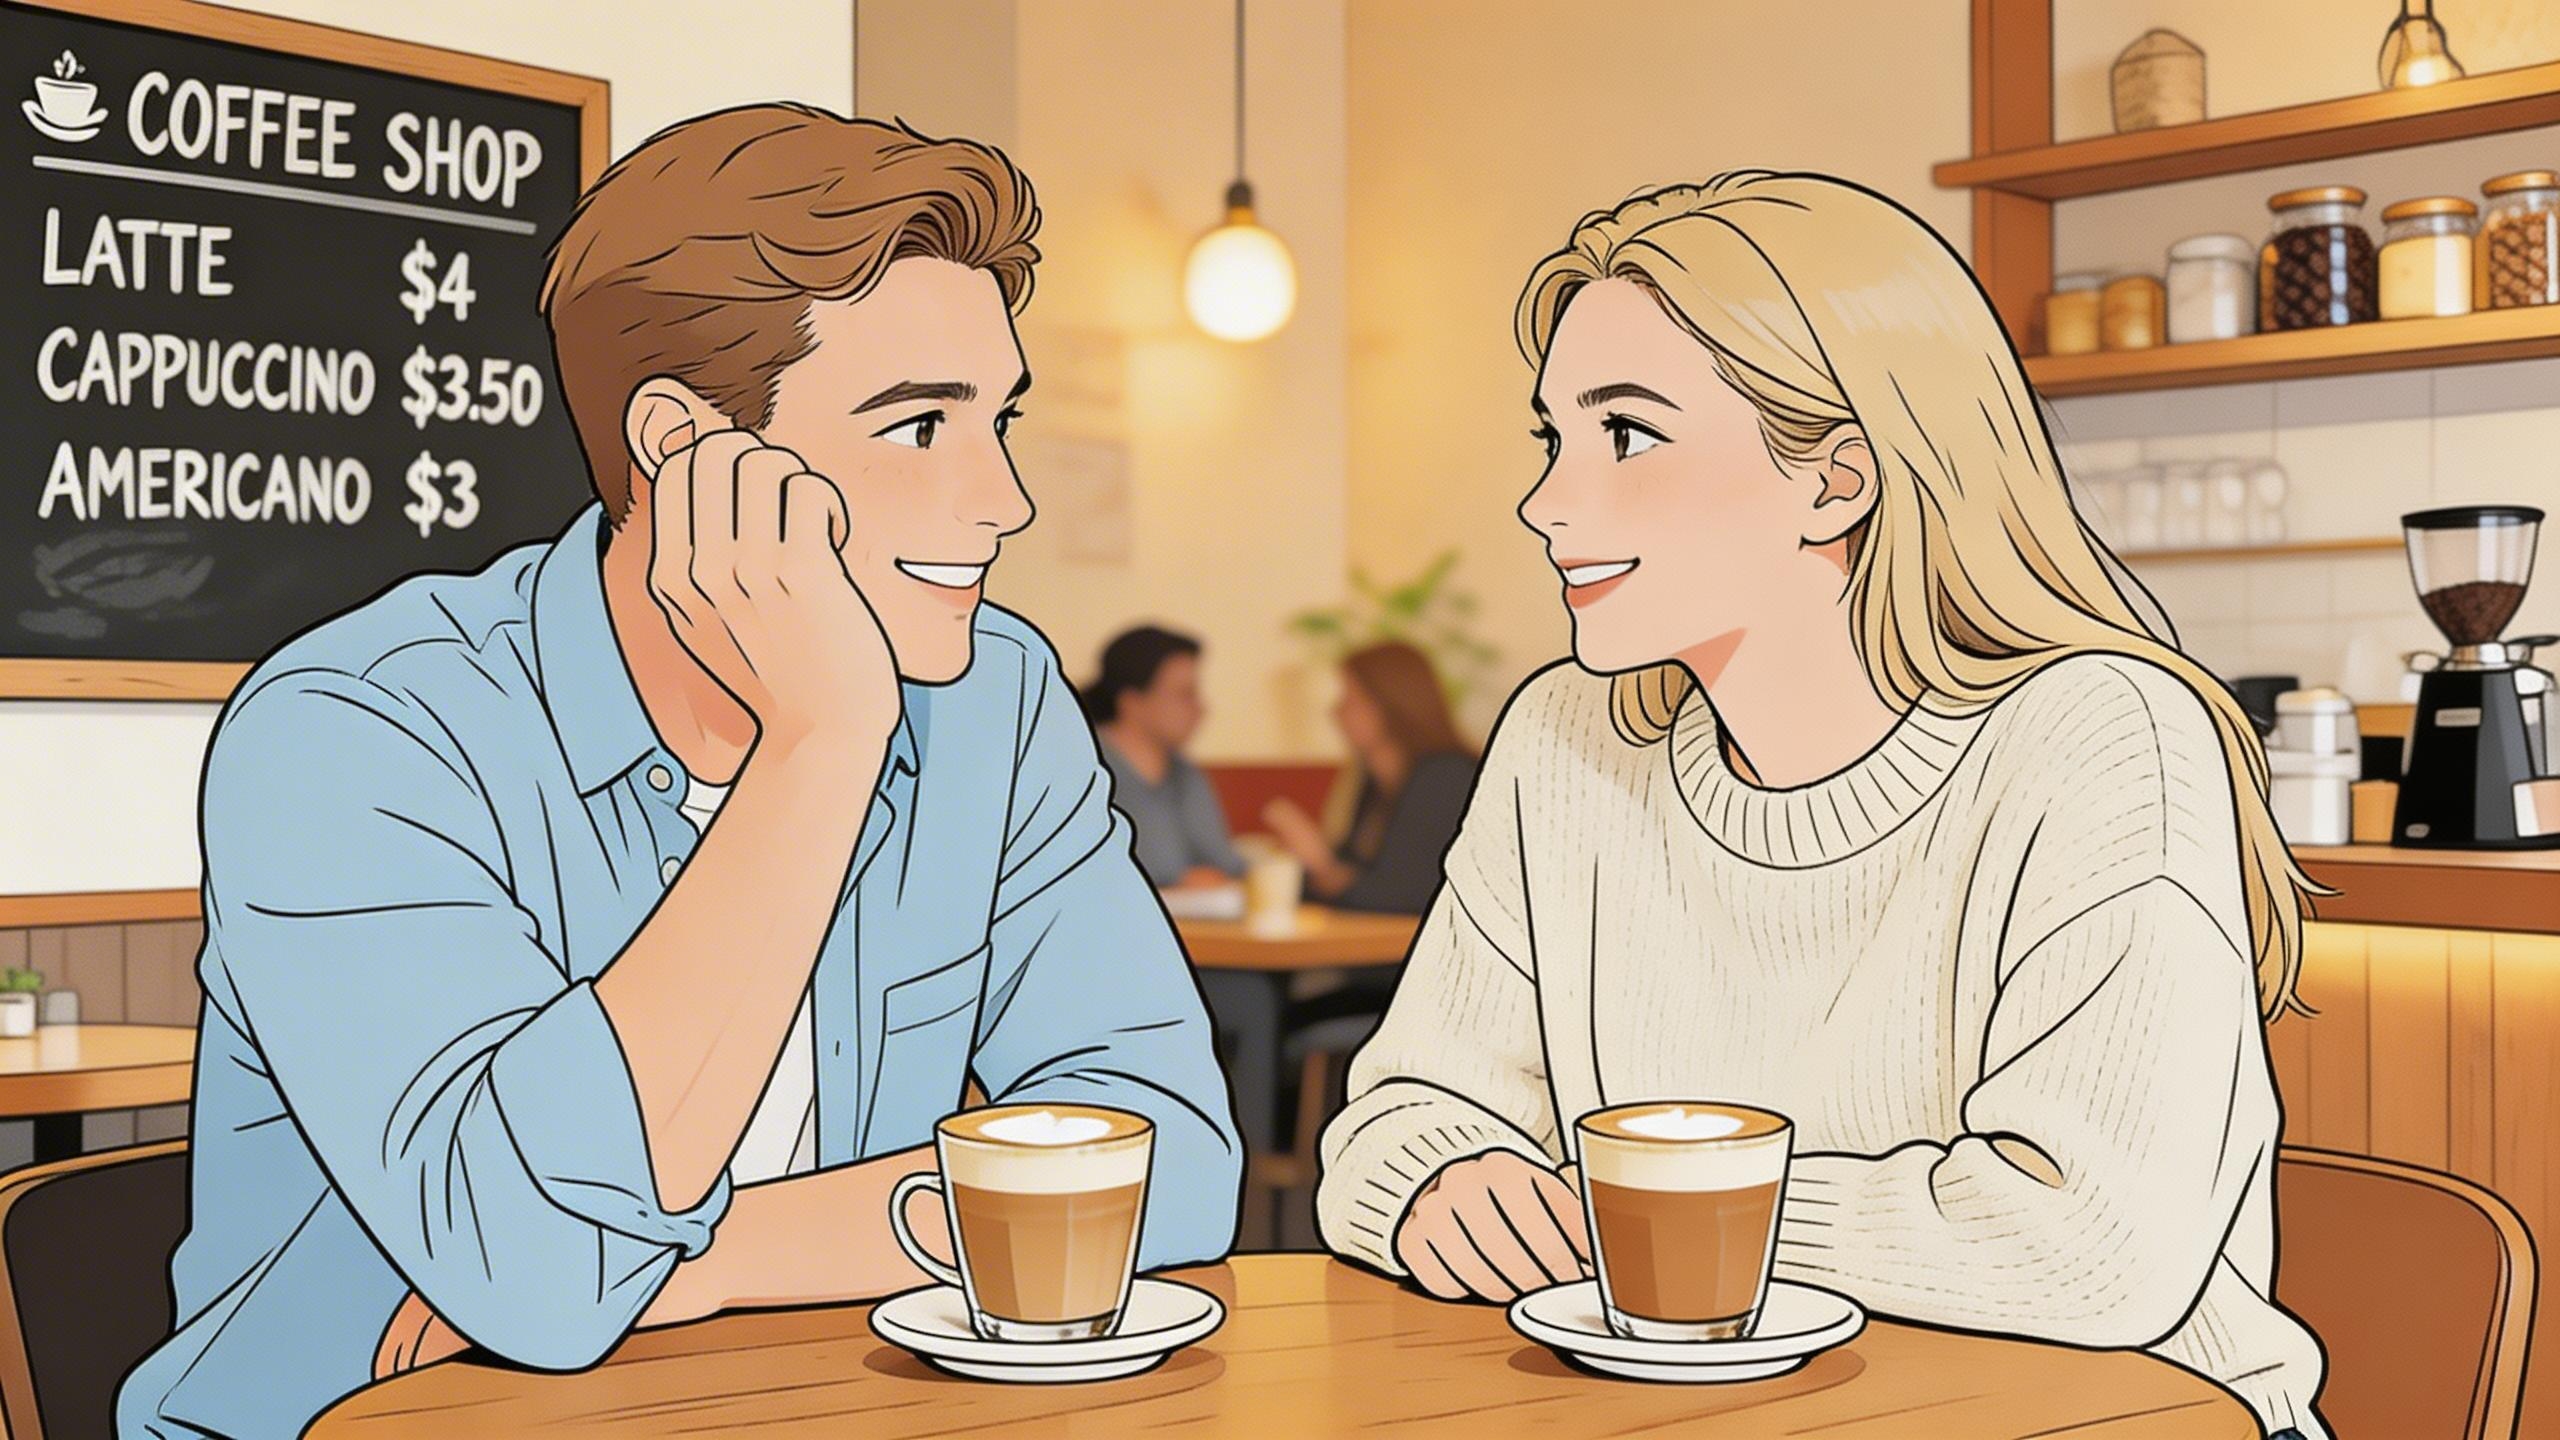
R2V: A shot of these two people in @Image1 chatting in a modern office. The woman speaks first with a playful tone: "You always arrive right on time, don't you just love that perfect timing?" followed by the man's smiling reply: "I have my own rhythm." Text integration: Render the dialogue as subtitles at the bottom-center of the screen. Subtitles should appear sequentially as each character speaks.
말풍선
말풍선은 말한 대사를 담고, 말하고 있는 캐릭터 곁에 나타납니다.
참조 소재
@Image1
프롬프트
The two characters from @Image1, both dressed in sportswear, are running on the school playground. The girl looks at the boy, smiling confidently as she says: "We can definitely do it!". Cut to a close-up of the boy. He hesitates and replies: "Are you sure?". Cut back to a medium close-up of the girl. She speaks in a light, upbeat tone: "Yes!" Her demeanor is bright and resolute. Speech bubbles containing the corresponding lines appear around the speaking character.
참조 소재
@Image1
프롬프트
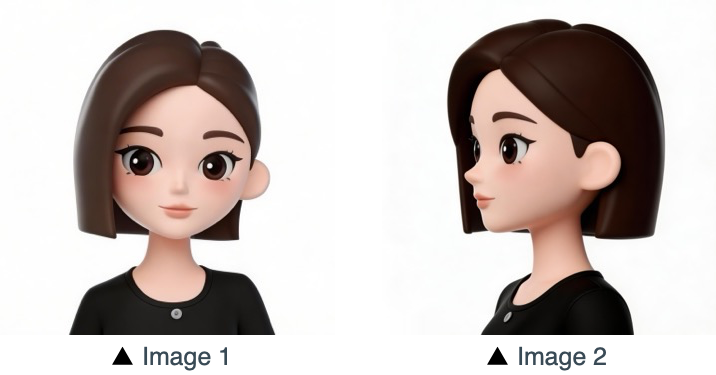
Refer to the character design of the girl in Image 1 and Image 2 on @Image1. The scene is set in an apple field: the girl picks one apple, takes a bite, smiles and says "This is the real deal!". A speech bubble pops up beside the girl, with this line written inside.
다시점 피사체 참조
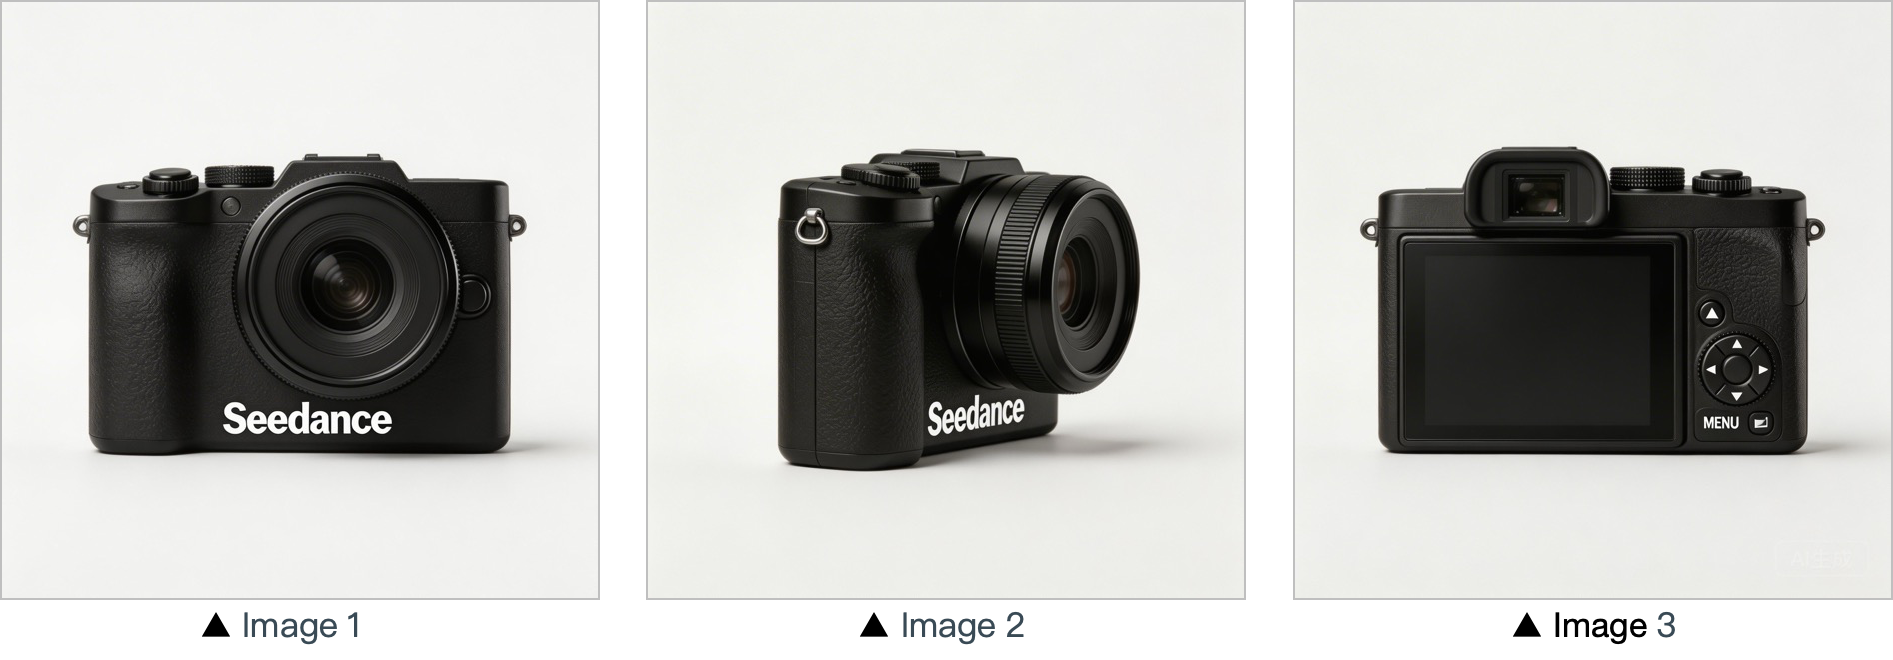
하나의 피사체를 시트 위의 여러 각도에서 참조합니다. 가전, 가정과 생활, 그리고 사람입니다.
참조 소재
@Image1
프롬프트
Use the cameras featured in Image 1, Image 2 and Image 3 on @Image1. Replace the original background with a white one, and place the cameras on a white table. The camera first focuses on the cameras in close-up, then slowly rotates 360° with the cameras as the main subject, clearly displaying the front, sides and back of each camera.
참조 소재
@Image1
프롬프트
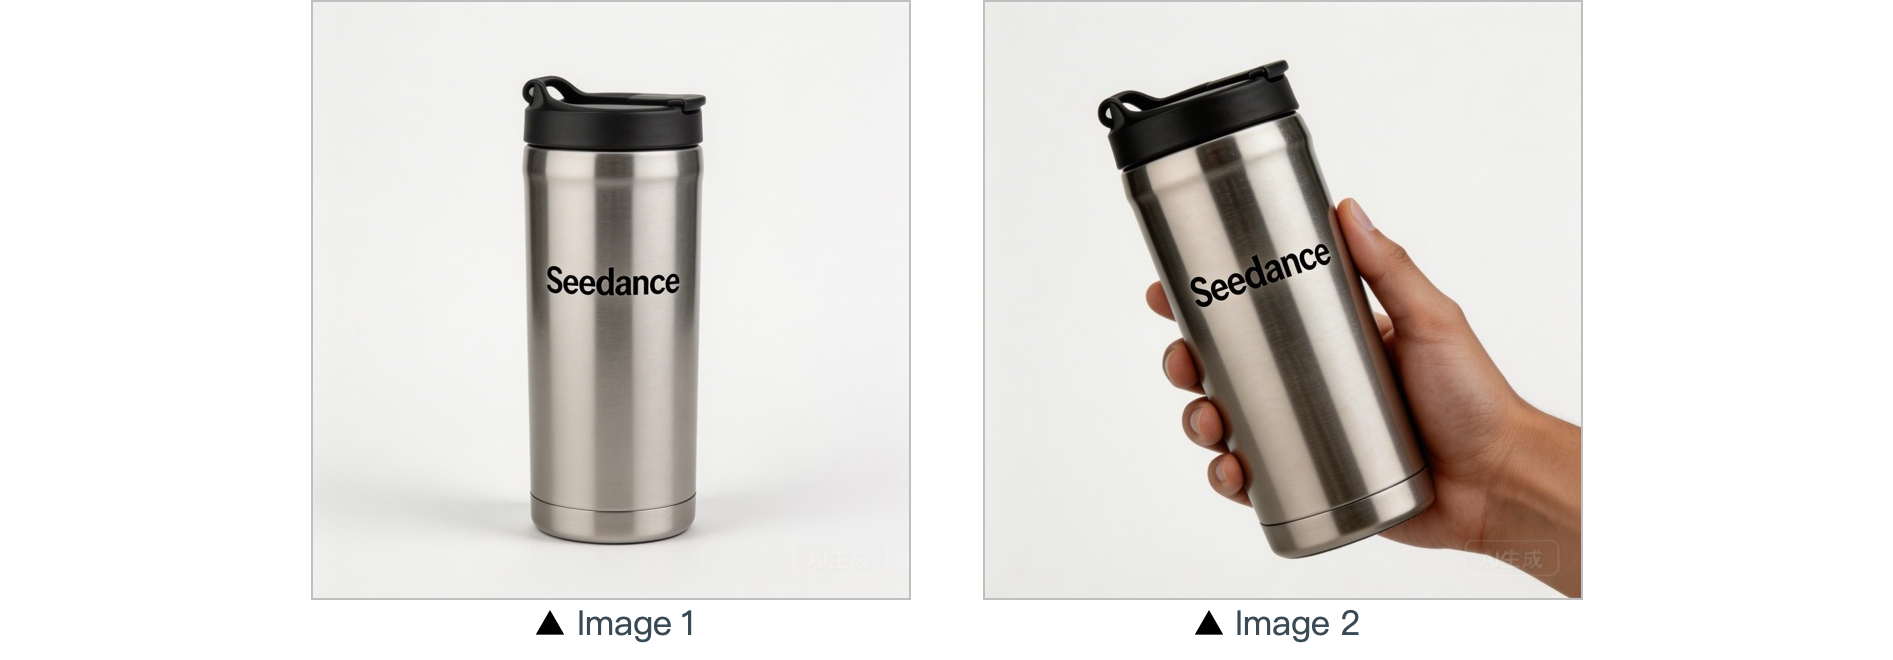
In a warm-toned home setting, present the thermos shown in @Image1 in a medium shot. Then smoothly push the camera into a close-up of the thermos. Next, a hand naturally enters the frame off-screen, gently grips the thermos body and picks it up. The camera follows the slight rotating motion of the hand to showcase the thermos.
참조 소재
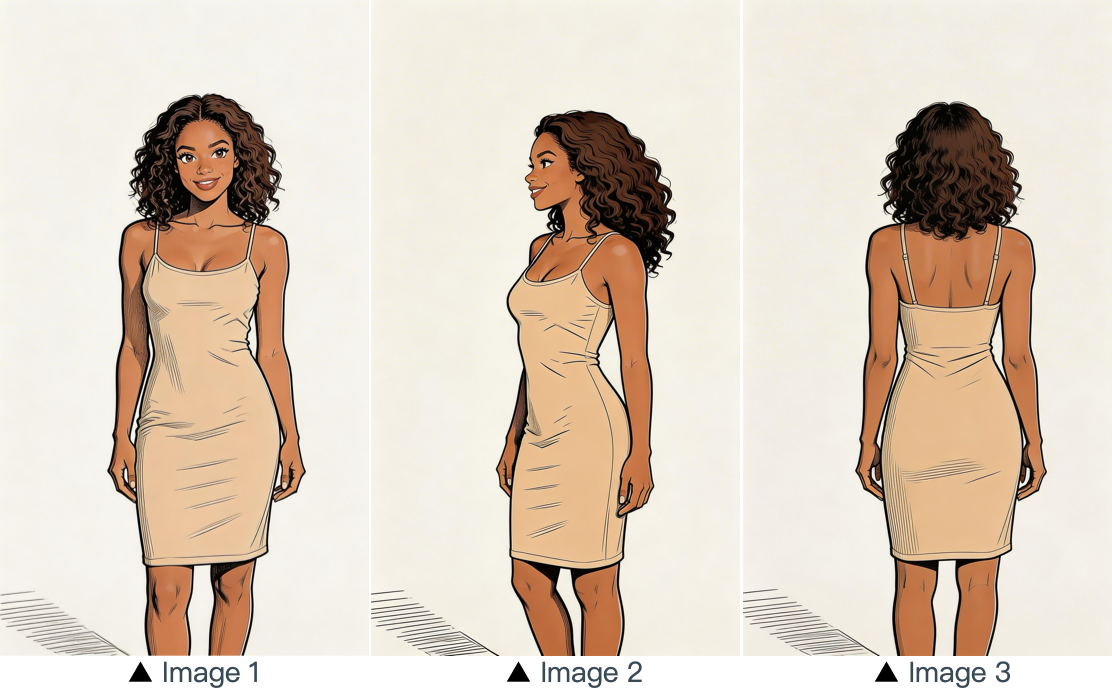
@Image1
프롬프트
Refer to the image of the woman in Image 1, Image 2 and Image 3 on @Image1, and generate a scene of her eating a cake in a coffee shop.
다중 이미지 참조
시트 위의 각 그림에는 일이 하나 있습니다. 로고, 여러 피사체, 출연진과 장소, 여러 칸의 연속, 또는 프레임의 연속입니다.
참조 소재
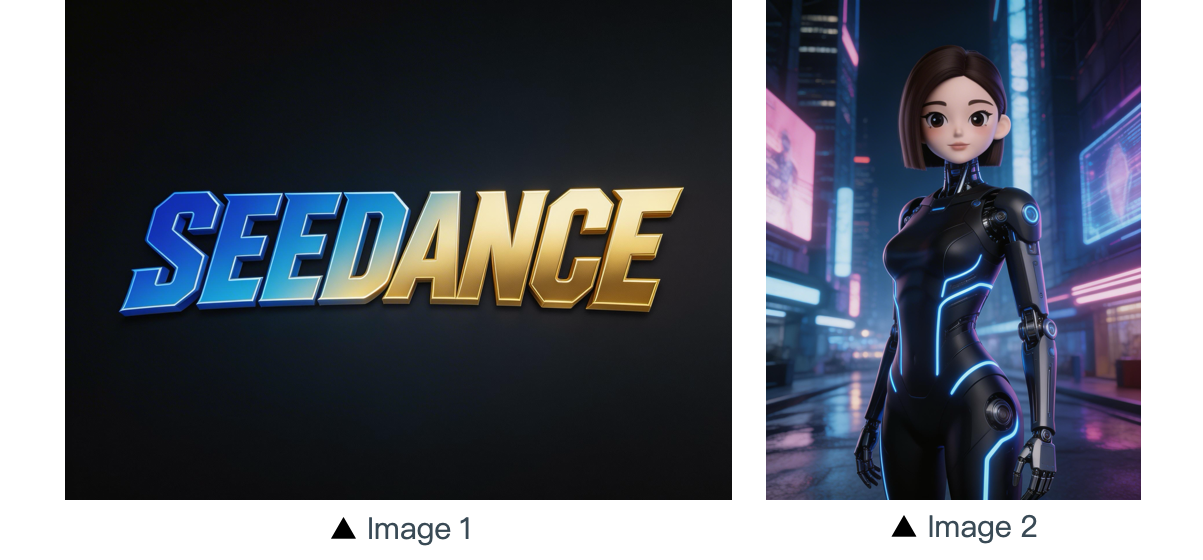
@Image1
프롬프트
The scene is set on an aerial corridor in a neon-drenched futuristic metropolis, where flying vehicles and holographic ads intertwine. Featuring the girl from Image 2 on @Image1, the sequence opens with a medium shot of her releasing a silver floating lantern embedded with a holographic projection. The camera then pulls back to reveal floating lanterns flooding the sky, which gradually converge at the center of the frame to form the logo from Image 1 on @Image1. The entire piece adopts a 3D cyberpunk sci-fi animation style.
참조 소재
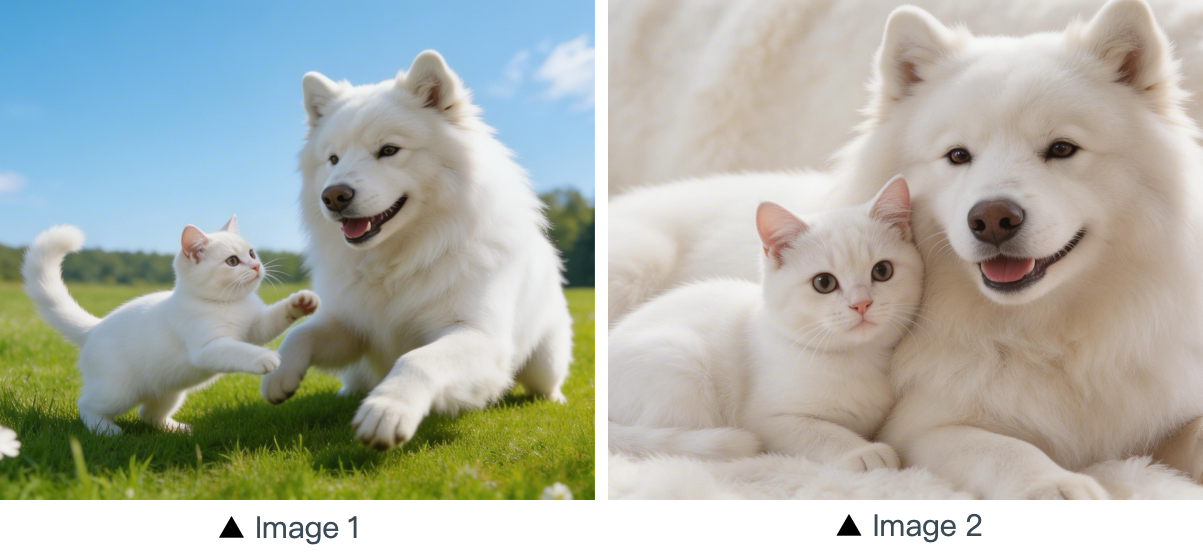
@Image1
프롬프트
Using the cat and dog from Image 1 and Image 2 on @Image1 as prototypes, the scene unfolds in a cozy apartment. The dog is lying on the ground eating dog food when the cat approaches, extending a paw to nudge the dog. The dog pauses its meal upon noticing the cat, and the cat snuggles up next to the dog. The entire scene features a warm colored tone.
참조 소재
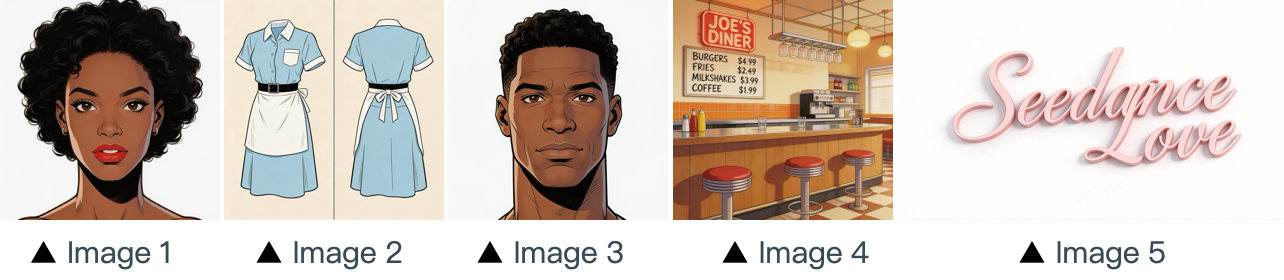
@Image1
프롬프트
The scene is set in the restaurant from image 4 on @Image1, with people coming and going. The girl from image 1, wearing the clothes from image 2, is organizing the items on the counter. The boy, a customer, from image 3 approaches her to ask for her contact information. The logo from image 5 remains in the bottom right corner throughout.
참조 소재
@Image1
프롬프트
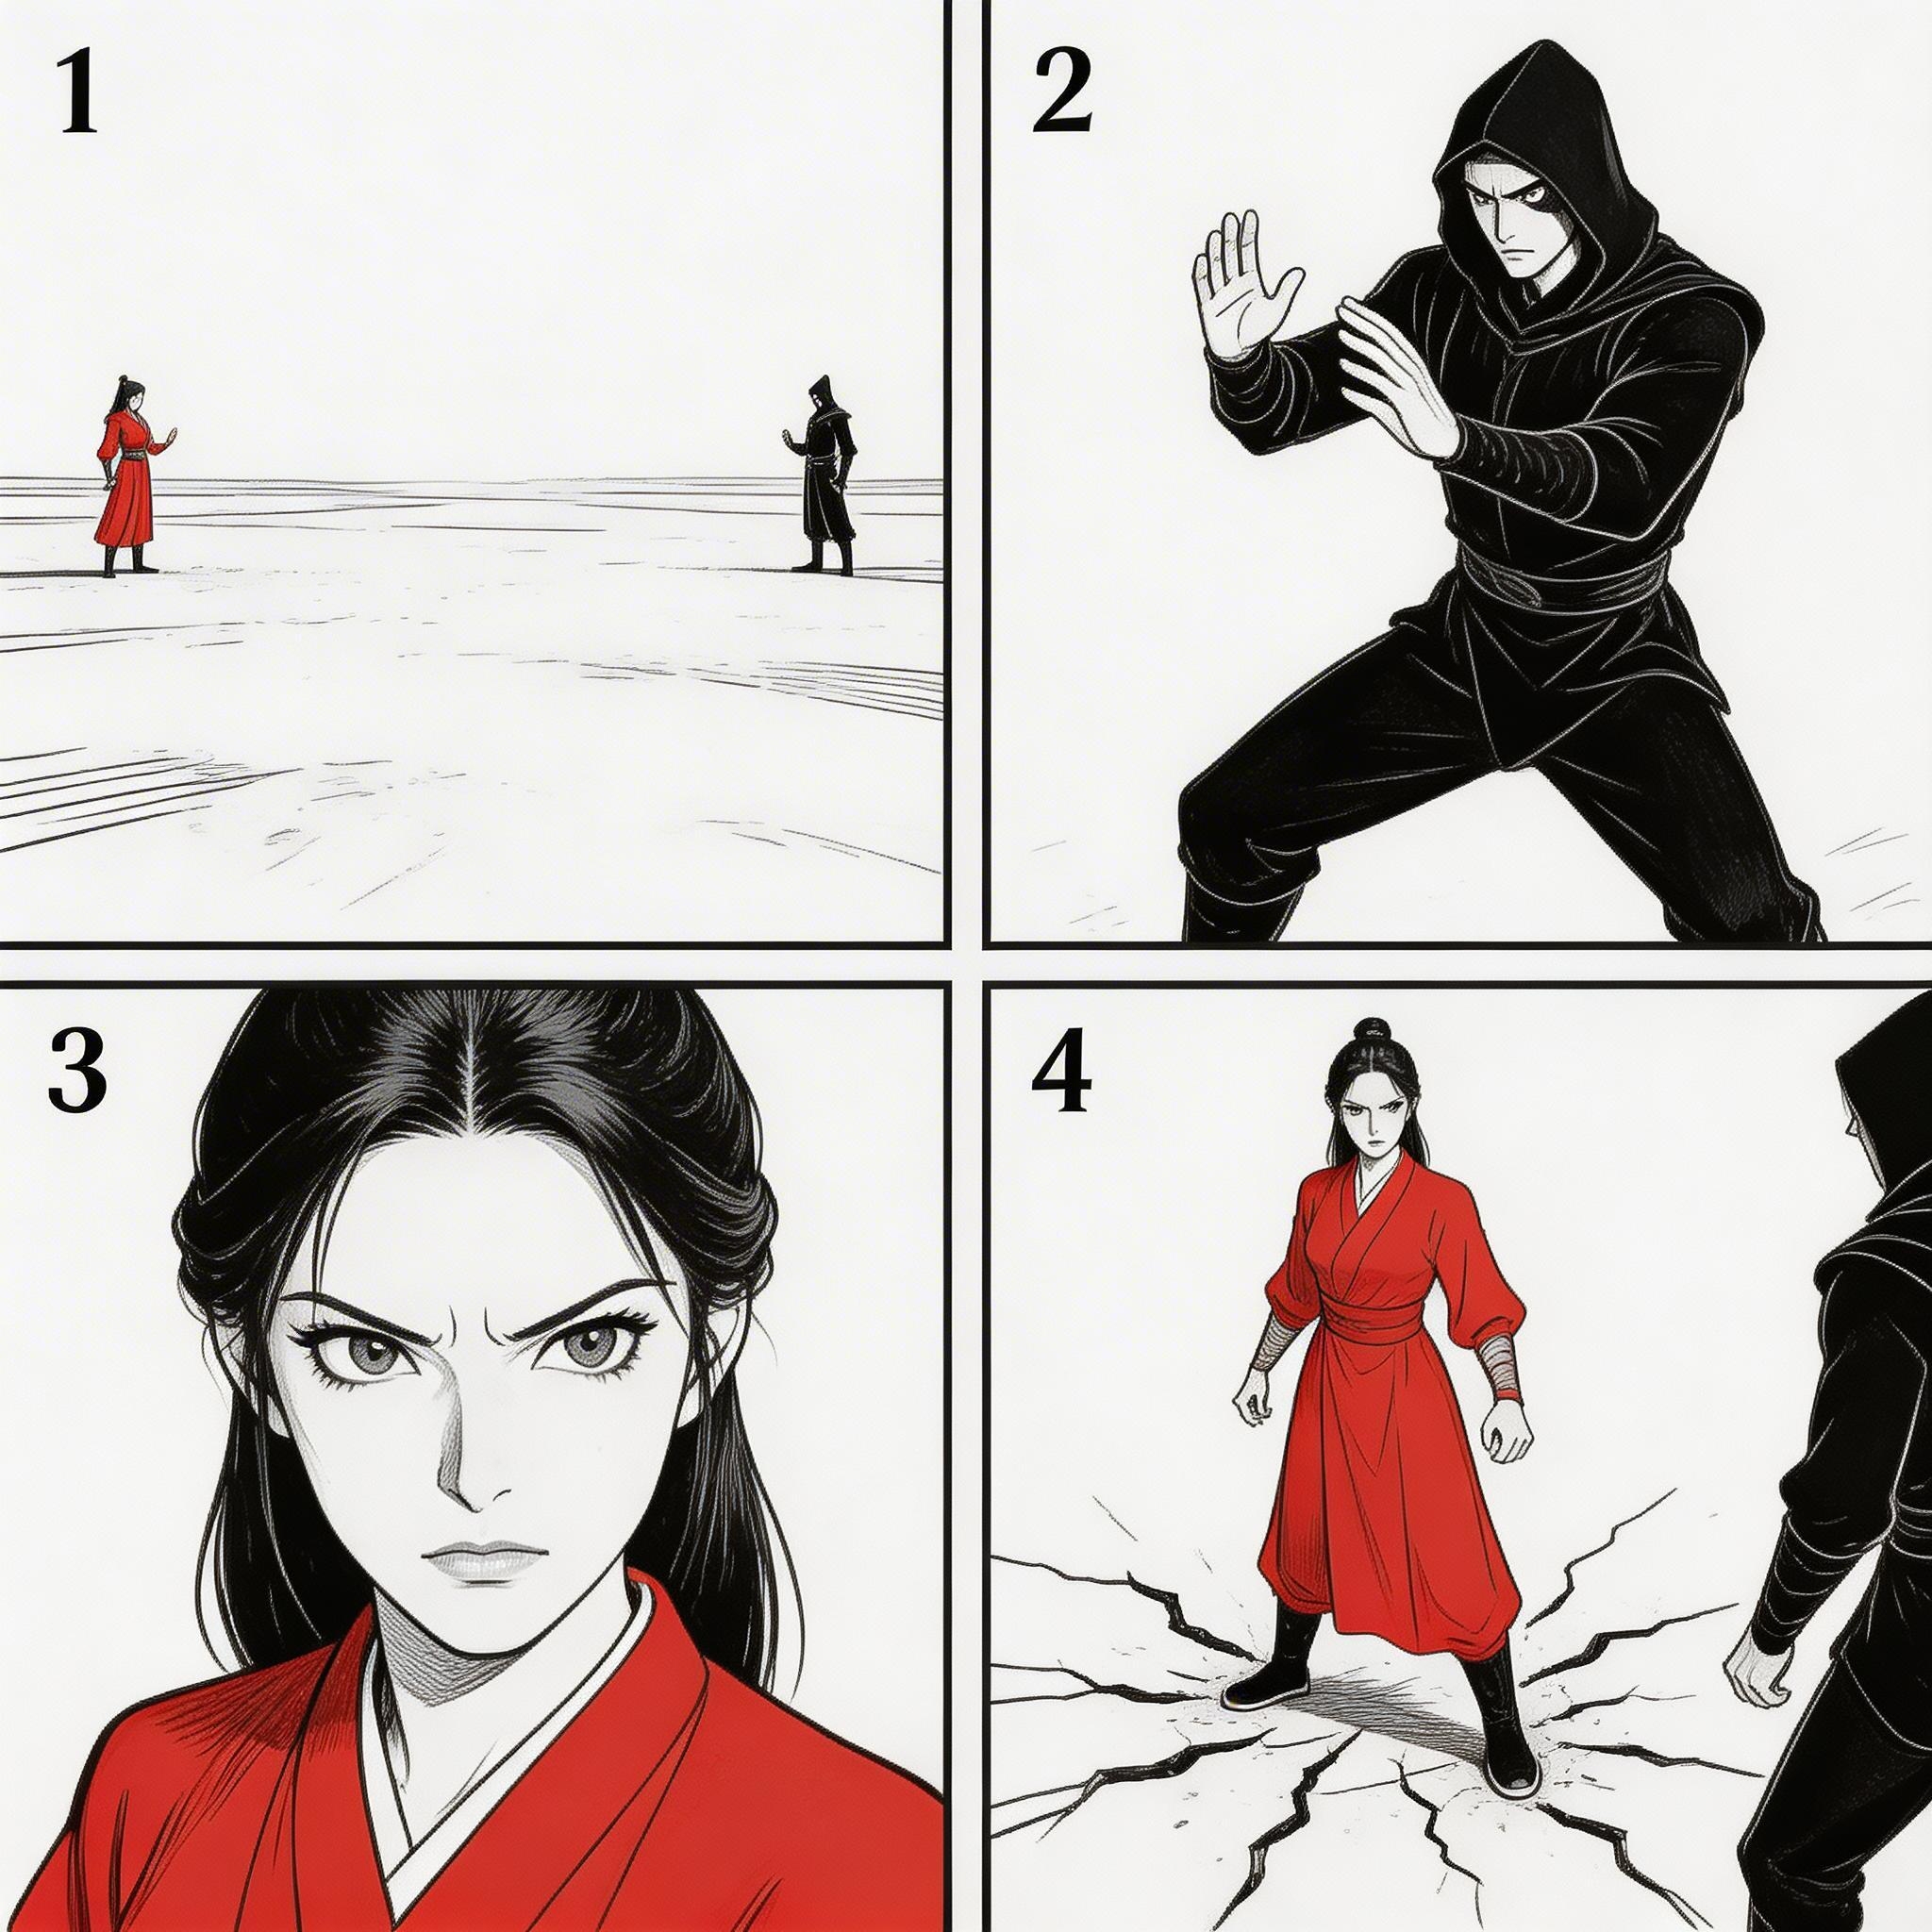
Refer to the sequence in @Image1 to create an intense high-energy fight sequence. All frame compositions from @Image1 shall be presented in strict predefined order, after which the two characters engage in fierce, fast-paced combat.
참조 소재
@Image1
프롬프트
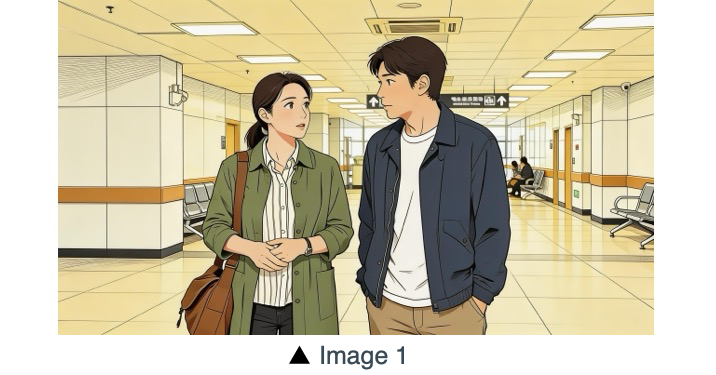
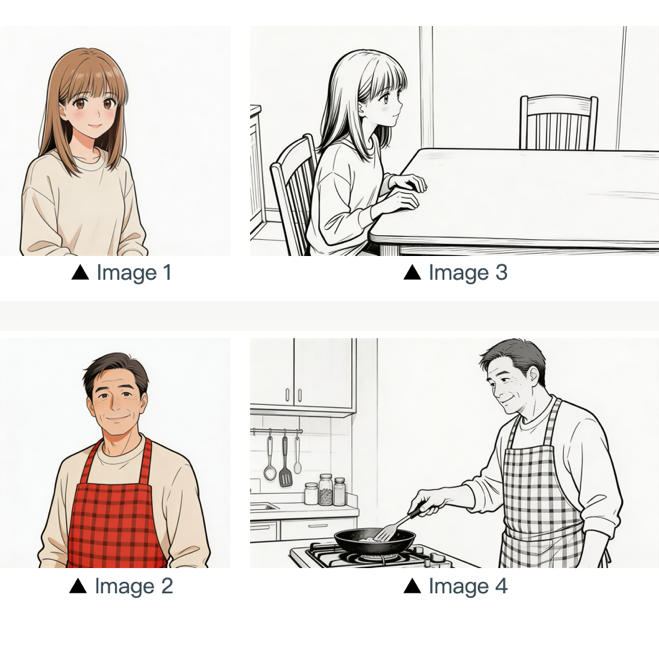
Refer to the composition in Image 3 on @Image1. A girl (her character design refers to Image 1) is waiting for her father to finish cooking, and she says: "아빠, 배고파요! 밥 다 됐어요?" Then the camera pans right and cuts to the frame and composition shown in Image 4. The father (his character design refers to Image 2) replies to her: "거의 다 됐어, 조금만 기다려!" Next, the camera cuts back to a close-up shot of the daughter's slightly disappointed facial expression, and she says: "아직 멀었어요? 맛있는 냄새 나는데..." Then the shot switches to a close-up of the father's face, and he says: "이제 진짜 금방이야. '빨리빨리' 하지 말고 손부터 씻고 와!"
동작 참조
동영상 안의 캐릭터 움직임과 샷 언어를 참조한 다음, 이미지 안의 캐릭터에 적용합니다. 마케팅 예는 동영상 안 말의 달리는 형태를 참조합니다.
참조 소재
@Image1
@Video1
프롬프트
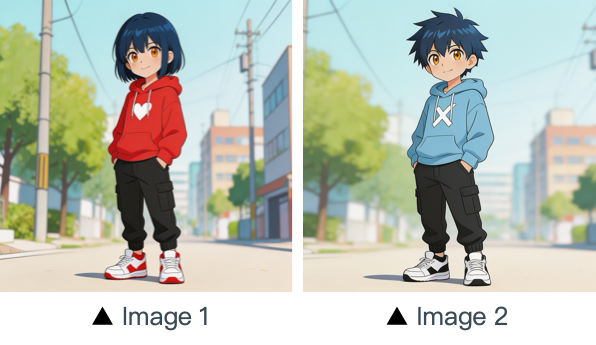
Refer to the character movements and shot language in @Video1 to create a fight scene with the character from Image 2 on @Image1 on the left and the character from Image 1 on @Image1 on the right. Include intense background music.
참조 소재
@Video1
프롬프트
Referencing the running shape of the horse in @Video1, generate a scene: a golden steed runs on the grassland, then freezes its magnificent running posture and turns into a horse-shaped gold pendant.
카메라 움직임 참조
동영상 안의 카메라 움직임을 참조하고, 이미지 안의 새 피사체에 이름을 붙입니다.
참조 소재
@Image1
@Video1
프롬프트
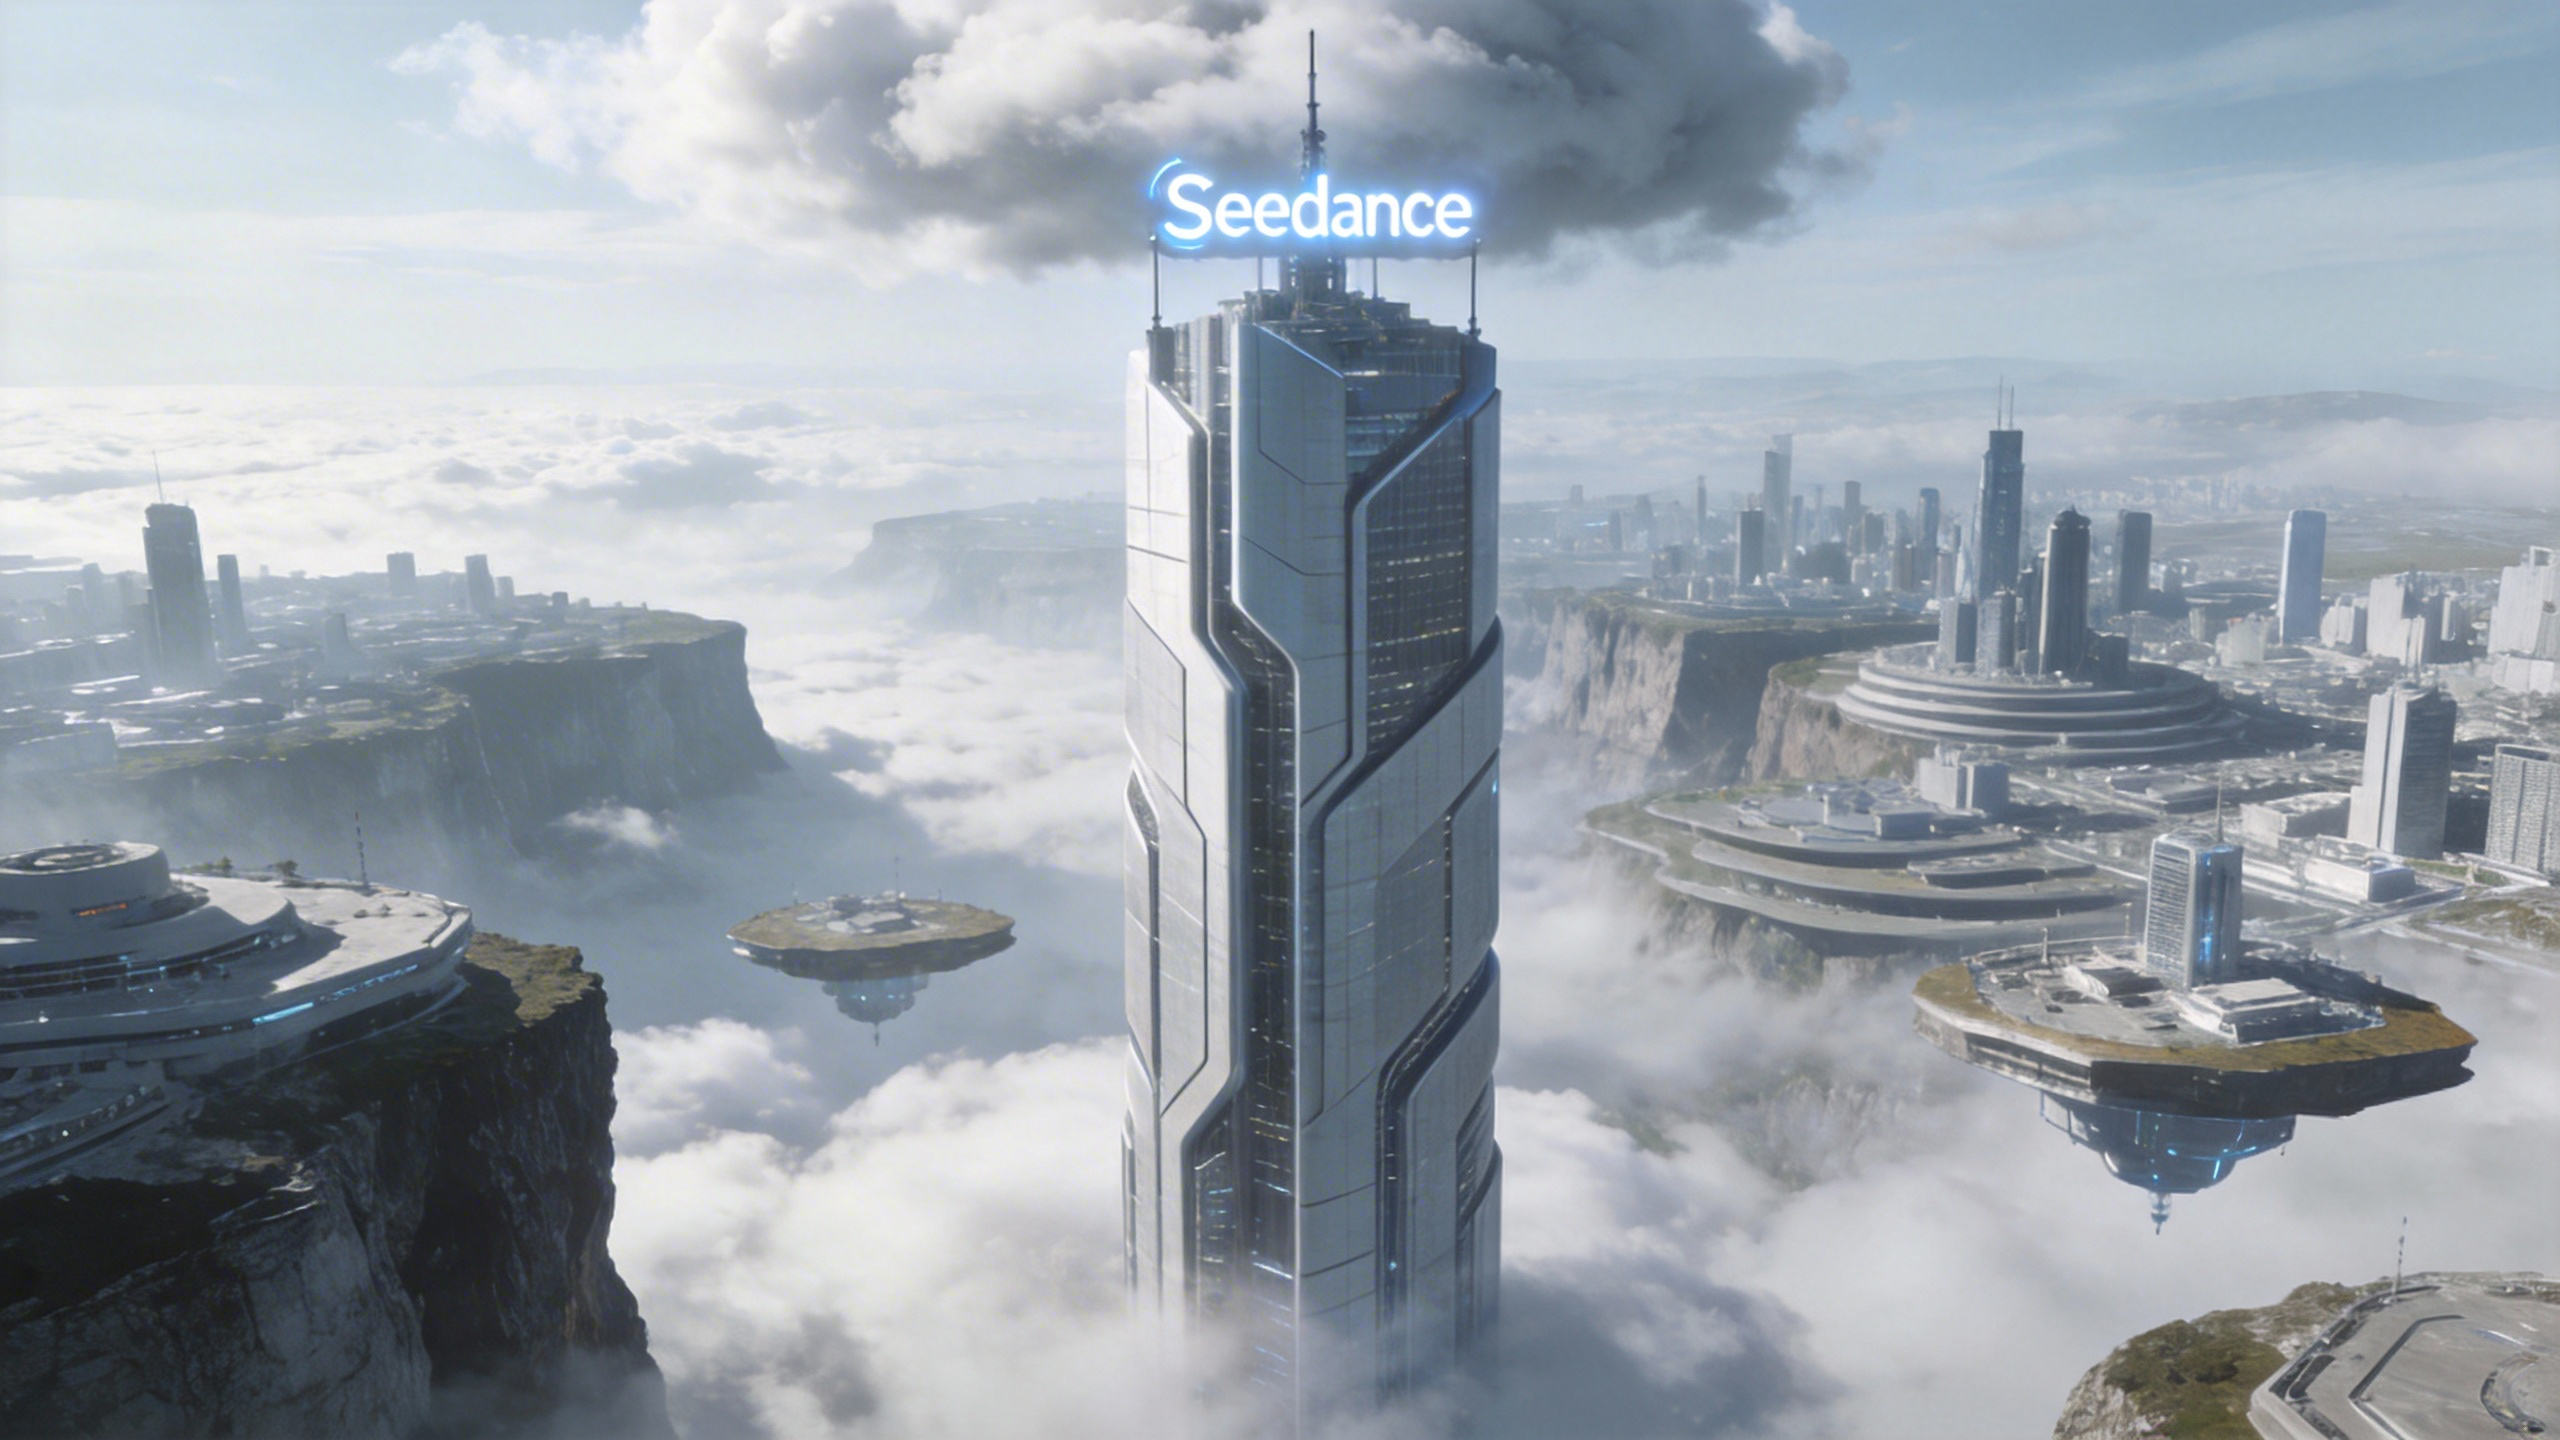
Referring to the camera movement in @Video1, create a concept video for a science and technology park, with the tall building in @Image1 as the visual center, also using a first-person diving perspective, to reflect the sense of technology in the park from @Image1.
특수 효과 참조
동영상 안의 특수 효과를 참조하고, 그 같은 효과, 경로, 순서를 이미지 안의 캐릭터에 적용합니다.
참조 소재
@Image1
@Video1
프롬프트
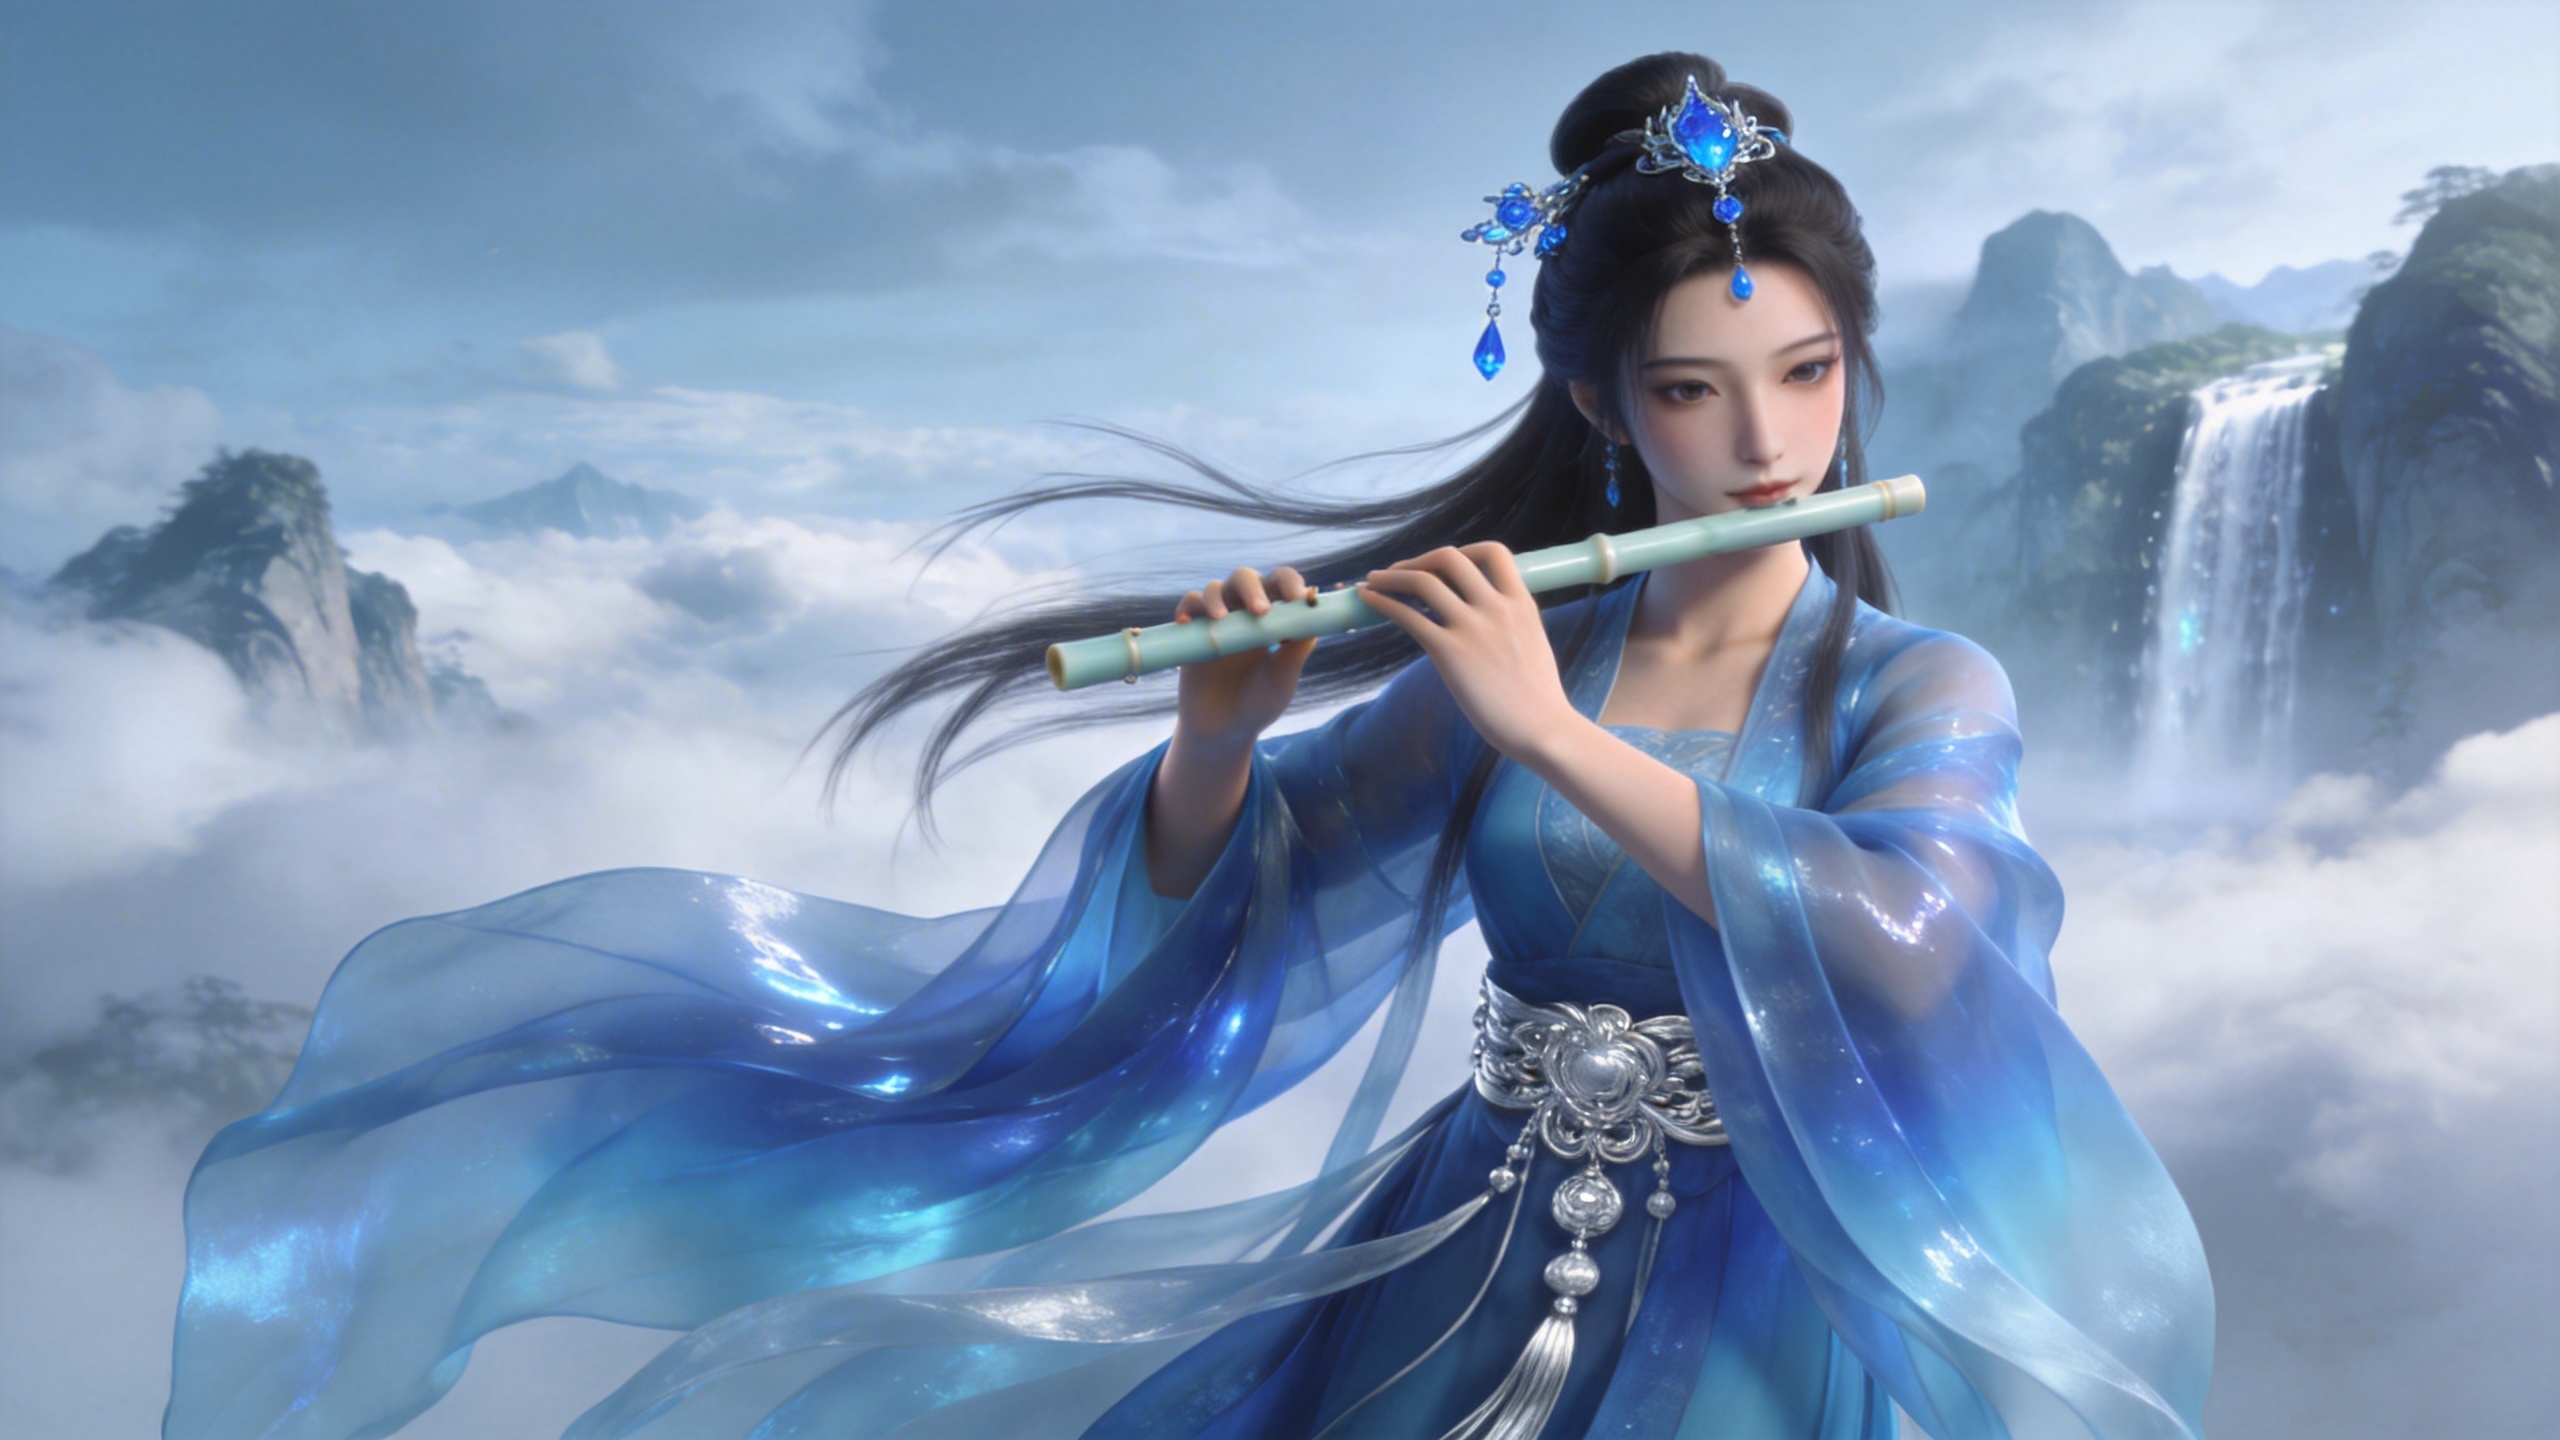
Refer to the golden particle effects in @Video1, so that when the character in @Image1 plays the flute, the same particle effects surround their body.
참조 소재
@Image1
@Video1
프롬프트
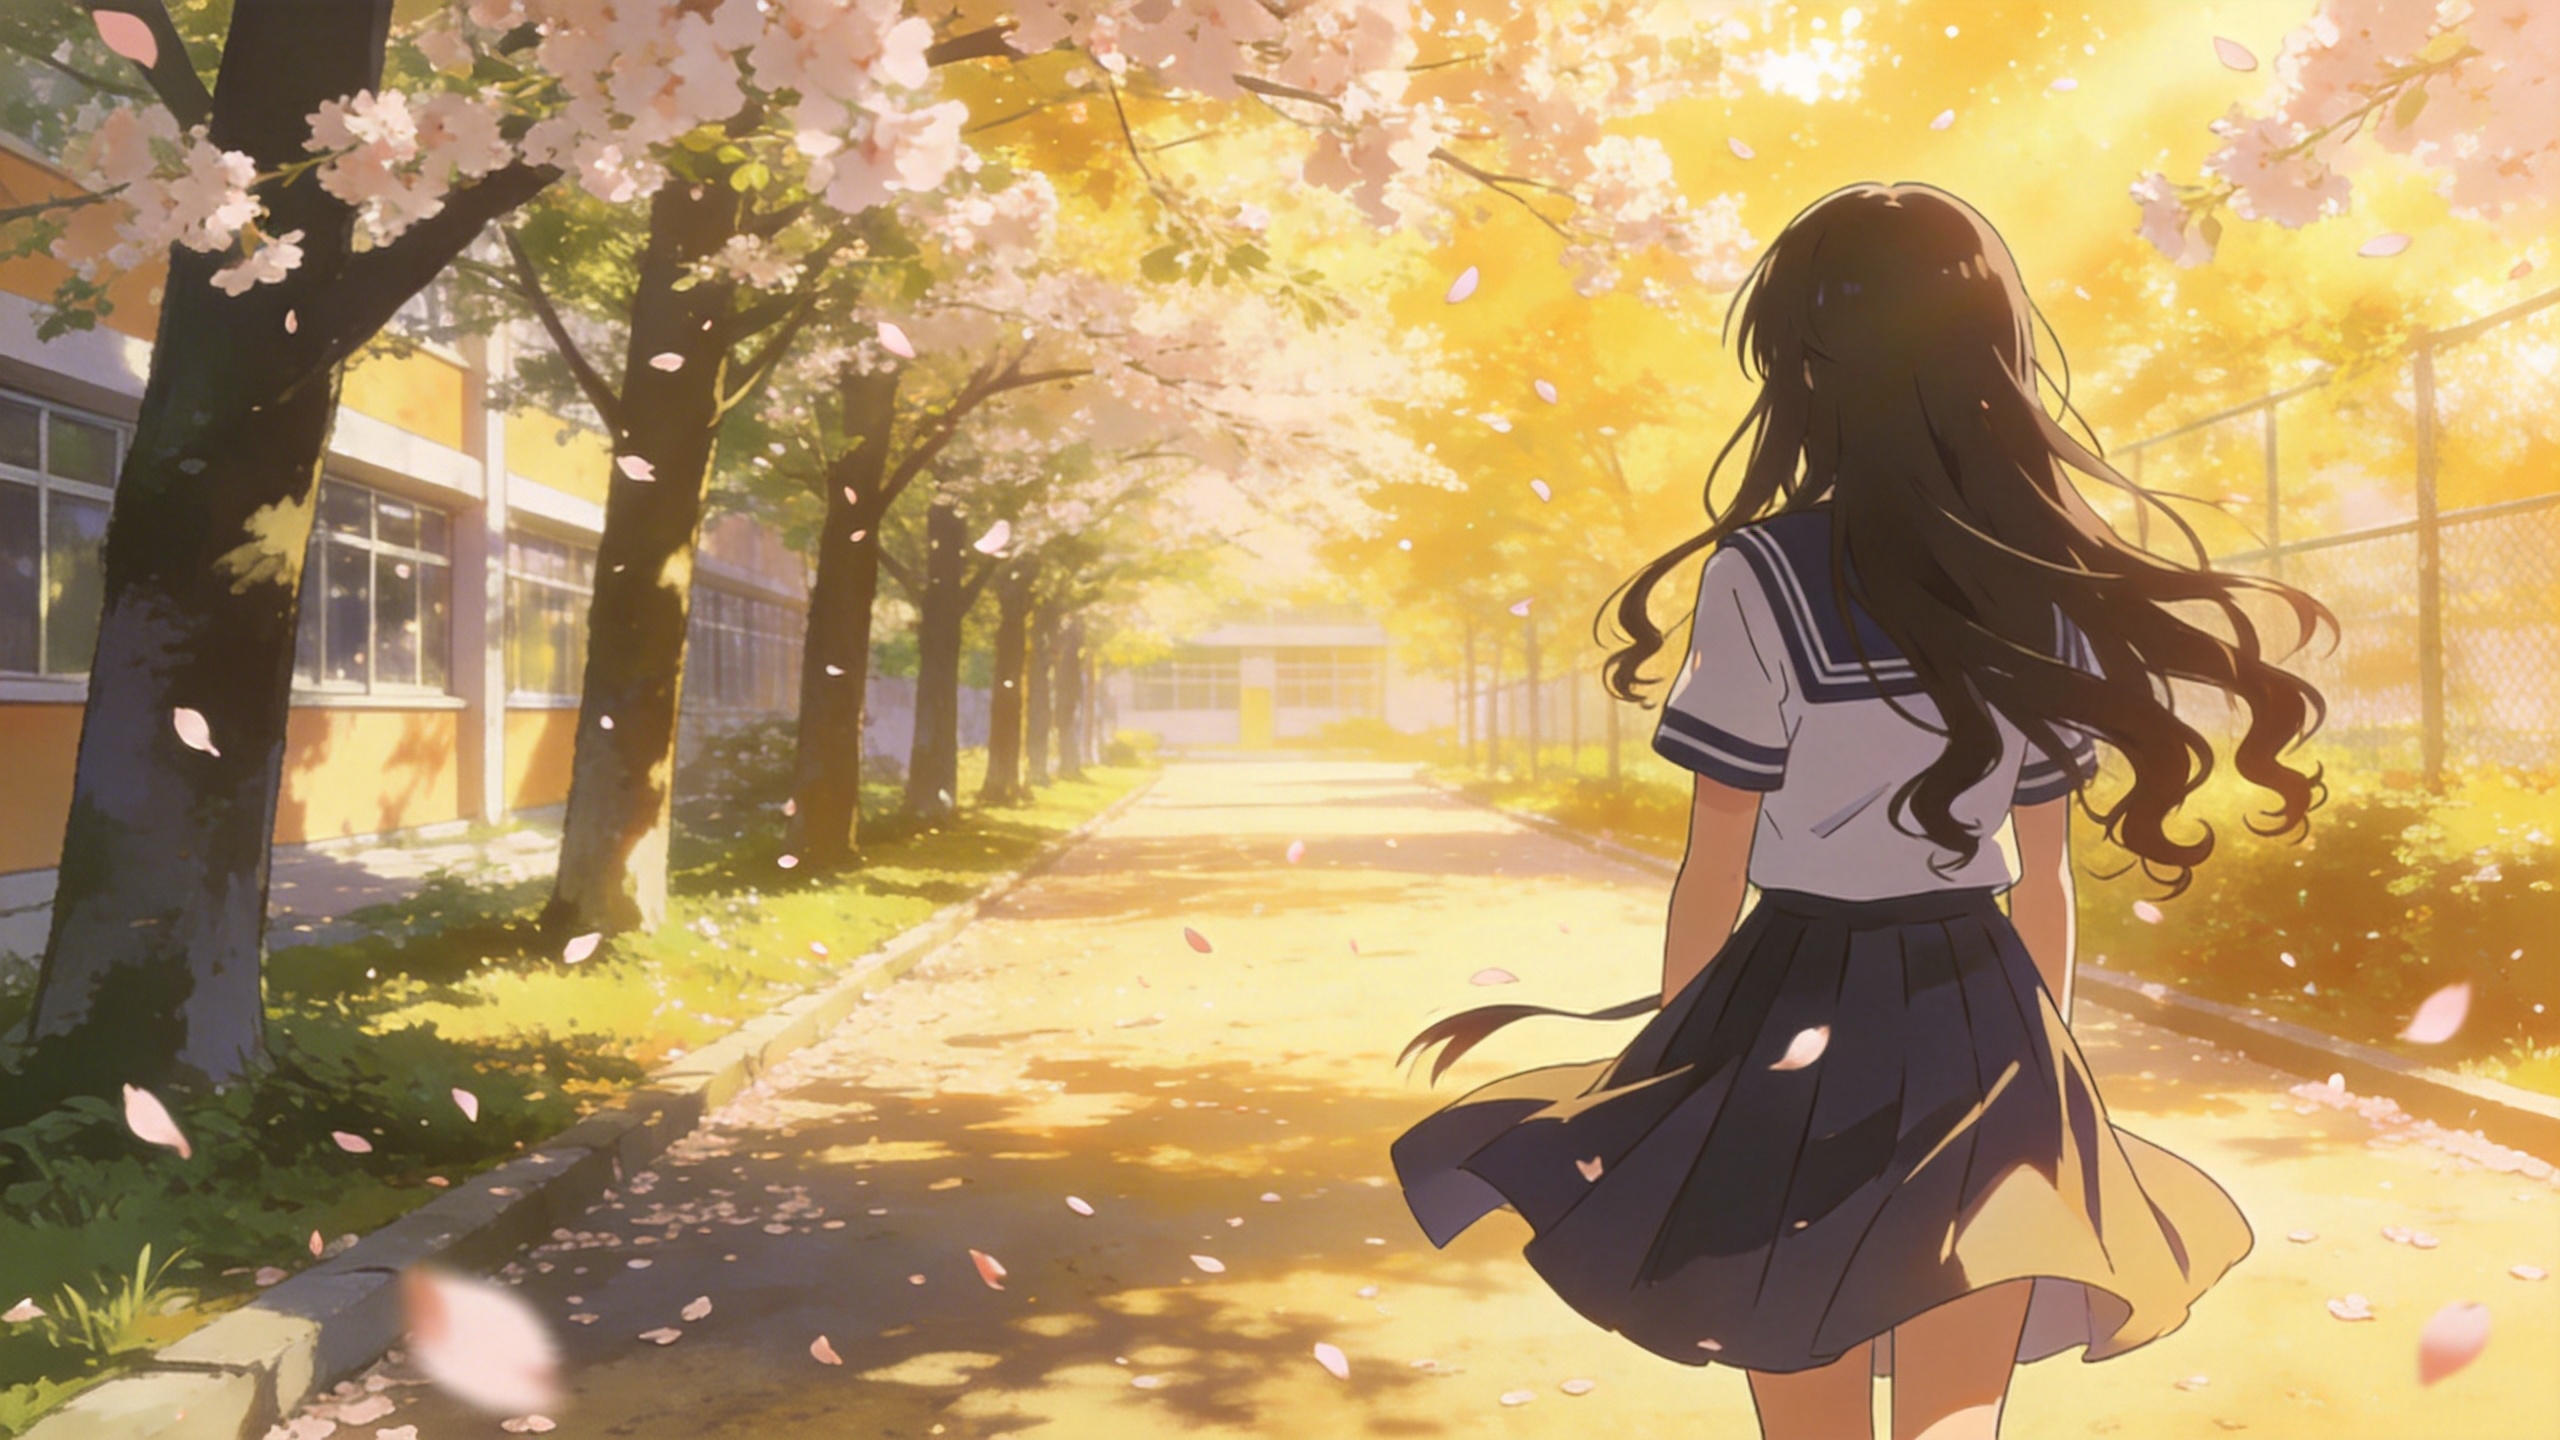
Refer to the special effects shown in @Video1 to generate identical wings for the girl in @Image1, ensuring the wing formation trajectory follows the exact same motion path and sequence depicted in the video.
요소 추가, 제거, 수정
추가, 제거, 또는 교체입니다. 편집에서는 "reference"라고 쓰지 마세요. 언급하지 않은 부분은 그대로 남습니다.
참조 소재
@Video1
프롬프트
Add snacks such as fried chicken and pizza to the countertop in @Video1.
참조 소재
@Video1
프롬프트
Remove everything that isn't office supplies from the table in @Video1, keeping the rest of the video content unchanged.
참조 소재
@Image1
@Video1
프롬프트
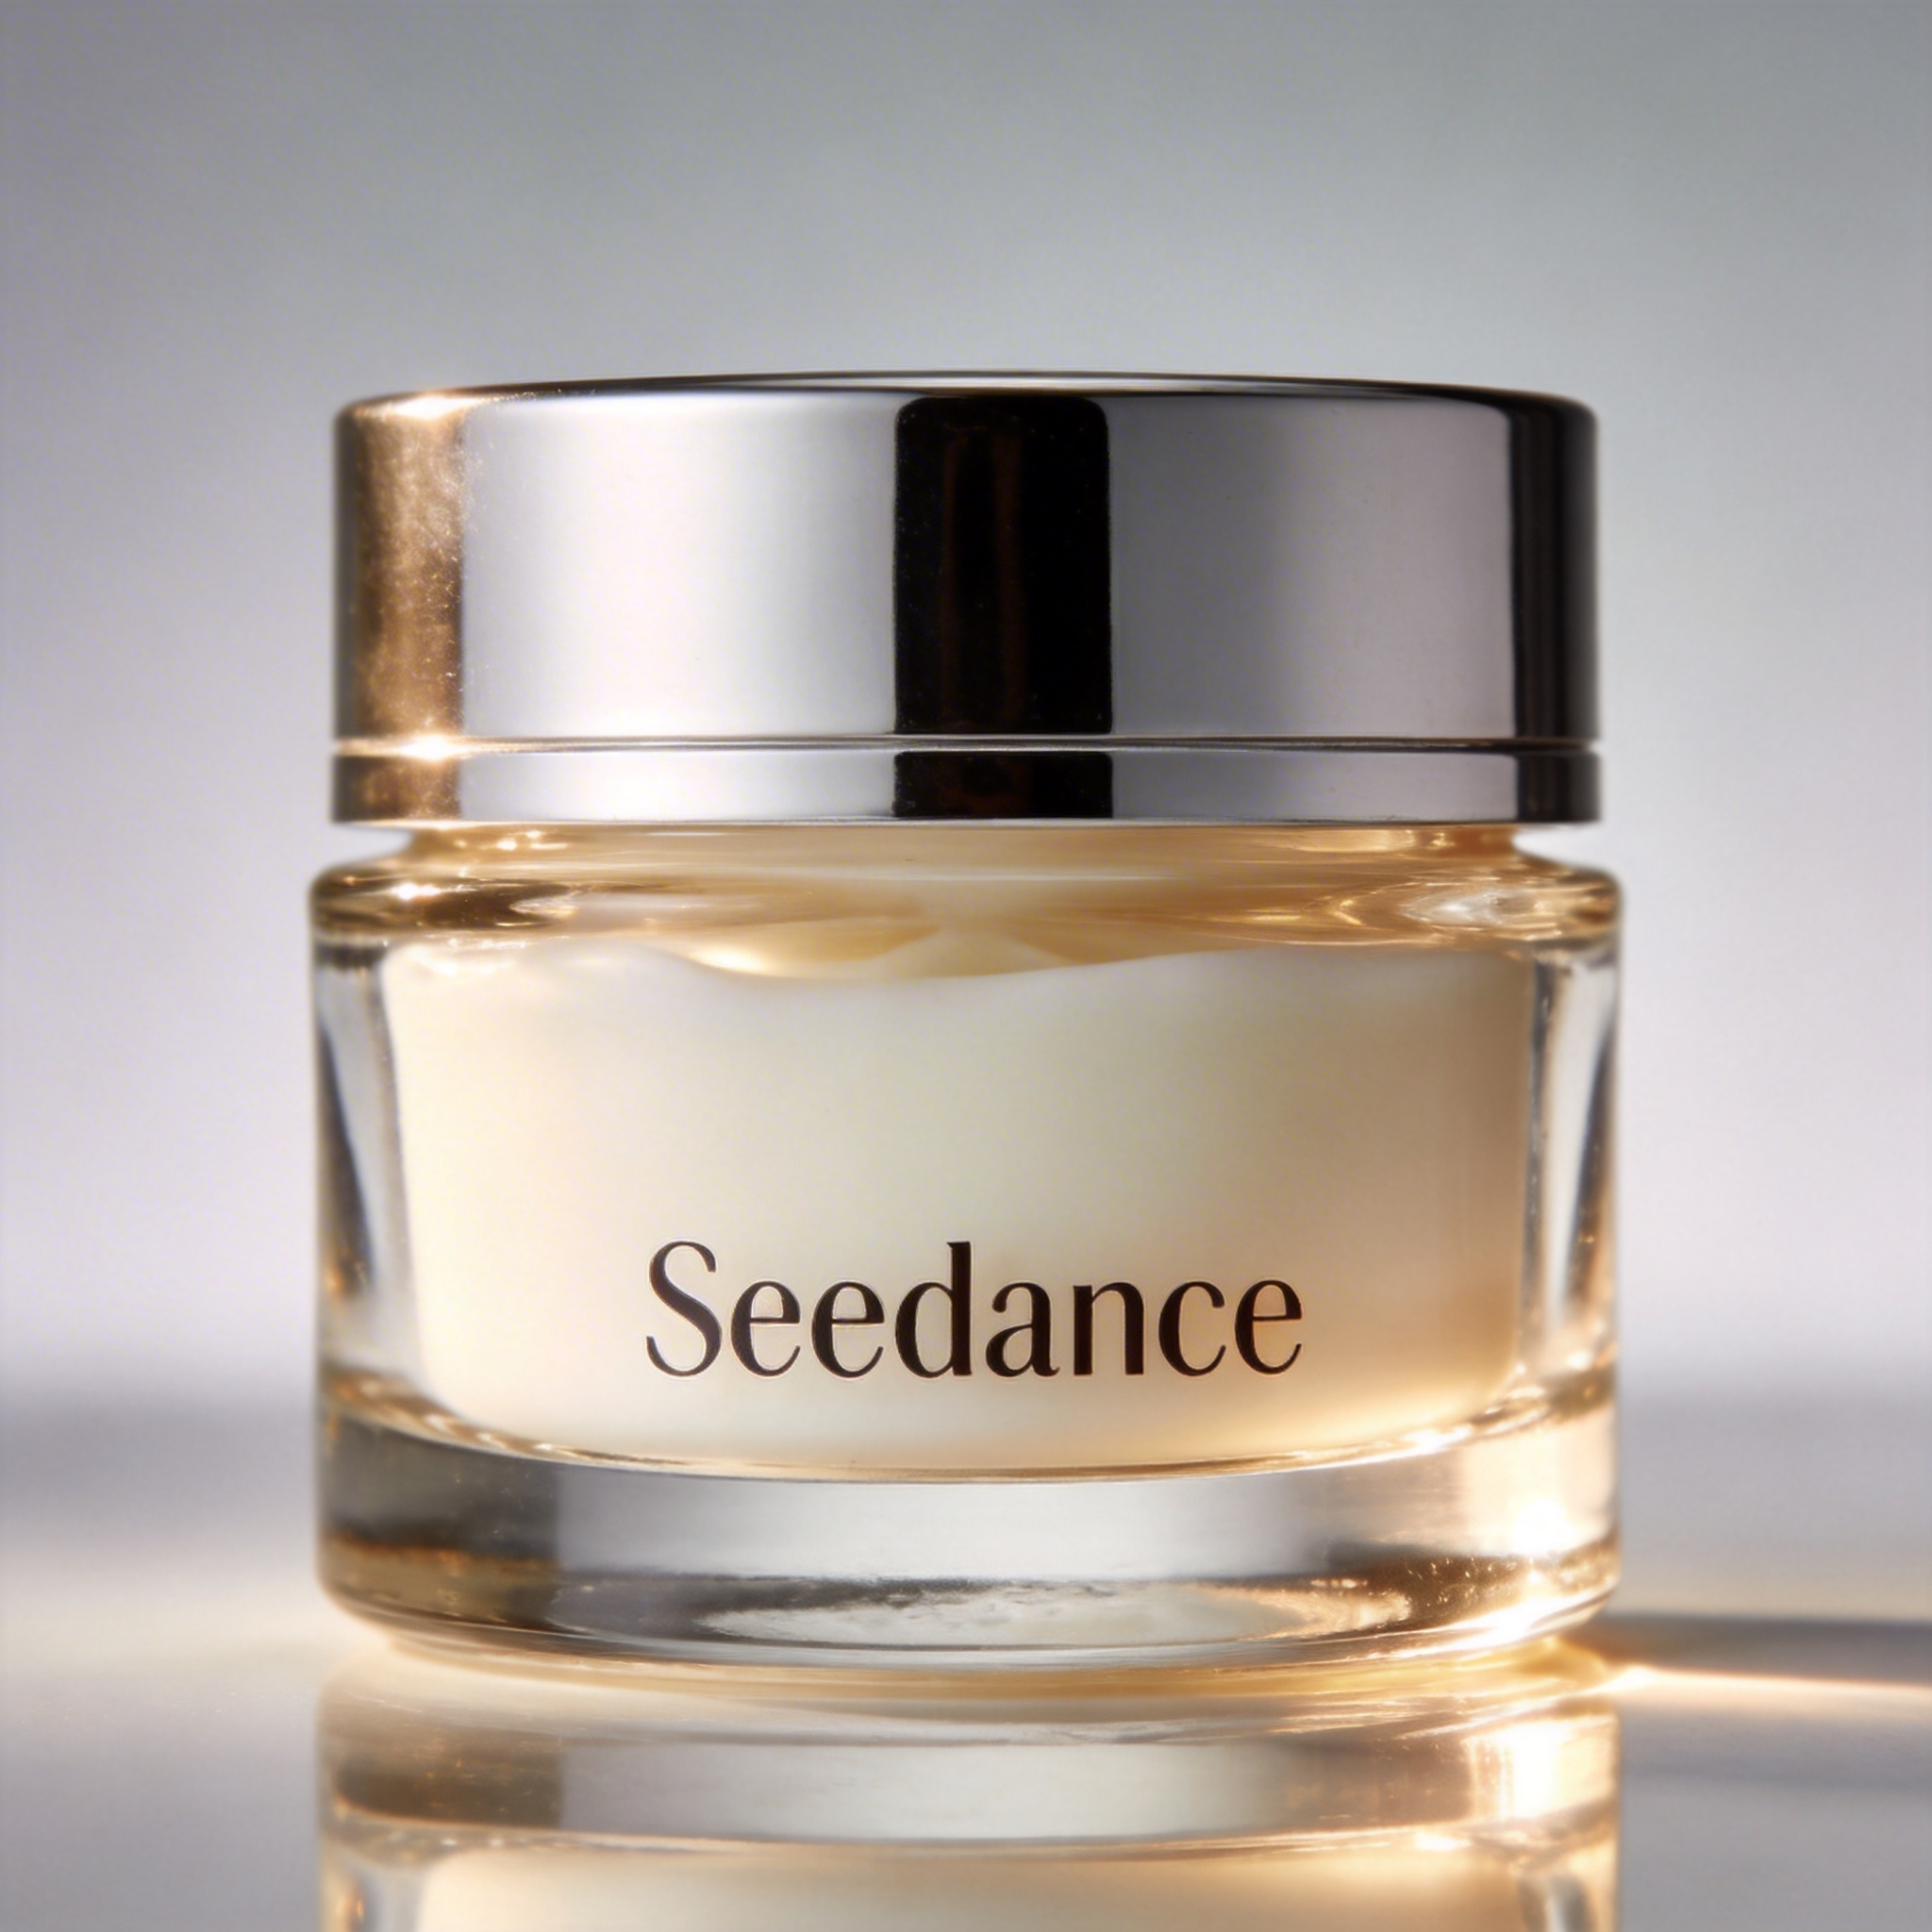
Replace the perfume featured in @Video1 with the face cream from @Image1, with all original motions and camera work preserved.
동영상 연장
앞으로의 연장은 동영상 뒤의 내용을 생성합니다. 뒤로의 연장은 동영상 도입 구간을 연장합니다.
참조 소재
@Video1
프롬프트
Generate the content after @Video1: the two men who are late run towards them, the five people finally meet and have a friendly chat.
참조 소재
@Video1
프롬프트
Extend the opening segment of @Video1: Set up an over-the-shoulder shot of the man in a hoodie, and the man says: "It's not that bad. You're just stressed. Everyone goes through this, you just need to keep going."
트랙 완성
@Video1, 그다음 다리, 이어서 @Video2.
참조 소재
@Video1
@Video2
프롬프트
@Video1. The moment a leaf falls to the ground, it sets off a special effect of golden particles. A gust of wind blows by, leading into @Video2.
한눈에 보는 한계
| Seedance 2.0 제품군 | |
|---|---|
| 참조 이미지 | 최대 9 |
| 참조 동영상 | 최대 3, 각 2–15초, 합계 15초 |
| 참조 오디오 | 최대 3, 각 2–15초, 합계 15초 |
| 출력 길이 | 4–15초 |
| 출력 해상도 | 2.0: 480p–4K. Fast와 Mini: 480p / 720p |
참조 동영상은 480p 또는 720p, 24–60 fps여야 합니다.